
容器与云原生 / 系统课时
排查 Multi-Attach 冲突
排查 Multi-Attach 冲突
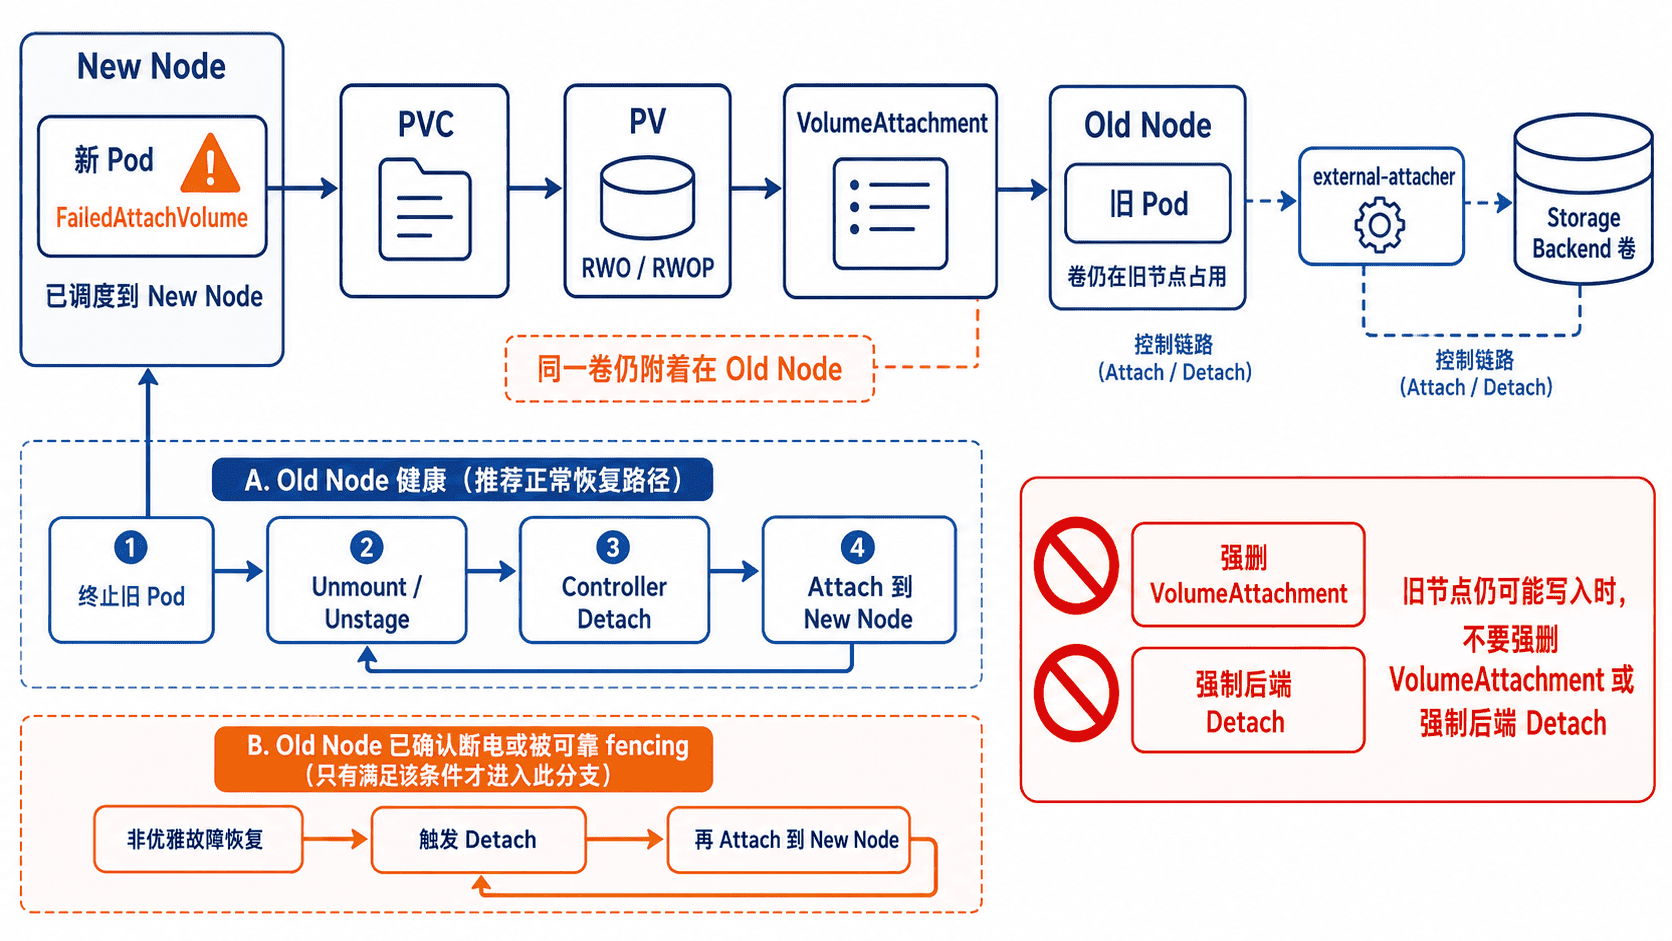
Multi-Attach 的核心不是“挂载慢”,而是同一个卷仍被旧节点占用,而新 Pod 已被调度到另一节点。排障时要把 Pod、PVC/PV、VolumeAttachment、旧节点和后端卷串成证据链,再决定等待正常 Detach,还是在确认旧节点已失去写入能力后执行故障恢复。
学习目标
- 从
FailedAttachVolume事件定位冲突卷、旧节点与新节点 - 区分重复 Pod、旧节点残留附着和访问模式设计错误
- 按“停止旧写入 → Detach → 新节点 Attach → 挂载验证”的顺序安全恢复
先证明卷到底被谁占用
典型现象是新 Pod 长时间停在 ContainerCreating,事件中出现 FailedAttachVolume 或 Multi-Attach。不要只盯着新 Pod;真正需要确认的是 PVC 绑定到哪个 PV、该 PV 当前是否仍有指向旧节点的 VolumeAttachment,以及旧 Pod 是否还可能运行。
ReadWriteOnce 表示卷可由单个节点读写,并不等于整个集群只能有一个 Pod;同一节点上的多个 Pod 仍可能使用它。若业务要求任何时刻全集群只能有一个 Pod 读写该 PVC,应评估 CSI 驱动对 ReadWriteOncePod 的支持。因此看到 RWO 时要继续核对节点归属,不能直接把“两个 Pod”判成访问模式违规。
下面用一组只读命令建立证据链。Kubernetes 的标准附着资源是 VolumeAttachment,命令应使用 volumeattachment 或完整资源名 volumeattachments.storage.k8s.io:
NS='<NAMESPACE>'
POD='<NEW_POD>'
PVC='<PVC>'

kubectl -n "$NS" get pod "$POD" -o wide
kubectl -n "$NS" describe pod "$POD"
PV=$(kubectl -n "$NS" get pvc "$PVC" -o jsonpath='{.spec.volumeName}')
kubectl -n "$NS" get pvc "$PVC" -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,VOLUME:.spec.volumeName,ACCESS:.spec.accessModes
kubectl get pv "$PV" -o custom-columns=NAME:.metadata.name,ACCESS:.spec.accessModes,DRIVER:.spec.csi.driver,HANDLE:.spec.csi.volumeHandle
kubectl get volumeattachments.storage.k8s.io -o custom-columns=NAME:.metadata.name,PV:.spec.source.persistentVolumeName,NODE:.spec.nodeName,ATTACHED:.status.attached
预期输出会呈现类似关系,实际名称、时间和 ID 会不同:
NAME        READY   STATUS              NODE
<NEW_POD>   0/1     ContainerCreating   <NEW_NODE>

Warning  FailedAttachVolume  <TIME>  Multi-Attach error for volume "<PV>"

NAME    STATUS   VOLUME   ACCESS
<PVC>   Bound    <PV>     [ReadWriteOnce]

NAME   ACCESS            DRIVER         HANDLE
<PV>   [ReadWriteOnce]   <CSI_DRIVER>   <ID>

NAME                 PV     NODE         ATTACHED
<VOLUMEATTACHMENT>   <PV>   <OLD_NODE>   true
如果匹配该 PV 的 VolumeAttachment 仍指向 <OLD_NODE>,而新 Pod 已在 <NEW_NODE>,冲突链条基本成立。若没有匹配对象,还要检查 CSIDriver.spec.attachRequired 和存储后端自己的 attachment 状态;某些驱动不使用 Controller Attach,不能只凭 VolumeAttachment 缺失断言卷已经释放。
按根因选择 Detach 路径
最常见的根因是两个工作负载实例在不同节点争用同一个独占卷。例如 Deployment 扩容、旧 Pod 还在 Terminating,新 Pod 已被调度到另一节点。此时先消除多余实例;只要旧节点健康,就应让 kubelet 正常卸载,并由控制面和 CSI 驱动完成 Detach。
另一类情况是旧节点已经故障,但 Kubernetes 仍保留旧附着状态。必须先判断节点是真的停机,还是仅与控制面失联。网络分区最危险:API Server 看不到节点,并不代表旧 Pod 已停止写盘。只有确认机器已经关机,或已通过云平台、电源管理、存储侧 fencing 等手段保证旧节点无法继续访问卷,才可以推进强制恢复。
如果怀疑 CSI 或后端状态不一致,应检查相关 VolumeAttachment 的 status.detachError、CSI controller 与 external-attacher 日志,以及后端卷的实际附着状态。不要把手工删除 VolumeAttachment 当成通用修复;如果旧节点仍在写入,绕过保护可能造成双写或文件系统损坏。
旧节点失联时再使用故障恢复
若旧节点已经确认关机或被可靠 fencing,可使用 Kubernetes 的 out-of-service 机制处理非优雅节点关机。该污点会推动相关 Pod 清理和卷 Detach,因此它是故障恢复手段,不是普通 Multi-Attach 的快捷键。
OLD_NODE='<OLD_NODE>'

kubectl taint nodes "$OLD_NODE" node.kubernetes.io/out-of-service=storage-recovery:NoExecute
kubectl get node "$OLD_NODE" -o custom-columns=NAME:.metadata.name,TAINTS:.spec.taints
预期输出:
node/<OLD_NODE> tainted
NAME         TAINTS
<OLD_NODE>   [map[effect:NoExecute key:node.kubernetes.io/out-of-service value:storage-recovery]]
实际 TAINTS 展示格式可能因客户端版本而不同。添加污点后继续观察旧 Pod 是否被清理、旧 VolumeAttachment 是否消失或完成 Detach,以及新节点是否出现新的附着对象。恢复尚未完成前不要急于移除污点。
验证新节点已经接管卷
恢复完成的判据不是“报错少了”,而是新 Pod、Kubernetes 附着对象和后端卷三方一致:旧节点不再使用该卷,新节点成为唯一有效写入方,新 Pod 成功启动。
NS='<NAMESPACE>'
POD='<NEW_POD>'
PV='<PV>'

kubectl -n "$NS" get pod "$POD" -o wide
kubectl get volumeattachments.storage.k8s.io -o custom-columns=PV:.spec.source.persistentVolumeName,NODE:.spec.nodeName,ATTACHED:.status.attached
kubectl get pv "$PV" -o custom-columns=NAME:.metadata.name,CLAIM:.spec.claimRef.name,ACCESS:.spec.accessModes
预期结果:
NAME        READY   STATUS    NODE
<NEW_POD>   1/1     Running   <NEW_NODE>

PV     NODE         ATTACHED
<PV>   <NEW_NODE>   true

NAME   CLAIM   ACCESS
<PV>   <PVC>   [ReadWriteOnce]
若业务确实需要跨节点同时读写,应选择后端能力和 CSI 驱动均支持的 ReadWriteMany 方案;若业务只允许一个 Pod 使用卷,则优先从控制器副本数、Pod 调度和 ReadWriteOncePod 约束上消除争用,而不是依赖 Multi-Attach 报错充当并发控制。