
容器与云原生 / 系统课时
为 CSI 建立日志与指标基线
为 CSI 建立日志与指标基线
CSI 故障会跨越 Controller、Node、sidecar、kubelet 与存储后端。本课建立一套可重复采集的健康基线,把日志、事件、操作时延、错误和容量指标串成同一条证据链,让后续异常能够直接与正常状态比较。
学习目标
- 明确 CSI 控制面、节点面、kubelet 与后端应保留的关键日志
- 建立 Provision、Attach、Mount 和容量指标的统一基线口径
- 用可重复命令验证组件日志、事件和 kubelet 存储指标是否可查询
把观测对象串成证据链
卷从 PVC 申请到容器可用,会经过 Kubernetes 对象、CSI Controller 与 sidecar、CSI Node、kubelet 和存储后端。单看某个容器日志只能说明“这一层看到了什么”,不能证明请求已经到达下一层,因此基线必须覆盖整条链路。
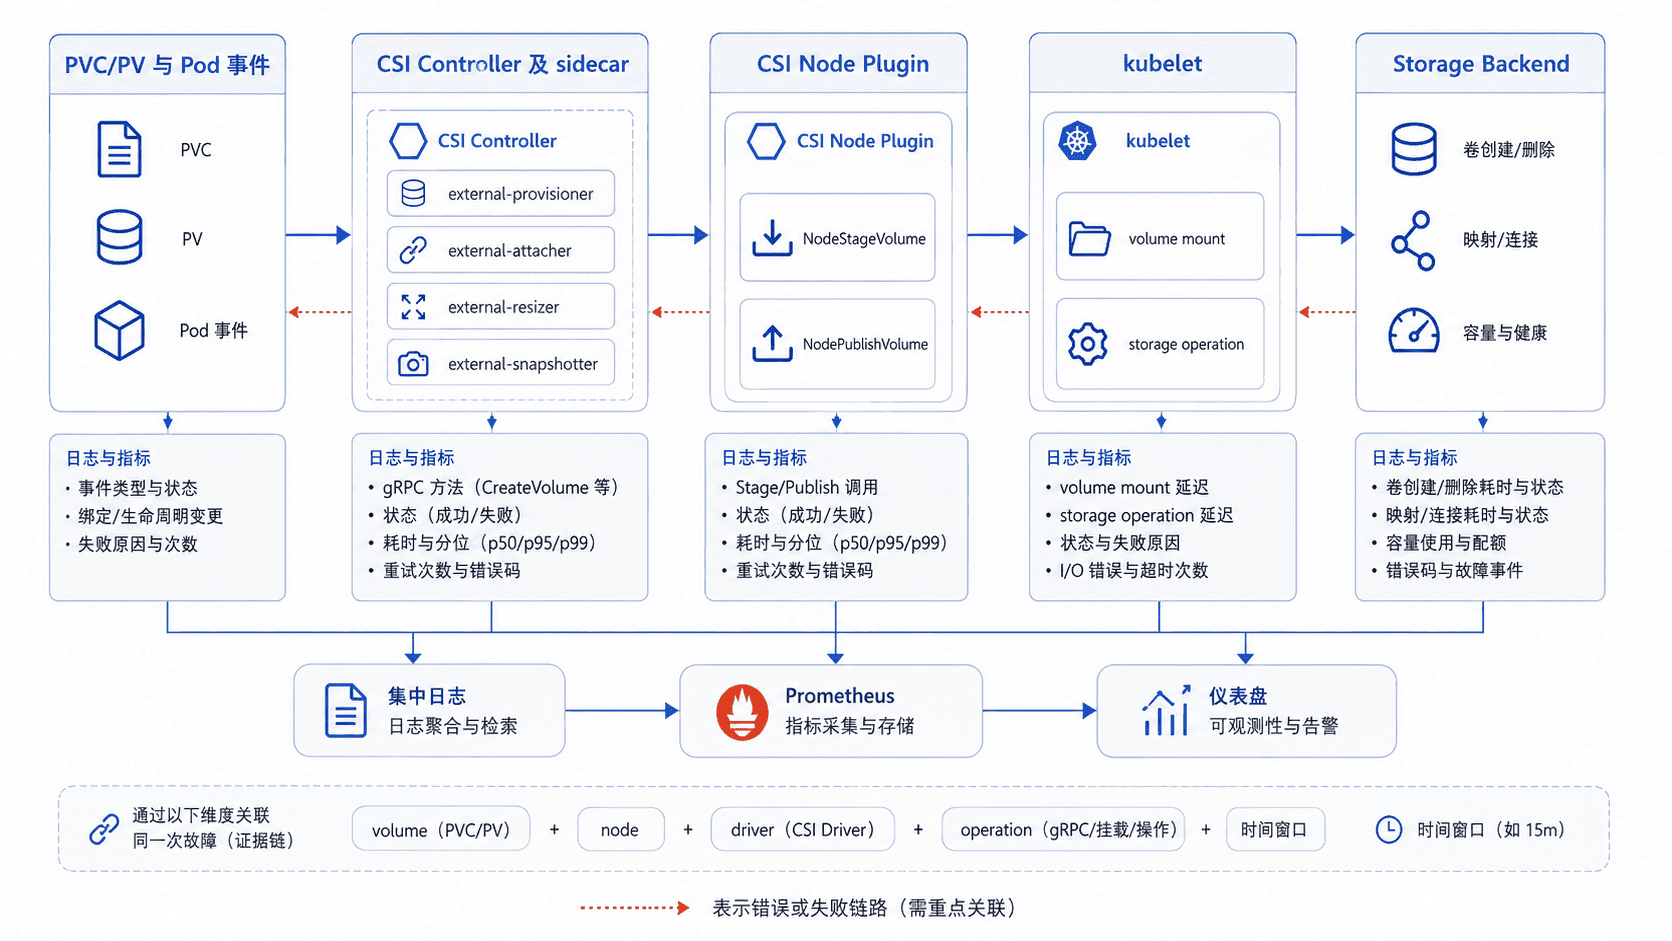
日志与指标至少保留四类关联维度:对象,如 PVC、PV、volumeHandle;位置,如 cluster、namespace、node;组件,如 driver、container;结果,如 operation、status、duration。驱动没有统一 request ID 时,可以用 volumeHandle、node 和相同时间窗口做次优关联。
固定日志字段与采集窗口
Controller 侧重点是卷创建、删除与控制面发布;Node 侧重点是 Stage、Unstage、Publish、Unpublish;kubelet 用于补充 Pod、节点和挂载阶段信息;后端日志则用于确认请求是否真正到达存储系统。健康时期也应保存样本,否则故障时只有异常值而没有比较基准。
下面的主示例同时采集指定 CSI 容器最近 15 分钟日志、近期存储事件,以及目标节点上的 CSI 操作时延和卷容量指标。日志部分可分别对 Controller Pod 与 Node Pod 执行,以覆盖控制面和节点面。
NS="kube-system"
POD="<CSI_POD>"
CONTAINER="<CONTAINER>"
NODE="<NODE_WITH_MOUNTED_PVC>"

echo "== CSI logs =="
kubectl -n "$NS" logs "$POD" -c "$CONTAINER" --since=15m --timestamps | tail -n 80

echo "== Volume events =="
kubectl get events -A --sort-by=.metadata.creationTimestamp \
  | grep -Ei 'Provision|Attach|Mount|Volume' \
  | tail -n 30

echo "== Kubelet CSI metrics =="
kubectl get --raw "/api/v1/nodes/${NODE}/proxy/metrics" \
  | grep -E '^(# (HELP|TYPE) csi_operations_seconds|csi_operations_seconds_(bucket|sum|count))' \
  | head -n 12

echo "== Kubelet volume stats =="
kubectl get --raw "/api/v1/nodes/${NODE}/proxy/metrics" \
  | grep -E '^kubelet_volume_stats_' \
  | head -n 12
预期输出
== CSI logs ==
<TIME> <CSI_COMPONENT_LOG_LINE>
== Volume events ==
<NAMESPACE> <TIME> <TYPE> <REASON> <OBJECT> <MESSAGE>
== Kubelet CSI metrics ==
# HELP csi_operations_seconds <HELP_TEXT>
# TYPE csi_operations_seconds histogram
csi_operations_seconds_bucket{<LABELS>} <VALUE>
csi_operations_seconds_sum{<LABELS>} <VALUE>
csi_operations_seconds_count{<LABELS>} <VALUE>
== Kubelet volume stats ==
kubelet_volume_stats_capacity_bytes{<LABELS>} <VALUE>
kubelet_volume_stats_available_bytes{<LABELS>} <VALUE>
kubelet_volume_stats_used_bytes{<LABELS>} <VALUE>
实际日志字段、事件和指标样本取决于驱动、节点上是否存在已挂载 PVC 以及集群配置。查询为空时,先检查 Pod、容器、节点名称以及调用者访问 nodes/proxy 的权限,不要把“没有样本”误判为“存储正常”。
建立延迟、错误与容量口径
每类操作至少保留请求量、失败量或错误率,以及可计算 P50、P95、P99 的耗时分布;文件系统卷还应关注已用空间、可用空间、总容量与 inode。Provision 与 Attach 通常需要结合 controller sidecar、CSI Controller 或后端暴露的指标和日志建立基线,而 kubelet 的 csi_operations_seconds 反映节点侧 CSI gRPC 操作时延,kubelet_volume_stats_* 用于卷容量与 inode 统计。
| 观测面 | 基线指标 | 主要用途 |
|---|---|---|
| Provision | 请求数、错误数、P50/P95/P99 | 发现供应变慢、配额或后端创建失败 |
| Attach | 请求数、错误率、P50/P95/P99 | 区分控制面发布问题与节点挂载问题 |
| Mount | 成功率、错误率、P50/P95/P99 | 发现 NodeStage/NodePublish、设备或文件系统异常 |
| Capacity | used/available/capacity、inode | 提前发现空间或 inode 耗尽 |
| Backend | API 延迟、错误率、池容量 | 判断问题是否越过 Kubernetes 边界 |
不同 CSI sidecar、驱动和 Kubernetes 版本暴露的原始指标名与标签可能不同,因此生产环境更适合通过 recording rules 统一名称和标签,再让仪表盘与告警依赖稳定口径。不要把历史资料中的 storage_operation_duration_seconds 当作当前 kubelet CSI 操作基线;节点侧应查询 csi_operations_seconds,容量则使用 kubelet_volume_stats_*。
验收一份可用基线
一份可用基线应能回答三个问题:PVC 从创建到可挂载通常需要多久;一次失败能否定位到具体 driver、operation 和 node;容量异常能否反查到 PV/PVC 与后端卷。可以在健康环境创建测试 PVC 和 Pod,记录 PVC Bound、Pod Ready 的时间点,并确认日志、事件与指标可以串出同一条链路。
最终把采集源、关键字段、统一指标口径、正常区间、保留周期和负责人固化到运维文档。这样 Provision、Attach 或 Mount 出现异常时,就能从指标下钻到对应日志,而不是在故障发生后重新寻找证据。