
容器与云原生 / 系统课时
划分 Kubernetes 存储故障边界
划分 Kubernetes 存储故障边界
Kubernetes 存储故障最容易被误判成“CSI 坏了”。本篇把一次持久卷请求拆成 API 对象、调度、CSI 控制面、节点插件、主机挂载与存储后端六层,并给出从现象到责任边界的固定取证顺序。
学习目标
- 能根据 Pod、PVC、PV、VolumeAttachment 与事件判断故障停在哪一层
- 能区分调度、CSI Controller、CSI Node、主机内核和存储后端各自负责什么
- 能按证据链收集信息,避免一开始就重启 CSI 或节点
先从对象状态判断请求走到哪里
排障时先问“控制流程走到了哪一步”,而不是先问“哪个组件可能有 bug”。PVC 长时间 Pending,通常还没有进入节点挂载;Pod 已调度但卡在 ContainerCreating,则要继续看 attach、stage、publish 或主机挂载。应用已经启动后出现 I/O 错误,重点才逐渐转向文件系统、设备路径与后端。
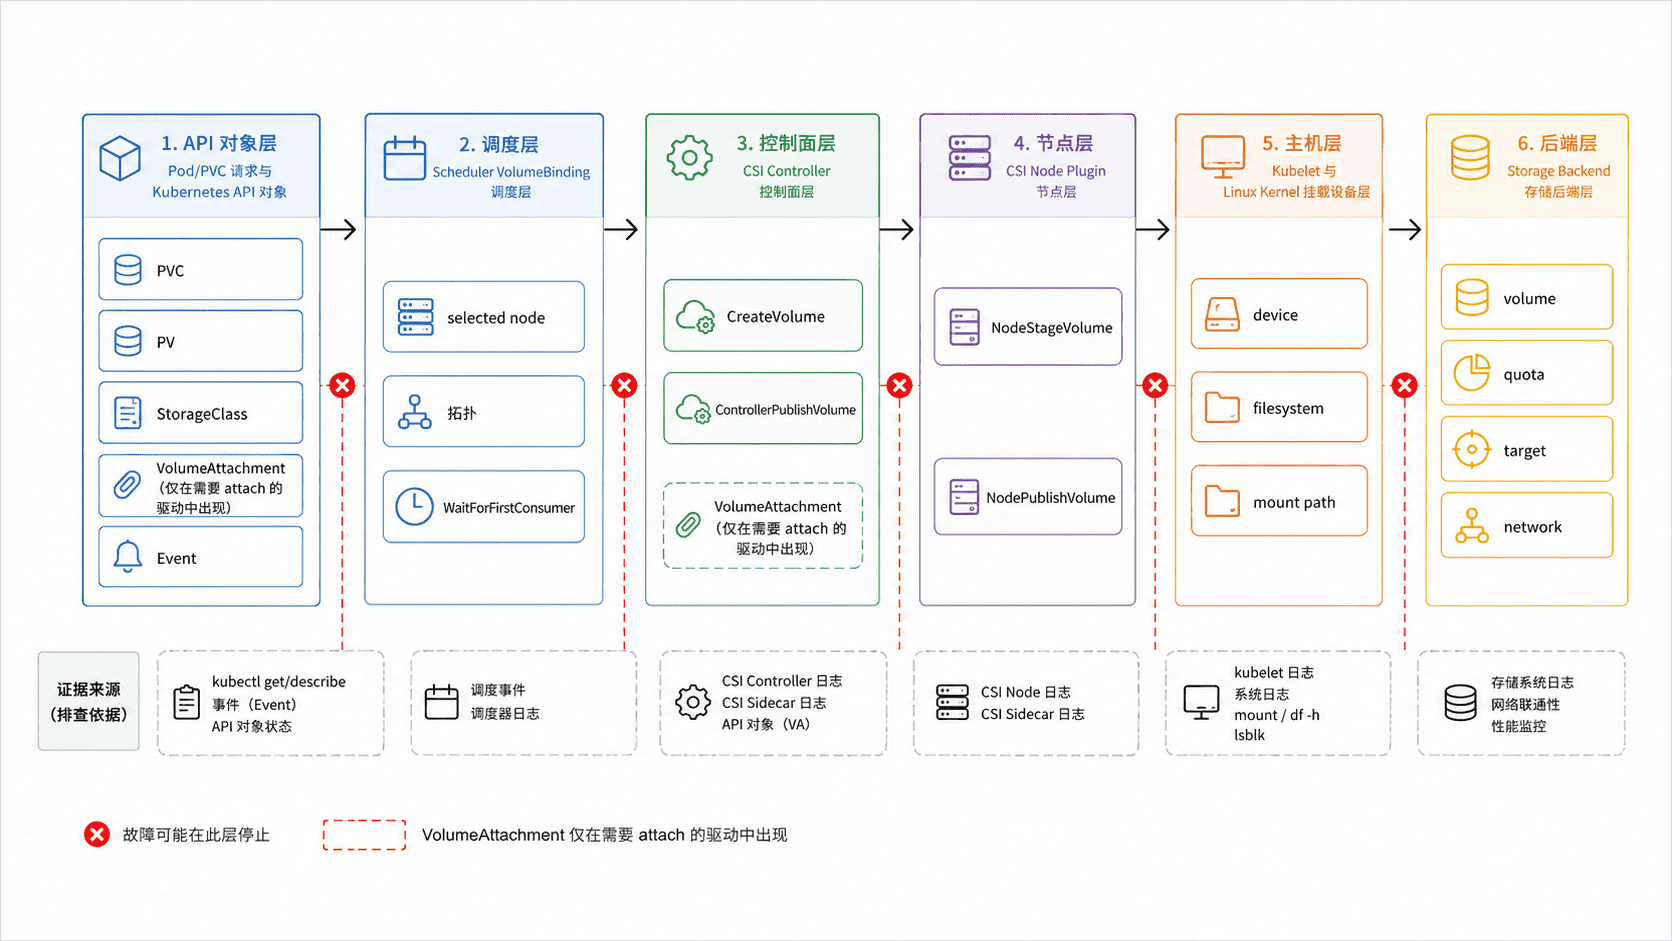
这条链路的价值在于:上游对象没有形成时,下游通常没有可查的调用;而下游已经报 I/O 错误时,反复修改 PVC 也不会解决主机或后端问题。
六层边界分别负责什么
- API 对象层保存期望状态和控制器结果。重点看 PVC 是否绑定、PV 指向哪个 CSI driver、StorageClass 的
volumeBindingMode与参数,以及 Event 中是谁报告了失败。API 对象通常是证据载体,不等于根因本身。 - 调度层决定带卷 Pod 能否落到满足容量、访问模式和拓扑约束的节点。使用
WaitForFirstConsumer时,PVC 在消费者出现前保持未绑定可能是正常行为;真正的调度失败应从 Pod Event 和 PVC Event 交叉确认。 - CSI 控制面层负责动态供应以及驱动支持时的 attach/detach 等控制面 RPC。常见参与者包括 external-provisioner、external-attacher 与 CSI controller plugin。若
CreateVolume或ControllerPublishVolume失败,应优先检查控制器日志和后端 API。 - CSI 节点层在目标节点执行卷的 stage/publish。是否存在
NodeStageVolume取决于驱动是否声明相应能力;NodePublishVolume失败则通常能在 kubelet 与 CSI node plugin 日志中看到对应错误。 - 主机挂载层涉及设备发现、文件系统、mount namespace、权限与内核返回码。此时 Kubernetes 对象往往已经基本正确,必须到实际节点验证
findmnt、lsblk、内核日志和 kubelet 管理目录。 - 存储后端层负责真实卷、导出目标、容量、配额、认证与数据面可达性。控制面 API 成功并不保证数据路径健康;例如卷已创建但节点到 iSCSI、NVMe/TCP、NFS 或分布式存储数据面的链路仍可能失败。
按证据链收集第一轮信息
先执行一轮只读命令,把对象状态、驱动声明和 CSI Pod 放在同一个时间窗口里观察。将 <NAMESPACE> 与 <POD> 替换为实际工作负载。
kubectl get pod -n <NAMESPACE> <POD> -o wide
kubectl get pvc -n <NAMESPACE>
kubectl get pv
kubectl get storageclass
kubectl get csidrivers.storage.k8s.io -o custom-columns='NAME:.metadata.name,ATTACH:.spec.attachRequired,PODMOUNT:.spec.requiresRepublish'
kubectl get volumeattachments.storage.k8s.io
kubectl get events -n <NAMESPACE> --sort-by=.lastTimestamp
kubectl get pods -A -o wide | grep -Ei 'csi|storage' || true
预期结果
Pod、PVC、PV、StorageClass、CSIDriver、VolumeAttachment(若驱动需要)和事件均能被读取。
正常已绑定场景中 PVC/PV 通常可见 Bound;CSI controller/node Pod 应处于可运行状态。
对象名称、节点、时间戳和具体状态会因集群而不同。
观察顺序要固定:先确认 PVC 是否绑定,再确认 Pod 是否已经选定节点;只有节点已经明确后,才去追 VolumeAttachment、CSI node plugin 和主机挂载。这样可以防止把调度失败误当成 NodePublishVolume 失败。
如果事件已经给出 FailedMount、FailedAttachVolume 或供应失败信息,再根据事件中的组件和错误码进入对应层。事件只保留有限时间,因此生产事故中应尽早导出相关对象和日志。
把节点与后端问题分开
当 Pod 已经落到节点且 PVC/PV 正常,下一步要判断失败发生在 CSI RPC 之前、RPC 内部,还是内核真正执行 mount 或访问设备时。节点上看到设备但 mount 失败,与节点根本看不到设备,是两条不同证据链。
在目标节点的主机环境执行以下只读检查;<PATH> 应替换为事件或 kubelet 日志中出现的实际挂载路径。
findmnt "<PATH>" || true
lsblk -f
dmesg --ctime | tail -n 80
预期输出
findmnt:挂载成功时显示目标路径、源设备或文件系统;失败时可能无匹配记录。
lsblk -f:列出节点当前可见的块设备和文件系统。
dmesg:若内核、设备或文件系统报错,可在最近日志中看到对应信息;具体内容因驱动和后端而异。
若 CSI node 日志显示 NodePublishVolume 成功,但 findmnt 与实际路径不一致,要继续检查 kubelet 与驱动的挂载传播和路径;若 node plugin 连目标设备都无法发现,则优先检查 attach 结果、设备映射和后端数据面,而不是重建 PVC。
避免跨层误修
最常见的误操作是看到 Pod ContainerCreating 就删除 PVC,或看到 PVC Pending 就重启 kubelet。前者可能破坏尚可恢复的数据卷,后者则绕过了真正的调度或供应问题。
另一个高频误判是只看 CSI controller 日志。controller 负责的是控制面 RPC,节点挂载失败必须看对应节点的 kubelet 与 CSI node plugin;反过来,CreateVolume 都没有成功时,到节点查 mount 也不会有有效线索。
最终的修复动作应与证据停留的边界一致:对象或调度配置错误就修正声明和拓扑;CSI RPC 失败就处理驱动或其后端 API;主机 mount 失败就定位设备、文件系统和内核;后端数据面异常则恢复存储服务或网络。只要先确定“最后一个成功步骤”和“第一个失败步骤”,Kubernetes 存储故障就能从模糊的 CSI 问题收敛为可验证的责任域。