
容器与云原生 / 系统课时
设计 CSI 拓扑与可用区约束
设计 CSI 拓扑与可用区约束
本课解决多可用区集群中的卷落点设计:先识别 CSI 驱动实际发布的拓扑键,再让 StorageClass、Pod 调度约束与驱动可访问范围形成交集,最后从 PV 的 nodeAffinity 反查卷真正可访问的位置。
学习目标
- 从
CSINode与 Node 标签识别 CSI 驱动支持的拓扑键和值 - 正确使用
allowedTopologies收窄动态供给范围,并与 Pod 调度约束对齐 - 验证 Pod 节点、PV
nodeAffinity与卷拓扑是否一致
先找出驱动真正使用的拓扑键
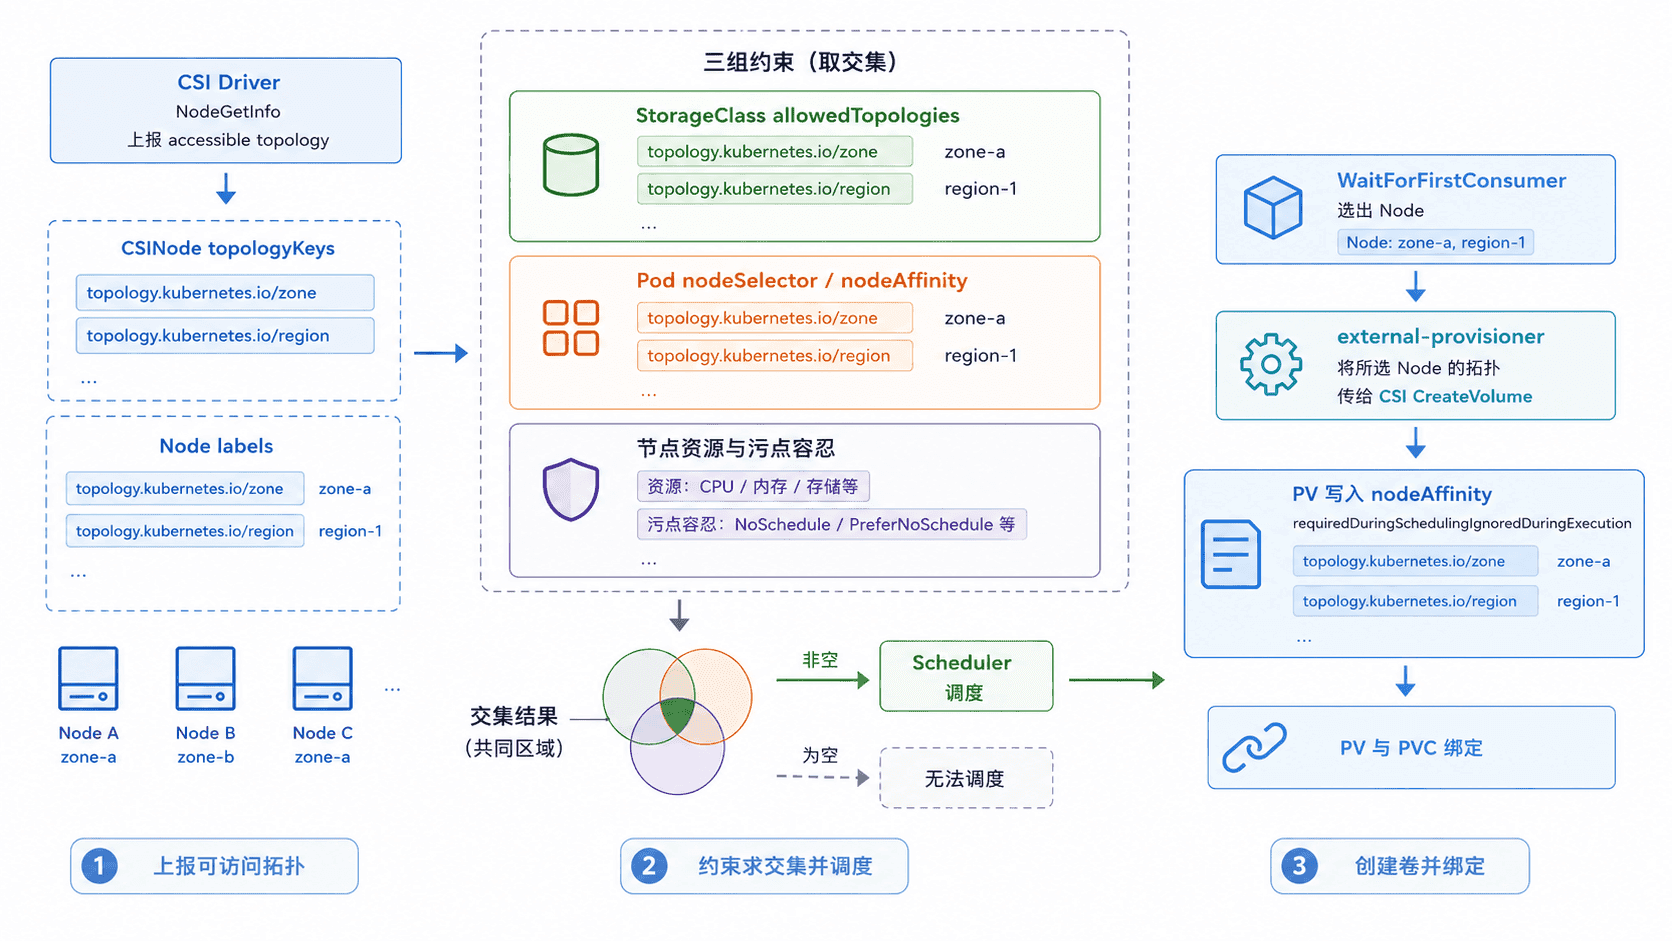
CSI 拓扑并不固定等于 topology.kubernetes.io/zone。驱动通过 NodeGetInfo 上报节点可访问拓扑,kubelet 注册驱动后会把拓扑键记录到 CSINode.spec.drivers[].topologyKeys,对应键值通常也会出现在 Node 标签中。设计 StorageClass 前,应以驱动实际发布的键为准。
kubectl get csinode -o custom-columns='NODE:.metadata.name,DRIVERS:.spec.drivers[*].name,TOPOLOGY_KEYS:.spec.drivers[*].topologyKeys'
kubectl get nodes -o custom-columns='NODE:.metadata.name,ZONE:.metadata.labels.topology\.example\.com/zone'
预期输出示意:
NODE      DRIVERS             TOPOLOGY_KEYS
node-a    csi.example.com     topology.example.com/zone
node-b    csi.example.com     topology.example.com/zone

NODE      ZONE
node-a    zone-a
node-b    zone-b
实际驱动名、节点名、拓扑键和可用区值会不同。若第二条命令显示空值,应先执行 kubectl get node <NODE> --show-labels 确认真实标签,而不是根据云厂商的可用区名称猜键名。
用 allowedTopologies 收窄动态供给范围
StorageClass.allowedTopologies 是动态供给位置的硬白名单。配合 WaitForFirstConsumer 时,调度器会先综合 Pod 的调度条件与存储拓扑,再选择可行节点;只有存储等级确实必须限制在特定区域、机房或存储池时,才应额外用 allowedTopologies 收窄范围。
下面的主示例依赖集群已经安装可用的 CSI 驱动,并且节点存在对应拓扑标签。csi.example.com 与 topology.example.com/zone 必须替换为前一步查到的真实值。StorageClass 的正确 API 版本是 storage.k8s.io/v1。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: zonal-ssd
provisioner: csi.example.com
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Delete
allowedTopologies:
  - matchLabelExpressions:
      - key: topology.example.com/zone
        values:
          - zone-a
          - zone-b
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: demo-data
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: zonal-ssd
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: demo-app
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              - key: topology.example.com/zone
                operator: In
                values:
                  - zone-a
  containers:
    - name: app
      image: busybox:1.36
      command: ["sh", "-c", "sleep 3600"]
      volumeMounts:
        - name: data
          mountPath: /data
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: demo-data
将配置保存为 <PATH> 后执行:
kubectl apply -f <PATH>
kubectl wait --for=condition=Ready pod/demo-app --timeout=120s
预期输出示意:
storageclass.storage.k8s.io/zonal-ssd created
persistentvolumeclaim/demo-data created
pod/demo-app created
pod/demo-app condition met
若镜像拉取、后端供给或调度速度不同,等待时间可能变化;若命令超时,应继续查看 Pod、PVC 与事件,而不是把超时本身当作拓扑结论。
理解调度与供给的交集
allowedTopologies 不会单独把 Pod“调度到”某个可用区,它只限制卷允许在哪些拓扑中被动态创建。真正的可行落点必须同时满足 Pod 节点约束、StorageClass 白名单、CSI 驱动可访问拓扑,以及资源、污点、容量等其他调度条件。
在本例中,StorageClass 允许 {zone-a, zone-b},Pod 只允许 {zone-a},因此最终交集只有 {zone-a}。如果把 Pod 改为只允许 zone-c,而 StorageClass 仍只允许 zone-a 和 zone-b,就没有可行拓扑,Pod 与 PVC 会持续等待调度或供给。
从 PV 反查最终可访问位置
动态供给完成后,不要只看 Pod 是否 Running。PVC 绑定到的 PV 才记录了卷最终的可访问拓扑,拓扑感知 CSI 驱动通常会在 PV 的 spec.nodeAffinity 中写入节点约束。
PV=$(kubectl get pvc demo-data -o jsonpath='{.spec.volumeName}')
kubectl get pv "$PV" -o jsonpath='{range .spec.nodeAffinity.required.nodeSelectorTerms[*].matchExpressions[*]}{.key}{"="}{.values}{"\n"}{end}'
NODE=$(kubectl get pod demo-app -o jsonpath='{.spec.nodeName}')
kubectl get node "$NODE" -o jsonpath='{.metadata.labels.topology\.example\.com/zone}{"\n"}'
预期输出示意:
topology.example.com/zone=[zone-a]
zone-a
如果实际驱动使用其他拓扑键,需要同步调整最后一条 JSONPath。验证目标是形成“Pod 所在节点标签 → PV nodeAffinity → CSI 卷拓扑”一致的证据链,而不是机械匹配示例中的键名。
冲突时先找哪一层不一致
若 PVC 已经 Bound,但 Pod 报告卷节点亲和性冲突,优先比较 PV nodeAffinity 与候选 Node 标签;这通常说明卷已经固定在某个拓扑,而当前 Pod 约束把可访问该卷的节点排除在外。若 PVC 长期无法绑定,则回到 StorageClass、Pod 调度条件和 CSI 驱动支持的拓扑三处检查是否仍有交集。
生产环境中,更稳妥的做法不是继续堆叠区域规则,而是先确定唯一可信的 CSI 拓扑键,再让 StorageClass 的供给范围、应用调度策略和故障监控围绕同一套拓扑语义工作。