
容器与云原生 / 系统课时
演练后端容量耗尽与扩容
演练后端容量耗尽与扩容
本课模拟“后端池接近耗尽”与“业务卷空间不足”两类容量故障,练习从告警和 PVC 事件判断故障边界,再选择原卷扩容或迁移到新卷。最终要验证的不只是 PVC 数字变大,而是应用重新可写、文件系统容量生效且数据完整。
学习目标
- 区分后端无法供应新卷与现有卷文件系统耗尽两种故障
- 验证 StorageClass 与 CSI 驱动是否允许在线扩容
- 完成扩容或迁移后的容量、写入和数据一致性验收
先判断是哪一层容量不足
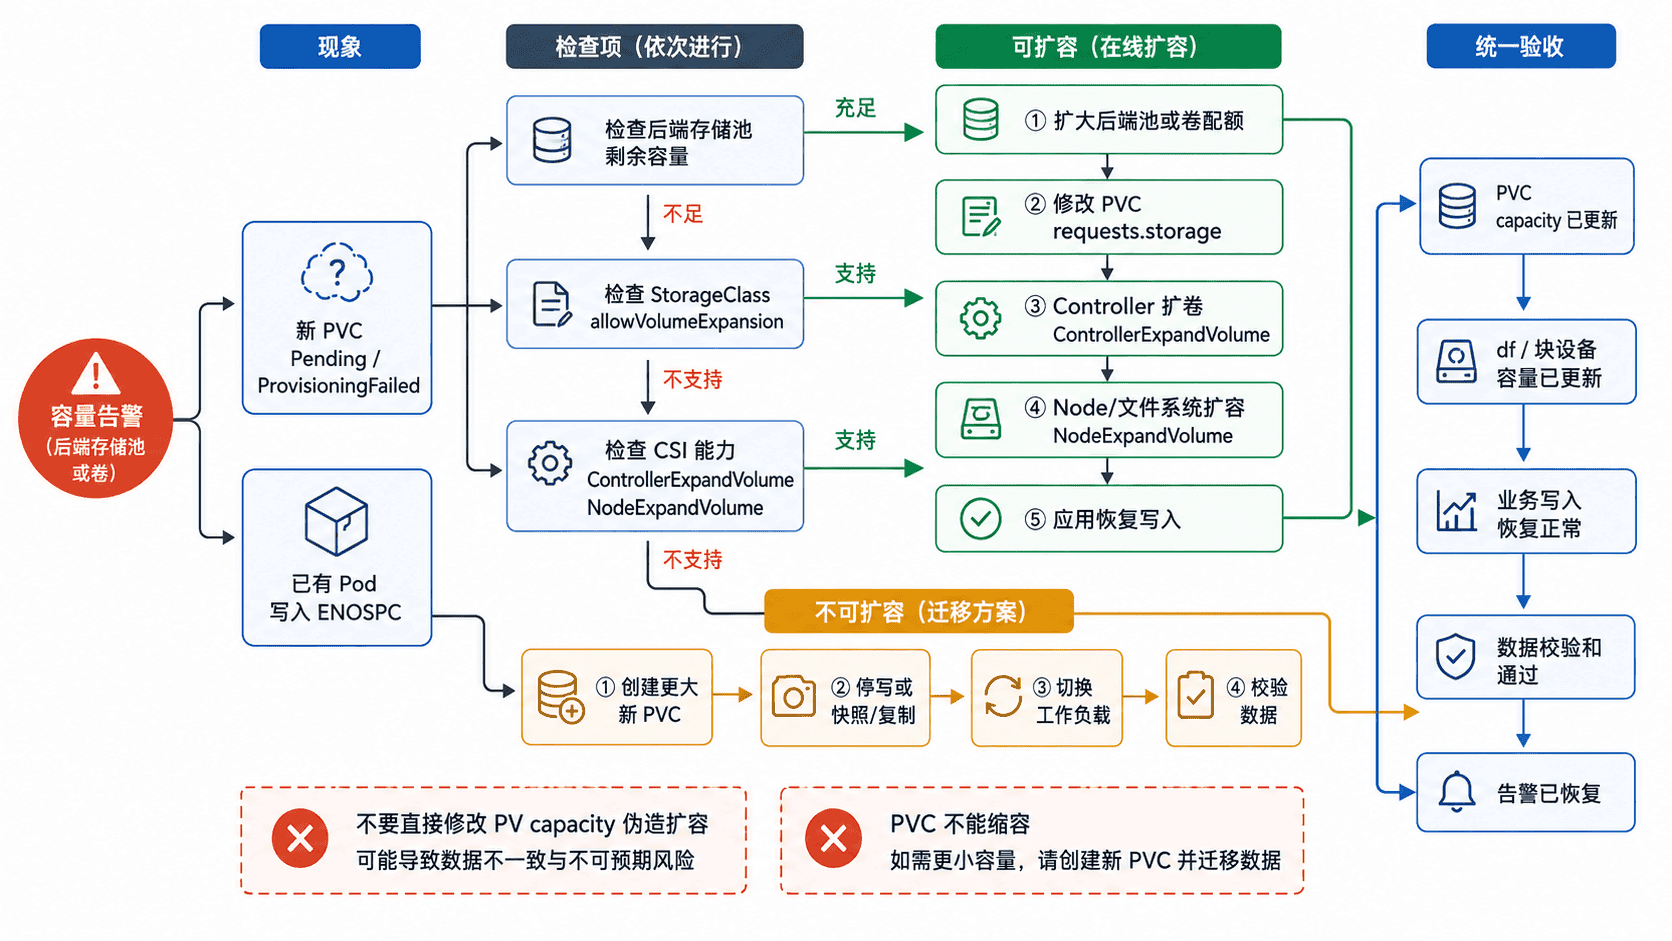
新 PVC 长时间 Pending 时,优先查看 PVC Events;已有 Pod 报 No space left on device 时,则要同时检查容器内文件系统和后端卷容量。两种现象可能来自同一个存储池,但恢复动作不同。
kubectl get pvc -n storage-drill
kubectl describe pvc -n storage-drill data-db-0
kubectl exec -n storage-drill db-0 -- df -h /data
预期输出可能是:
NAME        STATUS   VOLUME     CAPACITY
data-db-0   Bound    pvc-<ID>   20Gi
Filesystem      Size  Used Avail Use% Mounted on
/dev/<ID> 20G 20G 0 100% /data若是新卷供应失败,describe pvc 的 Events 可能出现 ProvisioningFailed,错误内容由具体 CSI 驱动和后端返回;不要把某个厂商的错误码当作 Kubernetes 通用行为。
先确认扩容能力
PVC 扩容依赖 StorageClass 的 allowVolumeExpansion: true,并要求 CSI 驱动和后端支持对应扩容能力。先检查 StorageClass,不要直接改 PV 的 spec.capacity;那只会改变 Kubernetes 记录,不能让后端卷真正变大。
kubectl get storageclass fast-csi -o jsonpath='{.allowVolumeExpansion}{"\n"}{.provisioner}{"\n"}'预期输出:
true
csi.example.com
csi.example.com 只是演练中的示例驱动名,实际值以集群为准。如果这里不是 true,应先确认驱动能力和组织变更流程;若后端卷不能原地扩展,应走新卷迁移路径。
扩大 PVC 并观察两阶段生效
先确保后端存储池或配额已经有足够空间,再把 PVC 请求从 20Gi 调到 40Gi。PVC 只能扩容,不能通过减小 requests.storage 实现缩容。
kubectl patch pvc -n storage-drill data-db-0 --type merge -p '{"spec":{"resources":{"requests":{"storage":"40Gi"}}}}'
kubectl get pvc -n storage-drill data-db-0
kubectl exec -n storage-drill db-0 -- df -h /data
预期输出:
persistentvolumeclaim/data-db-0 patched
NAME        STATUS   VOLUME     CAPACITY
data-db-0   Bound    pvc-<ID>   40Gi
Filesystem      Size  Used Avail Use% Mounted on
/dev/<ID>        40G   20G   <VALUE>  50% /data
实际文件系统容量和使用率会因格式化开销而不同。对于文件系统卷,Kubernetes 与 CSI 驱动可能经历控制面扩卷和节点侧文件系统扩容两个阶段;如果 PVC 已显示更大但 df 未变化,应检查 PVC Events、CSI Node Plugin 日志以及驱动是否支持节点侧扩容。
扩不了时迁移,不要硬改对象
当存储类不允许扩容、后端卷达到产品上限,或扩容失败无法在目标 RTO 内修复时,创建更大的新 PVC,并使用应用原生复制、存储快照/克隆或经过验证的数据复制流程迁移。切换前应进入停写或一致性快照窗口,避免源卷在复制期间继续变化。
验证业务恢复与数据完整性
容量恢复后,执行一次真实写入并读取故障前标记,最后确认 Pod 就绪和容量告警回落。
kubectl exec -n storage-drill db-0 -- sh -c 'cat /data/drill-marker && echo capacity-recovered > /data/capacity-check && sync && cat /data/capacity-check'
kubectl get pod -n storage-drill db-0 -o jsonpath='{.status.containerStatuses[0].ready}{"\n"}'
预期输出:
<TIME>
capacity-recovered
true
如果应用可写、故障前标记仍可读、PVC 与文件系统容量均达到目标,并且后端池重新保有安全余量,才算本次容量演练通过。把从首个容量告警到业务重新健康的时间记录为 RTO,同时保留扩容失败事件和后端容量曲线,作为后续调整告警阈值与扩容余量的依据。