
容器与云原生 / 系统课时
排查节点故障后的卷恢复
排查节点故障后的卷恢复
节点故障后的卷恢复,核心不是尽快把卷“拔走”,而是先确认旧节点是否仍可能写盘,再选择计划维护或非优雅关机的恢复路径。最终要让旧 Pod 与旧附件安全退出,新节点重新 Attach、Mount,并完成业务验收。
学习目标
- 区分计划下线、NotReady、网络分区和非优雅断电的处理边界
- 用 Pod、Node、污点和 VolumeAttachment 判断卷为什么没有迁移
- 正确使用
drain与node.kubernetes.io/out-of-service,并验证恢复结果
先确认旧节点是否仍可能写盘
NotReady 只表示控制面无法确认 kubelet 正常工作,并不等于主机已经停止 I/O。对于只能由单个节点安全写入的卷,如果只是控制面与节点之间网络中断,旧应用可能仍在运行;这时过早 Detach 并让新节点接管,可能造成并发写入。
先把节点、旧 Pod 和卷附着关系放在一起采证。使用 --field-selector 按 spec.nodeName 筛选故障节点上的 Pod,避免在全局 Pod 列表中遗漏关键对象。
NODE='<FAILED_NODE>'

kubectl get node "$NODE" -o wide
kubectl get pods -A --field-selector spec.nodeName="$NODE" -o wide
kubectl get volumeattachment -o custom-columns=NAME:.metadata.name,PV:.spec.source.persistentVolumeName,NODE:.spec.nodeName,ATTACHED:.status.attached,DETACH_ERROR:.status.detachError.message
预期输出可能类似:
NAME            STATUS     ROLES    AGE   VERSION
<FAILED_NODE>   NotReady   <ROLE>   <AGE> <VERSION>

NAMESPACE   NAME        READY   STATUS        NODE
<NS>        <OLD_POD>   0/1     Terminating   <FAILED_NODE>

NAME                 PV     NODE            ATTACHED   DETACH_ERROR
<VOLUMEATTACHMENT>   <PV>   <FAILED_NODE>   true       <none>
实际 Pod 状态可能是 Running、Unknown、Terminating 或其他值。先回答两个问题:旧 Pod 是否仍绑定故障节点,旧卷是否仍显示附着在故障节点;随后再判断这是可正常驱逐的维护场景,还是必须先完成 fencing 的故障场景。
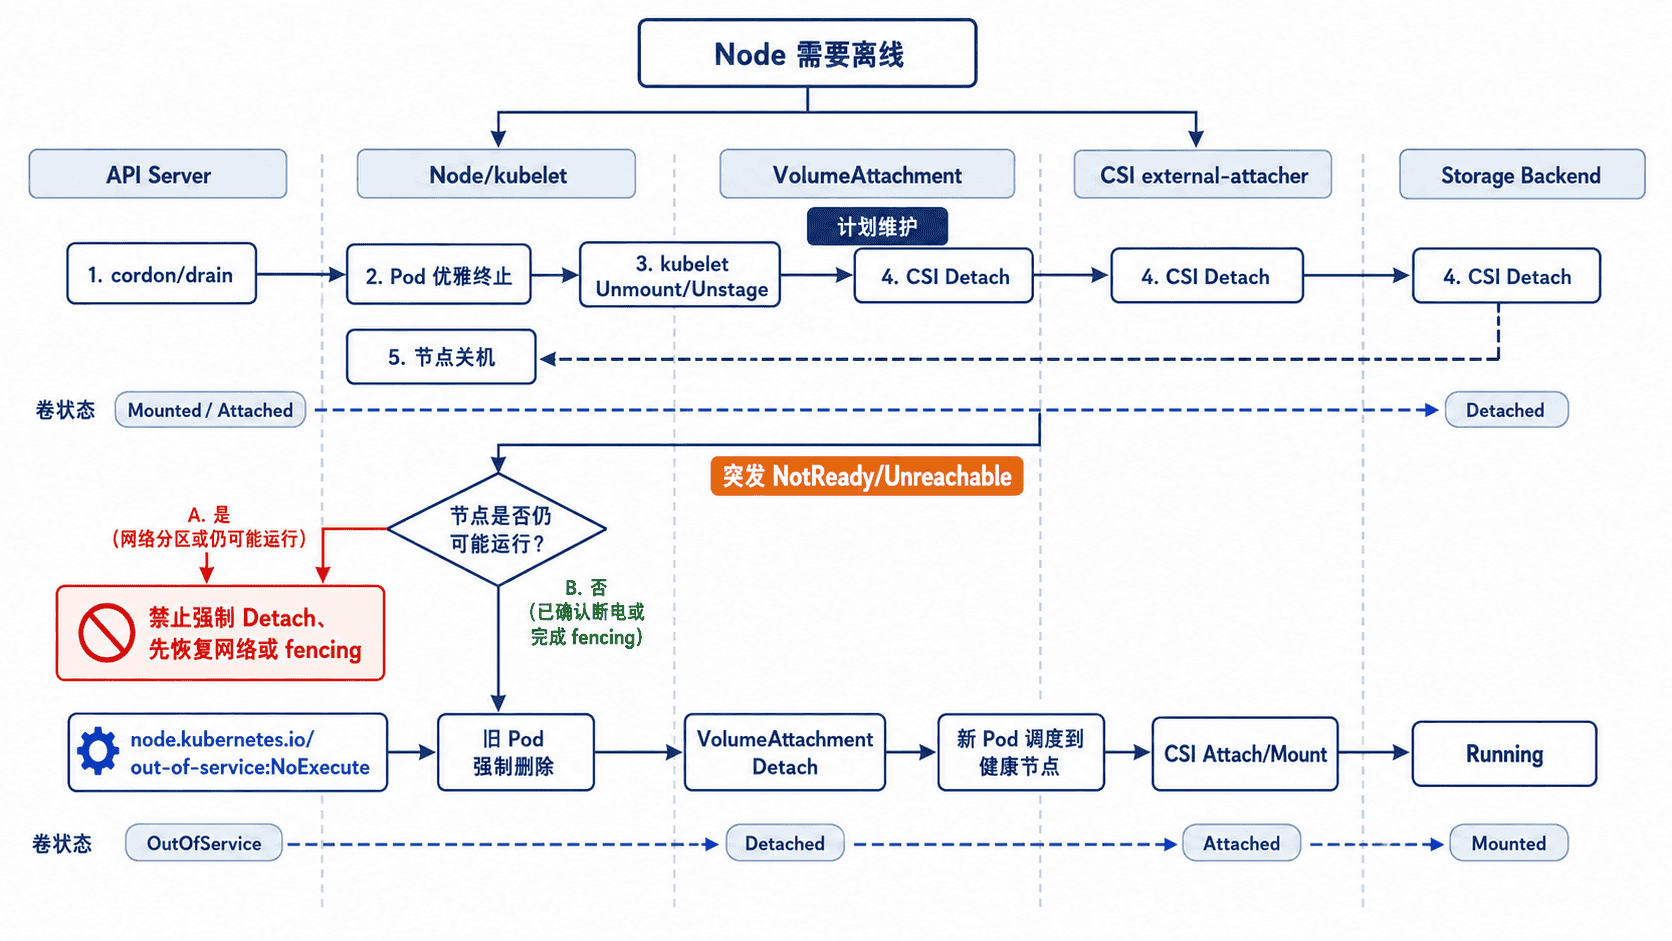
计划维护让 drain 完整结束
节点仍健康可达时,优先走计划维护路径。kubectl drain 会先把节点标记为不可调度,再通过 Eviction 驱逐普通工作负载并等待优雅终止。只有 drain 成功结束后再关机,kubelet 才有机会卸载文件系统,CSI Node 侧也能完成 Unpublish/Unstage,随后控制面再推进 Detach。
NODE='<NODE>'

kubectl drain "$NODE" --ignore-daemonsets
kubectl get node "$NODE" -o custom-columns=NAME:.metadata.name,UNSCHEDULABLE:.spec.unschedulable
预期输出:
node/<NODE> cordoned
evicting pod <NS>/<POD>
pod/<POD> evicted
node/<NODE> drained

NAME     UNSCHEDULABLE
<NODE>   true
如果 drain 因 PodDisruptionBudget、未受控制器管理的 Pod 或 emptyDir 停住,应先确认阻塞原因。不要把 --force、绕过 Eviction 或删除本地数据的选项当作默认参数,因为它们会改变可用性或数据安全语义。维护完成并确认节点、网络和 CSI Node Plugin 正常后,再执行 kubectl uncordon <NODE>;永久退役的节点则不需要重新开放调度。
非优雅断电必须先完成 fencing
突发掉电、主机损坏或操作系统崩溃时,旧 kubelet 无法正常卸载,Pod 与 VolumeAttachment 可能长期停留在旧节点。安全恢复的关键不是“NotReady 已经多久”,而是能否证明旧节点不会继续访问卷。
可接受的证据包括物理机已经断电、云实例已经停止或销毁、带外管理确认电源关闭,或者存储与基础设施已经完成可靠 fencing。若只是 API Server 到节点之间的网络中断,而节点侧应用仍可能运行,就不能继续强制接管。
确认旧节点已经停止写盘后,再添加 out-of-service 污点:
NODE='<FAILED_NODE>'

kubectl taint nodes "$NODE" node.kubernetes.io/out-of-service=storage-recovery:NoExecute
kubectl get node "$NODE" -o custom-columns=NAME:.metadata.name,TAINTS:.spec.taints
kubectl get pods -A --field-selector spec.nodeName="$NODE" -o wide
预期结果可能类似:
node/<FAILED_NODE> tainted
NAME            TAINTS
<FAILED_NODE>   [map[effect:NoExecute key:node.kubernetes.io/out-of-service value:storage-recovery]]

NAMESPACE   NAME        READY   STATUS        NODE
<NS>        <OLD_POD>   0/1     Terminating   <FAILED_NODE>
该污点用于非优雅关机恢复:没有相应容忍的 Pod 会被强制清理,控制面也会推进故障节点上的卷附件清理,使卷能够在其他节点重新附着。若业务 Pod 显式容忍了 node.kubernetes.io/out-of-service,必须先确认这一容忍的设计目的,不能假设控制面会自动迁移它。
卡住时沿对象链继续定位
满足恢复前提后卷仍不迁移,不要反复删除 Pod。先看旧 Pod 是否仍绑定故障节点、新 Pod 是否已在其他节点创建;再看节点上的 not-ready、unreachable 和自定义 toleration 是否延迟了清理;最后看旧 VolumeAttachment 是否仍为 attached=true,以及 detachError 是否给出后端错误。
如果 Kubernetes 已经进入 Detach 流程,但 VolumeAttachment 长时间不变化,再检查 external-attacher、CSI Controller 日志和存储后端。计划维护场景还要回看节点是否在 drain 成功前就被直接关机;这个顺序错误会让 kubelet 来不及卸载,最终表现为“Pod 已经准备去新节点,但卷仍留在旧节点”。
验证新附件后再恢复旧节点
恢复完成要同时验证新 Pod、卷附件和旧节点。业务先稳定在新节点,确认目标 PV 只剩预期的新附件,再考虑让旧节点重新参与调度。
NS='<NAMESPACE>'
NEW_POD='<NEW_POD>'
OLD_NODE='<FAILED_NODE>'
PV='<PV>'

kubectl -n "$NS" get pod "$NEW_POD" -o wide
kubectl get volumeattachment -o custom-columns=PV:.spec.source.persistentVolumeName,NODE:.spec.nodeName,ATTACHED:.status.attached
kubectl get node "$OLD_NODE" -o wide
预期结果:
NAME        READY   STATUS    NODE
<NEW_POD>   1/1     Running   <NEW_NODE>

PV     NODE         ATTACHED
<PV>   <NEW_NODE>   true

NAME         STATUS    ROLES    AGE   VERSION
<OLD_NODE>   <VALUE>   <ROLE>   <AGE> <VERSION>
旧节点修复并确认新节点上的工作负载稳定后,移除 out-of-service 污点;如果该节点此前还被 cordon,并且准备重新承载工作负载,再解除不可调度状态。
NODE='<FAILED_NODE>'

kubectl taint nodes "$NODE" node.kubernetes.io/out-of-service-
kubectl uncordon "$NODE"
预期输出:
node/<FAILED_NODE> untainted
node/<FAILED_NODE> uncordoned
安全顺序始终是:先证明旧写入方失效,再清理旧 Pod 与旧附件,最后让新节点接管。把 NotReady 直接等同于“可以强制 Detach”,或在 drain 尚未完成时关机,最容易把节点故障扩大成存储一致性事故。