
容器与云原生 / 系统课时
演练供应成功但 Pod 无法启动
演练供应成功但 Pod 无法启动
这类故障最容易被“PVC 已 Bound”误导。演练的关键是把“卷已供应”与“Pod 已可用”拆成独立阶段,沿 PVC/PV、调度、Attach、Mount、容器启动逐层收集证据;在哪一层第一次出现异常,就在哪一层修复并回归验证。
学习目标
- 用对象状态和 Pod 事件判断故障停在哪个存储阶段
- 区分调度、Attach、Mount 与应用启动问题
- 完成修复后的 Ready 与事件双重验证
先确认 Bound 只证明了什么
PVC 为 Bound 只说明它已经绑定到某个 PV;如果是动态供给,也只能说明 Provision 阶段成功。它不能证明 Pod 已经选到节点,更不能证明卷已经完成 Attach、Stage、Publish 或成功挂载进容器。
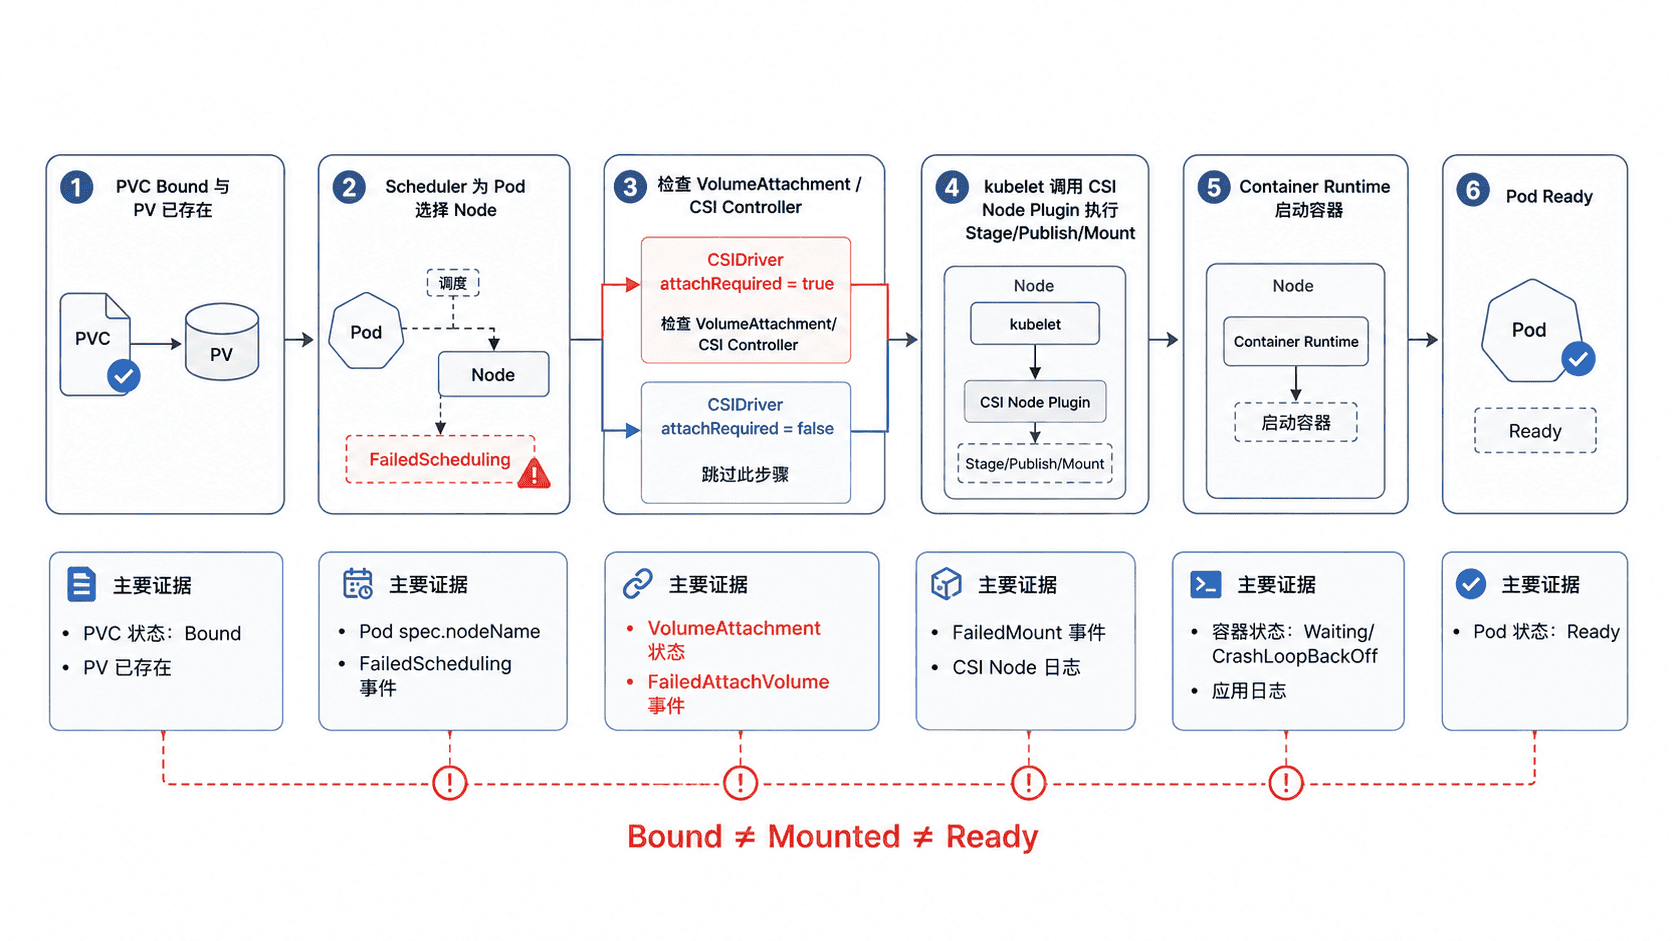
先固定命名空间、Pod 与 PVC,再一次性取出 PV、节点、CSI 驱动和 Pod 事件。下面这组命令只读取资源,适合作为综合演练的第一组证据。
NS=app
POD=web-0
PVC=data

PV=$(kubectl -n "$NS" get pvc "$PVC" -o jsonpath='{.spec.volumeName}')
NODE=$(kubectl -n "$NS" get pod "$POD" -o jsonpath='{.spec.nodeName}')
DRIVER=$(kubectl get pv "$PV" -o jsonpath='{.spec.csi.driver}')

kubectl -n "$NS" get pvc "$PVC" -o custom-columns=NAME:.metadata.name,STATUS:.status.phase,VOLUME:.spec.volumeName
kubectl -n "$NS" get pod "$POD" -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName,PHASE:.status.phase
kubectl -n "$NS" get events --field-selector involvedObject.kind=Pod,involvedObject.name="$POD" --sort-by=.lastTimestamp
printf 'PV=%s NODE=%s DRIVER=%s\n' "$PV" "$NODE" "$DRIVER"
预期输出:如果故障位于 Mount 阶段,会看到 PVC 已绑定、Pod 已分配节点,但事件中出现 FailedMount。实际时间、节点名、ID、驱动名和错误描述会不同。
NAME   STATUS   VOLUME
data   Bound    pvc-<ID>
NAME    NODE          PHASE
web-0   worker-<ID>   Pending
<TIME>   Warning   FailedMount   pod/web-0   <VALUE>
PV=pvc-<ID> NODE=worker-<ID> DRIVER=<VALUE>
按第一次异常决定下一跳
如果 NODE 为空,并且事件中出现 FailedScheduling,先查 nodeSelector、affinity、taint/toleration、PV nodeAffinity 与存储拓扑。这时 Pod 还没有进入节点阶段,不应先追 kubelet 或 CSI Node Plugin 的 Mount 日志。
如果节点已经确定,再看事件是否出现 FailedAttachVolume。对于需要 Attach 的 CSI 驱动,应继续检查 VolumeAttachment、CSI Controller 与 external-attacher;如果对应 CSIDriver 的 attachRequired 为 false,则不存在 ControllerPublish/Attach 这一步,应直接转向节点挂载证据。
如果事件出现 FailedMount、MountVolume.SetUp failed 或 CSI RPC 错误,重点转向目标节点:确认 CSI Node Plugin 在该节点已注册且 Running,并核对 NodeStage/NodePublish 所需的 Secret、设备、文件系统和挂载路径。只重启 Pod 通常不能解决节点或后端条件未满足的问题。
如果卷已经成功挂载,而容器进入 CreateContainerError、CrashLoopBackOff 或应用自身退出,就应把故障边界切换到容器与应用层。常见原因包括挂载目录权限、只读与读写模式不匹配、容器用户无权访问目录以及应用配置错误;fsGroup 是否生效还取决于卷类型与 CSI 驱动的 fsGroupPolicy,不能把它当作通用修复按钮。
修复时只改命中的故障层
调度问题应修正工作负载约束、PV 拓扑或后续 StorageClass 的绑定策略;已经承载数据的 PV/PVC 不应为了“重新调度”被随意删除。Attach 问题应修复控制器、后端附件状态或节点可达性;Mount 问题则处理目标节点上的 CSI 插件、Secret、设备、文件系统或挂载条件。
应用层权限问题要先确认卷已经成功 Publish,再调整容器用户、目录属主或驱动支持的组权限策略。这样既能避免把应用权限故障误判成 CSI 故障,也能避免为了一个目录权限问题重启整个存储控制面。
用 Ready 和新事件完成验收
修复后不要只确认 PVC 仍是 Bound,而应等待 Pod 真正进入 Ready,再查看最近事件,确认没有持续产生新的 Attach 或 Mount 错误。
kubectl -n app wait --for=condition=Ready pod/web-0 --timeout=120s
kubectl -n app get pod web-0
kubectl -n app get events --field-selector involvedObject.kind=Pod,involvedObject.name=web-0 --sort-by=.lastTimestamp
预期输出:
pod/web-0 condition met
NAME    READY   STATUS    RESTARTS   AGE
web-0   1/1     Running   <VALUE>    <TIME>
事件列表可能仍保留历史 FailedAttachVolume 或 FailedMount,因此验收重点不是“历史 Warning 消失”,而是修复后不再持续新增同类 Warning,同时 Pod Ready、应用读写验证正常。演练记录至少保留第一条异常证据、命中的故障层、修复动作和恢复时间,才能在真实事故中复用这条排查路径。