
消息队列 / 系统课时
排查 Under Replicated Partitions
排查 Under Replicated Partitions
本课解决 Kafka 出现 Under Replicated Partitions(URP)后,不知道先看哪个分区、哪个 Broker、影响有多大的问题。你将把 URP 从告警数字还原为具体分区和副本缺口,再按共同 Broker、持续时间与业务影响确定排查优先级。
学习目标
- 能确认 URP 对应的分区、Leader、Replica 与 ISR 状态
- 能从 Topic 范围与 Broker 范围判断故障集中点
- 能结合持续时间和业务重要性确定处置优先级
先把 URP 映射到具体分区
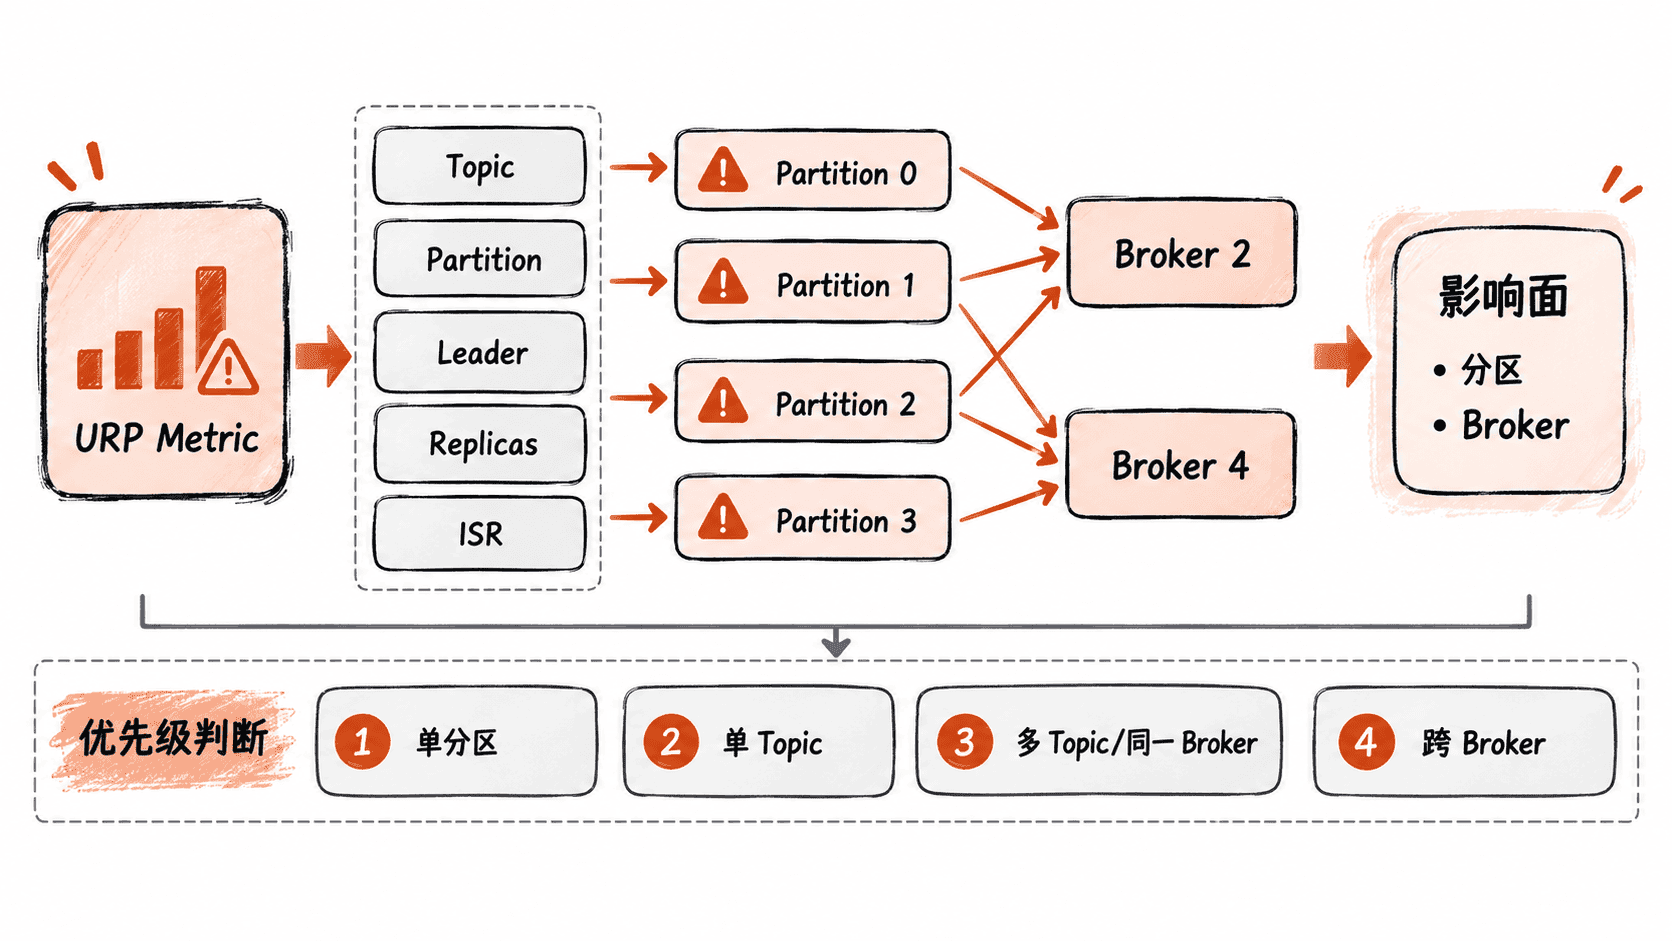
当一个分区的 ISR 数量小于已分配副本数量时,该分区处于副本未充分同步状态。因此监控中的 URP 数值代表受影响的分区数,不能直接理解为异常 Broker 数量;一个 Broker 异常可能让大量分区同时进入 URP。
先列出当前存在副本未充分同步的分区:
bin/kafka-topics.sh --bootstrap-server <BROKER> --describe --under-replicated-partitions预期输出(核心字段,具体字段顺序可能随 Kafka 版本不同):
Topic: orders Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,3这里 Replicas 包含 1、2、3,而 Isr 只有 1、3,说明 Broker 2 上的该分区副本已经退出 ISR。若命令没有返回分区记录,则当前没有被该条件筛出的 URP。实际 Broker 地址、Topic 和分区编号以现场输出为准。
从分区范围判断影响面
先回答“有多少分区受影响,以及它们是否集中”。少数分区出现 URP,优先检查这些分区对应的 Follower、日志目录和复制状态;单个 Topic 大面积出现,则继续看该 Topic 的流量和副本分布;多个 Topic 同时出现,应把调查范围提升到 Broker 或集群资源层。
| 现象 | 更值得优先检查 |
|---|---|
| 单个或少数分区 URP | 对应副本、Leader/Follower、日志目录 |
| 单个 Topic 大量 URP | Topic 流量、副本分布、相关 Broker |
| 多个 Topic 同时 URP | Broker 资源、网络、磁盘、集群负载 |
| 大量 URP 都缺少同一 Broker | 该 Broker 的服务、网络、磁盘与负载 |
这种归类能先区分局部副本异常和平台级异常,避免一看到 URP 就无差别检查整个集群。
从 Broker 范围寻找共同点
把受影响分区的 Replicas 与 Isr 对照起来,重点统计“哪个 Broker 经常出现在副本列表中,却反复从 ISR 缺失”。如果大量 URP 都缺少同一个 Broker,应优先检查该节点的 Kafka 进程、网络连通性、磁盘延迟、磁盘空间和复制负载。
如果 URP 分散在多个 Broker,且不存在明显共同节点,就不要过早归因于单机故障。此时更应检查跨节点网络、磁盘整体压力、复制流量以及集群负载是否同时异常,并结合更底层指标寻找共同时间点。
用持续时间和业务影响确定优先级
URP 数量必须和持续时间一起判断。少量 URP 在短时间内出现后迅速回到零,可能只是瞬时资源尖峰或副本短暂追赶;如果 URP 持续不降甚至增长,说明复制能力尚未恢复,应按持续故障处理。
关键业务 Topic 需要单独加权。即使只有少数分区 URP,只要持续时间较长,也可能意味着副本冗余正在下降,后续再失去副本时容错空间会进一步缩小,因此不能只按“数量少”判定低优先级。
固定排查顺序
实际故障中可以固定使用“URP 指标 → 具体分区 → 缺失 ISR 的共同 Broker → Broker 与集群资源证据 → 持续时间 → 业务影响”这条路径。先把告警数字映射成明确的分区和 Broker 范围,再决定继续做局部副本排查,还是升级为 Broker 或集群级故障处理,通常比直接翻查大量日志更高效。