
消息队列 / 系统课时
观测副本同步状态
观测副本同步状态
本课解决一个核心问题:当 Kafka 副本开始落后、ISR 发生变化或 Broker 出现异常时,如何同时看懂副本状态与 Broker 指标,并建立故障前后的可比基线。
学习目标
- 能用分区、副本和 ISR 状态判断同步是否正常
- 能结合 Broker 指标识别副本落后与资源压力的关系
- 能按统一时间窗口对比故障发生前后的状态变化
先看懂副本状态
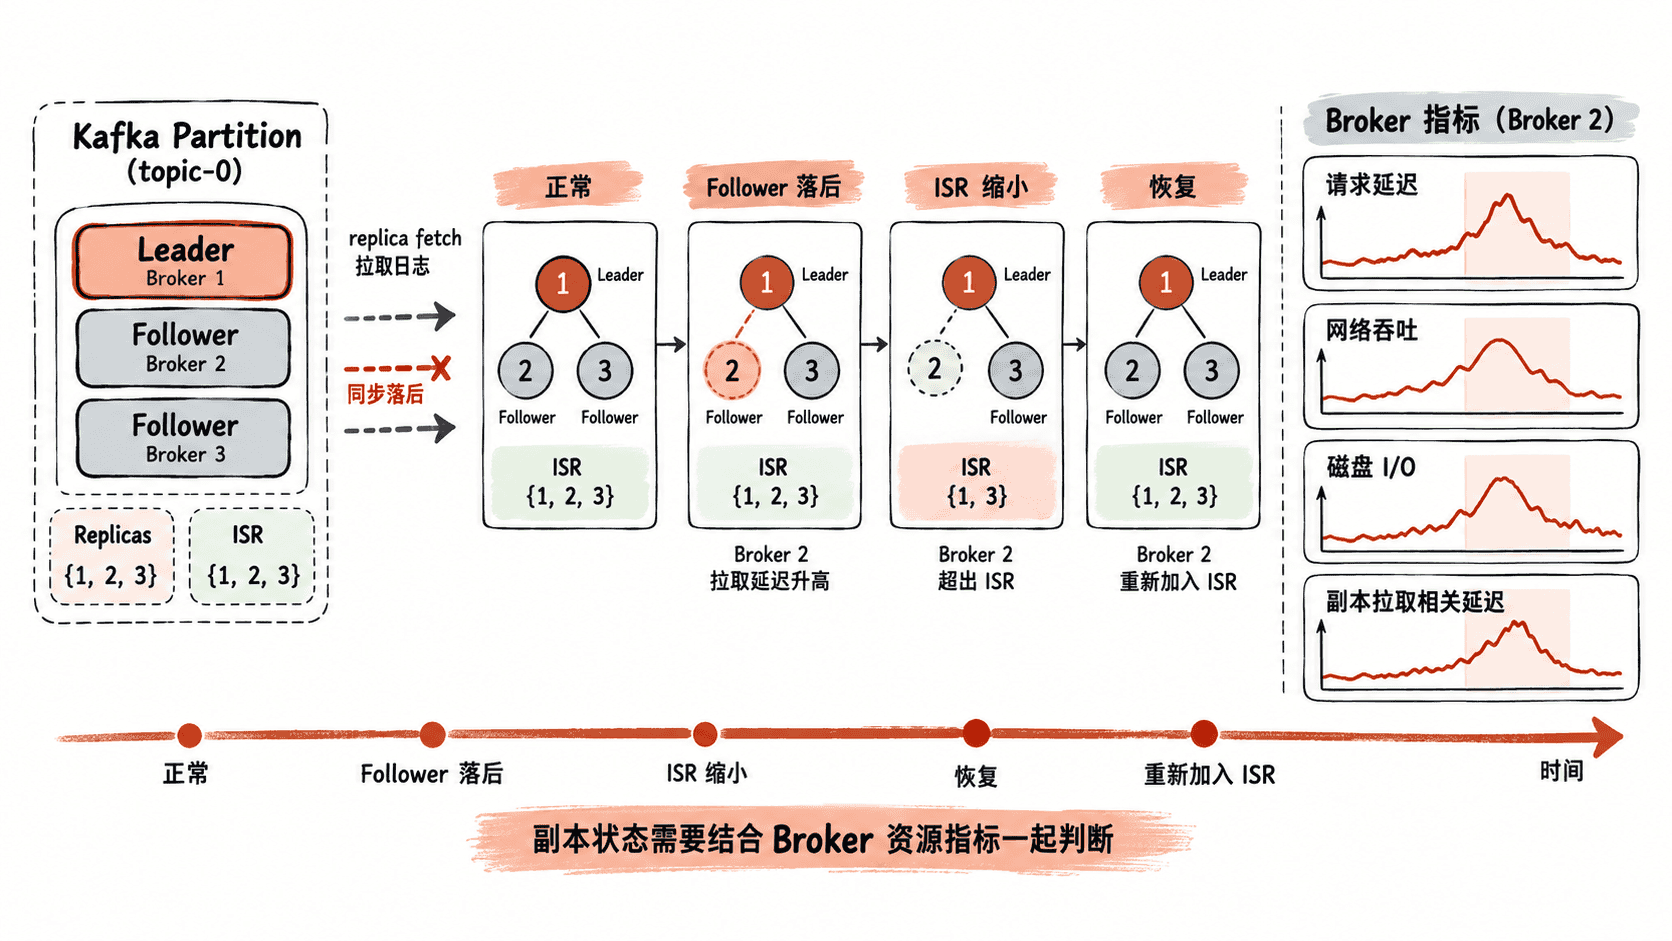
Kafka 一个分区通常有一个 Leader 和一个或多个 Follower。生产请求主要写入 Leader,Follower 从 Leader 拉取数据并追赶日志。ISR(in-sync replicas)表示当前满足同步条件、可以参与高可用副本集合判断的副本集合。
因此,Replicas、ISR 和 Leader 三个字段要一起看。副本总数没有变化,不代表同步正常;更有价值的是观察 ISR 是否缩小、Follower 是否持续落后,以及这些变化是否与 Broker 负载同时出现。
用命令建立状态快照
排查时先固定一个时间点采集分区副本状态,再结合 Broker 指标观察是否存在同步压力。最小化操作可以先从命令行查看指定 Topic 的分区、Leader、Replicas 和 ISR。
kafka-topics.sh --bootstrap-server <BROKER:PORT> --describe --topic <TOPIC>预期输出
Topic: <TOPIC>  Partition: <ID>  Leader: <BROKER_ID>  Replicas: <BROKER_ID>,<BROKER_ID>,<BROKER_ID>  Isr: <BROKER_ID>,<BROKER_ID>,<BROKER_ID>
Topic: <TOPIC>  Partition: <ID>  Leader: <BROKER_ID>  Replicas: <BROKER_ID>,<BROKER_ID>,<BROKER_ID>  Isr: <BROKER_ID>,<BROKER_ID>
这里最重要的不是具体 Broker ID,而是比较同一分区在不同时间的 Replicas 与 Isr 数量和成员变化。例如副本始终为 3 个、ISR 从 3 个变成 2 个,说明至少有一个副本暂时不满足 ISR 条件;随后恢复到 3 个,才说明同步集合重新恢复。
把状态变化和指标放到同一时间轴
单看 ISR 容易把“副本问题”误判成“Broker 故障”。更可靠的方法是以故障时间点为中心,至少对比故障前、故障中和恢复后三个窗口:分区 Leader 是否变化、ISR 是否缩小、Broker 网络或磁盘是否出现异常,以及客户端请求延迟是否同步升高。
| 观察项 | 正常基线 | 异常信号 | 优先判断 |
|---|---|---|---|
| ISR 数量 | 接近 Replicas | 持续减少 | 副本同步异常或 Broker 压力 |
| Leader | 稳定 | 短时间频繁变化 | Broker 故障或网络抖动 |
| 副本追赶 | 延迟稳定 | 延迟持续扩大 | Follower 处理能力不足 |
| Broker 资源 | 波动可控 | 磁盘、网络、请求延迟同时升高 | 资源瓶颈可能参与故障 |
不要因为 ISR 曾短暂减少一次就立即定性为严重故障。一次状态抖动需要结合持续时间、受影响分区数量以及 Broker 指标判断;真正值得升级处理的是持续落后、反复进出 ISR 或多个分区同时发生异常。
形成可复用的对比基线
建议每次故障都记录相同的四类证据:分区元数据、ISR 变化、Broker 关键指标、事件时间戳。这样恢复后才能回答“是否真正恢复”,而不仅是“告警是否消失”。
最终判断标准是:副本状态恢复只是第一层,ISR 稳定、Broker 指标回归基线,并且异常不再重复出现,才说明同步故障基本闭环。