
消息队列 / 系统课时
建立故障处置手册
建立故障处置手册
本课把 Kafka 分区与副本故障整理成一份现场可直接执行的处置手册:先确认告警和影响范围,再固定证据、划定风险等级,随后按操作门禁恢复服务,最后完成数据与业务验收并沉淀复盘项。
学习目标
- 能把 Kafka 故障处置写成按顺序执行、按条件分支的操作流程。
- 能定义证据、风险分级和危险操作门禁,避免值班人员凭经验乱改配置。
- 能把恢复验收与复盘结果写成可以长期复用的治理标准。
手册的最小结构
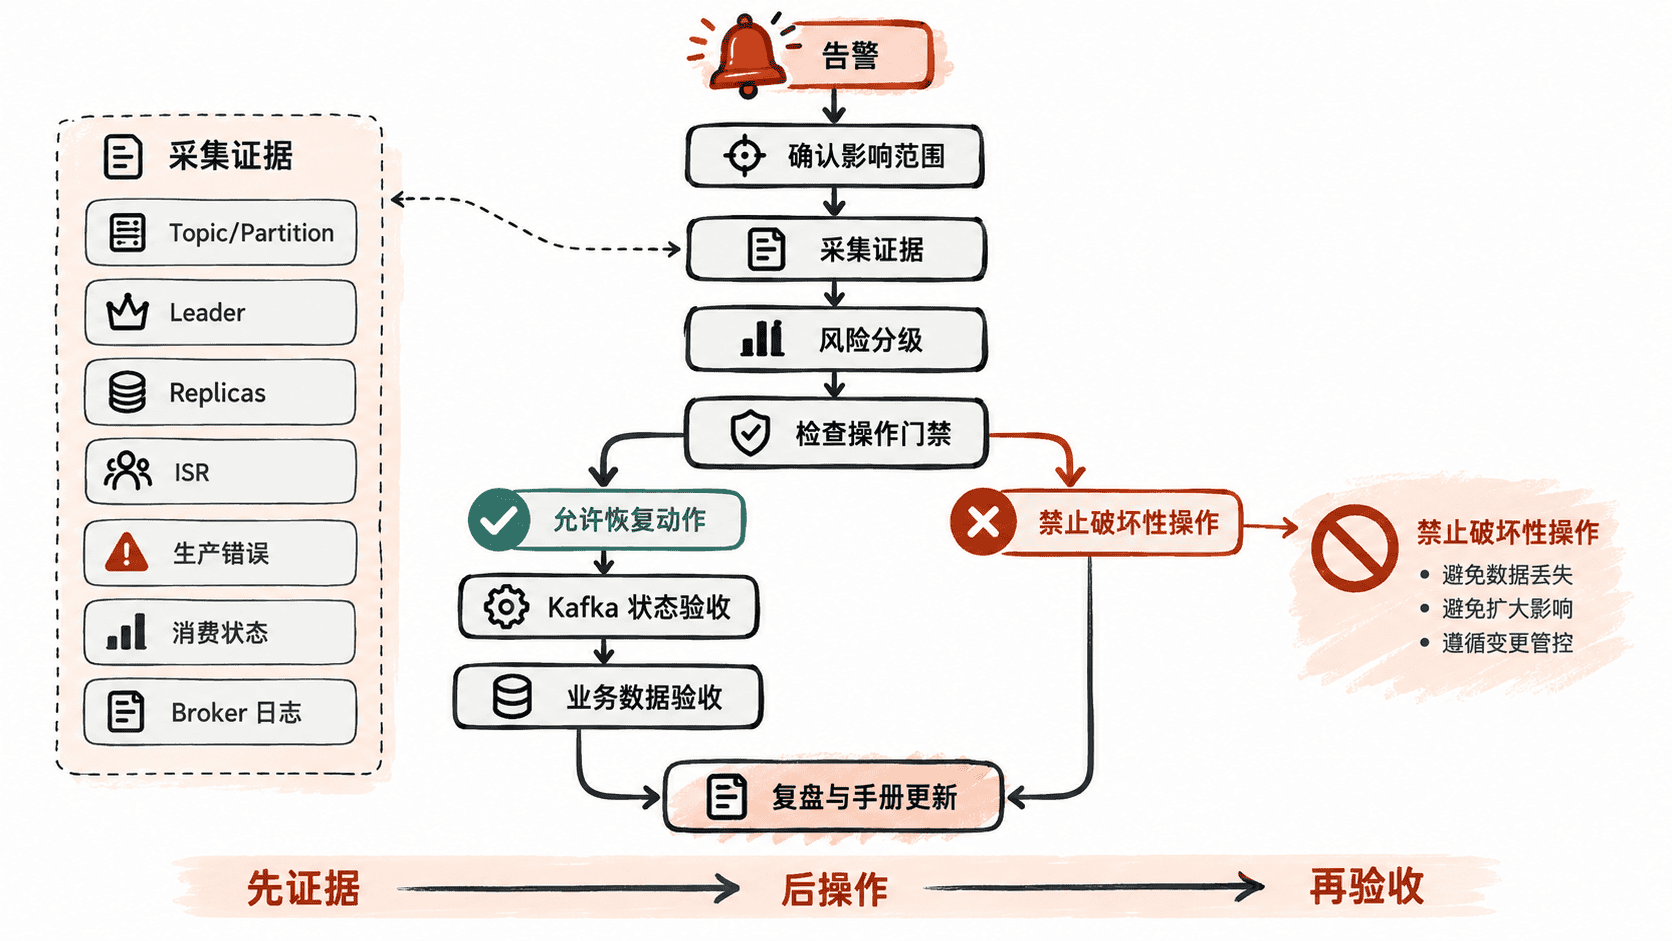
一份可执行手册至少要覆盖六段:告警确认、证据采集、风险分级、操作门禁、恢复验收、复盘。每一段都必须写清输入、判断条件和下一步动作,而不是只列出命令名称。
例如“分区不可用”不能直接写成“重启 Broker”。更合理的规则是先确认受影响分区、Leader、ISR 和副本集合,再判断是否仍有健康副本;只有在风险可控时才进入恢复动作。
告警与证据采集
告警阶段先回答“哪里坏了、影响多大、是不是正在扩大”。最小证据集包括目标 Topic 和 Partition、Leader、Replicas、ISR、相关 Broker 状态,以及生产端和消费端的异常时间窗口。
现场可以先用 Kafka Topic 描述信息建立基线:
bin/kafka-topics.sh --bootstrap-server <BOOTSTRAP> --describe --topic <TOPIC>预期输出
Topic: <TOPIC>  PartitionCount: <N>  ReplicationFactor: <N>
Topic: <TOPIC>  Partition: <ID>  Leader: <LEADER-ID>  Replicas: <BROKER-LIST>  Isr: <ISR-LIST>
然后补充消费者状态,确认故障究竟表现为消费停滞、积压增长还是只有部分分区受影响:
bin/kafka-consumer-groups.sh --bootstrap-server <BOOTSTRAP> --describe --group <GROUP>预期输出
GROUP  TOPIC  PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
<GROUP>  <TOPIC>  <ID>  <OFFSET>  <OFFSET>  <LAG>
实际现场还应保存 Broker 日志、控制器相关事件和业务错误日志,并统一记录 <TIME>,这样后续才能把 Kafka 状态变化与业务症状对齐。
风险分级与操作门禁
风险分级的目的不是给事故贴标签,而是决定“现在允许做什么”。可以采用三级判断:单分区局部不可用、多个分区或多个 Broker 同时受影响、存在潜在数据丢失或副本不一致风险。
低风险场景可以优先恢复已知故障的 Broker;中风险场景必须先评估剩余副本和集群容量,避免恢复动作造成级联压力;高风险场景禁止直接执行可能丢数据或改变副本语义的强制操作,应先保护现场并升级。
恢复验收与关闭条件
恢复动作完成后,按照“Kafka 状态 → 客户端 → 业务数据”的顺序验收。Kafka 层确认目标分区重新存在有效 Leader,ISR 状态回到预期范围;客户端层确认生产和消费错误停止;业务层确认关键数据没有遗漏或异常重复。
恢复验收不要只看进程是否存活。一个 Broker 进程恢复,并不代表目标分区已经完成选主,也不代表 ISR 已恢复,更不代表积压已经消化。因此每一层都应有明确的关闭条件。
建议把关键条件直接写入手册,例如:目标分区可服务、关键生产错误恢复正常、消费者 Lag 开始按预期下降、业务抽样核对通过。任一条件未满足,事故状态都不应标记为“完全恢复”。
复盘与持续更新
复盘要回答三个问题:为什么故障会发生、为什么现有告警没有更早阻止影响、为什么现场人员需要做某个高风险动作。不要把复盘写成“重启后恢复”这种结果描述。
每次事故至少沉淀一项可执行改进,例如增加分区不可用告警、补充副本健康检查、完善 Broker 下线门禁、增加业务数据验收脚本,或在手册中补充新的分支条件。
手册最终应当让值班人员在高压环境下仍能沿着固定顺序工作:先确认事实,再控制风险,随后恢复可用性,最后证明数据和业务都正常。能被照着执行并能在事故后持续更新,才是一份真正有效的 Kafka 故障治理手册。