
消息队列 / 系统课时
校验副本恢复结果
校验副本恢复结果
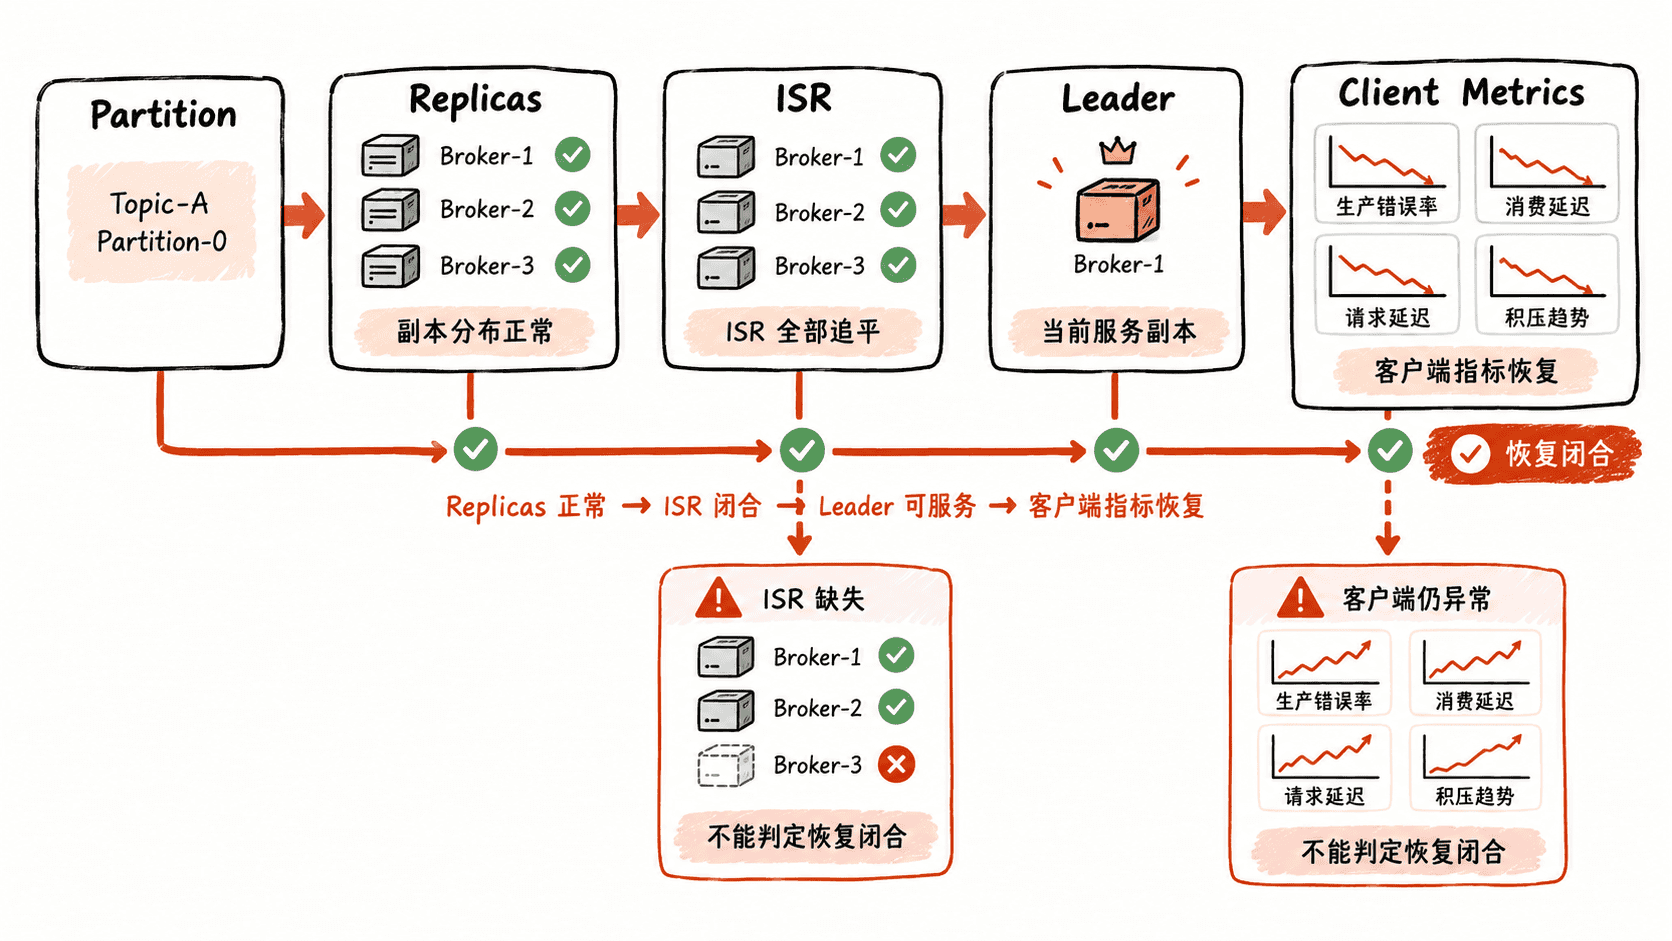
副本恢复完成不能只看 Broker 已启动或恢复命令已结束。真正的验收要确认受影响分区的副本分布正确、ISR 重新闭合、Leader 能稳定提供服务,并结合客户端错误率、延迟和消费积压判断故障是否真正结束。
学习目标
- 能从 Replicas、ISR 和 Leader 三个维度判断副本恢复是否闭合
- 能使用 Kafka 命令定位仍未恢复的分区
- 能把集群状态与客户端指标结合起来完成最终验收
检查分区副本状态
恢复后的第一项检查是受影响分区的 Replicas、ISR 和当前 Leader。正常情况下,重新上线并追平日志的副本会重新进入 ISR;在没有正在进行的重分配、缩容等操作时,目标分区的 ISR 应恢复到预期成员集合并保持稳定。
下面使用 Topic 描述命令检查待验收分区。执行前将 <IP>、<PORT> 和 <TOPIC> 替换为实际值。
kafka-topics.sh --bootstrap-server <IP>:<PORT> --describe --topic <TOPIC>预期结果
Topic: <TOPIC> Partition: <ID> Leader: <BROKER_ID> Replicas: <BROKER_A>,<BROKER_B>,<BROKER_C> Isr: <BROKER_A>,<BROKER_B>,<BROKER_C>实际 Broker ID 和分区数量可能不同。验收重点是 Replicas 是否符合预期副本分配,以及对应副本是否重新进入 Isr。如果 Replicas 中已有目标 Broker,但 Isr 仍缺少该 Broker,说明副本尚未追平,不能仅凭 Broker 已恢复就关闭故障。
确认状态已经稳定
单次 --describe 输出只能证明某一时刻的状态。恢复期间,副本可能短暂进入 ISR 后又因为网络、磁盘或复制延迟再次退出,因此应间隔观察多次,确认受影响分区的 ISR 不再反复收缩和扩张。
如果本次恢复同时执行过分区重分配,还要分别判断“重分配任务是否完成”和“最终副本状态是否稳定”。工具报告任务结束,并不等价于客户端延迟、Broker 资源和复制状态都已经恢复正常。
检查 Leader 与业务影响
副本恢复后不要求 Leader 一定切换到刚恢复的 Broker。除非治理目标明确包含首选 Leader 回迁或 Leader 均衡,否则更重要的是确认 Leader 属于有效 ISR、能够稳定处理请求,并且没有因恢复操作形成新的负载热点。
客户端侧至少应对照故障前基线观察生产请求错误、请求延迟、消费错误和消费积压。如果 ISR 已经闭合,但延迟仍持续偏高或积压没有回落,就应继续检查 Broker 磁盘与网络吞吐、Leader 分布以及客户端重试,而不能把恢复判定为完成。
识别尚未闭合的风险
可以按状态逐层收敛问题:Replicas 正确但 ISR 不完整,优先检查副本追赶、网络和磁盘;ISR 已完整但 Leader 服务或请求延迟异常,转向 Broker 资源与 Leader 负载;Kafka 集群状态正常但客户端仍报错,则继续检查连接、超时、重试和应用侧积压。
最终应保留一份恢复前后的对照记录,包括受影响分区、Replicas、ISR、Leader 以及客户端关键指标。这样既能证明副本恢复已经闭合,也能及时发现“Kafka 状态正常但业务性能尚未恢复”的残留风险。