
消息队列 / 系统课时
定位 Leader 选举异常
定位 Leader 选举异常
本课解决“客户端突然报错,但分区数据看似正常”这一类故障。你将从分区 Leader 变化入手,把选举时间窗口、Leader 所在 Broker 状态与客户端错误逐层对齐,判断问题是正常迁移、Broker 抖动,还是元数据刷新期间的短暂请求失败。
学习目标
- 能从 Topic 分区状态识别异常 Leader 迁移与 ISR 变化
- 能把客户端错误时间与 Leader 变化、Broker 状态建立可验证的时间关联
- 能按“分区 → Leader Broker → Broker 健康 → 客户端”顺序缩小故障范围
建立分区选举时间线
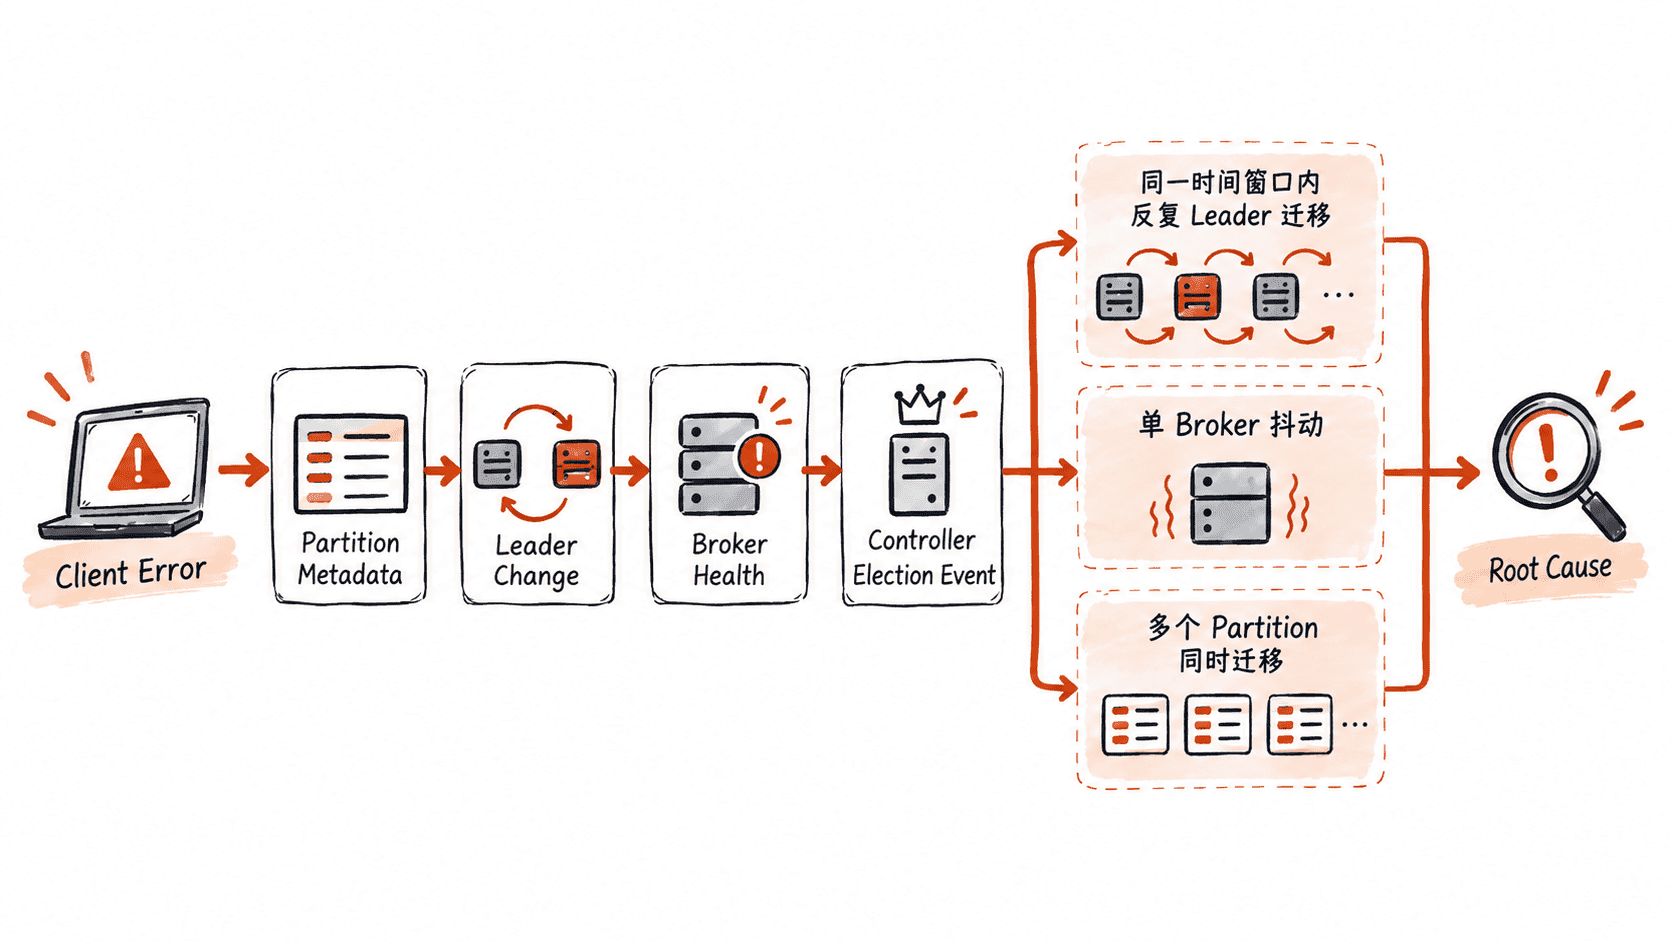
Leader 发生变化本身并不等于故障。Broker 重启、故障转移或计划内迁移都可能触发选举;真正需要警惕的是同一分区在短时间内反复迁移、较长时间没有可用 Leader,或大量分区在同一时间窗口一起变化。
一次 describe 只能说明当前状态,因此应在客户端报错时间 <TIME> 前后连续采样同一 Topic,并同时观察 Leader、Replicas 与 Isr。下面的主示例每隔 5 秒采样一次,用时间戳把结果放进同一条证据链。
for i in 1 2; do
  date '+%Y-%m-%dT%H:%M:%S%z'
  kafka-topics.sh --bootstrap-server <BROKER> --describe --topic <TOPIC>
  sleep 5
done
预期结果
<TIME>
Topic: <TOPIC>  Partition: 0  Leader: 2  Replicas: 2,3,4  Isr: 2,3,4
<TIME>
Topic: <TOPIC>  Partition: 0  Leader: 3  Replicas: 2,3,4  Isr: 3,2,4
Leader 是当前处理该分区读写请求的 Broker,Replicas 是副本分布,Isr 是仍与 Leader 保持足够同步的副本集合。实际 Broker 编号和 ISR 顺序可能不同;若后续采样又回到 Broker 2,可以确认同一 Partition 存在重复迁移,但“迁移与客户端报错同时发生”仍只是相关性。
区分分区异常与 Broker 异常
如果只有少量分区反复换 Leader,并且这些分区集中涉及同一个 Broker,应优先检查该 Broker 的进程重启、网络抖动、磁盘延迟和连接可达性。若多个 Broker 上的大量无关分区同时迁移,则应扩大到集群级网络或控制面事件。
可先用 Broker API 探测确认客户端是否能稳定访问集群节点,再结合 Broker 日志和监控核对重启、心跳或 I/O 异常。
kafka-broker-api-versions.sh --bootstrap-server <BROKER>预期结果
<HOST>:<PORT> (id: <ID> rack: <VALUE>) -> (
  Produce(0): <VALUE>,
  Fetch(1): <VALUE>
)
具体字段随 Kafka 版本和集群节点不同。某个 Broker 能返回 API 信息,只能证明该时刻连接和协议探测成功,不能替代进程重启、网络丢包、磁盘延迟等监控证据。
正确解释客户端错误
NotLeaderOrFollower 和 LeaderNotAvailable 都不能单独证明“Broker 挂了”或“Leader 在抖动”。前者常见于请求仍发往已经失去相应分区角色的 Broker,或客户端缓存的元数据与 Broker 当前角色不一致;后者表示当时没有可用 Leader,常见于 Leader 选举尚未完成的窗口。
因此根因证据至少应同时对齐三个维度:客户端错误与分区变化处于同一时间窗口;受影响 Topic/Partition 范围一致;对应 Broker 的日志、监控或可达性证据能够解释这次变化。只有错误码与 Leader 变化同时出现,最多说明需要继续追查,不能替代根因证据。
从客户端范围反推故障边界
消费端可以补充查看分区分配和消费进度,确认问题是局部分区还是整个消费组。
kafka-consumer-groups.sh --bootstrap-server <BROKER> --describe --group <GROUP>预期结果
GROUP    TOPIC    PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG  CONSUMER-ID
<GROUP>  <TOPIC>  0          1250            1260            10   <CONSUMER-ID>
如果错误只集中在发生 Leader 变化的少数分区,而其他分区仍能正常消费,应先按“局部分区请求异常”处理;如果大量无关分区同时受影响,则继续检查 Broker 或集群级事件。Consumer Group 仍有成员也不能排除分区或 Broker 层故障。
确认同一批分区反复换 Leader 后,不要先用手工选举“把状态改正常”。应先锁定相关 Broker,核对重启、网络、磁盘和时间线;根因未消除时,额外选举只会制造更多元数据变化。最终应形成完整证据链:哪个分区何时变化、Leader 落到哪个 Broker、Broker 当时是否异常,以及客户端错误是否与这些事实严格对应。