
消息队列 / 系统课时
演练 Broker 突然故障
演练 Broker 突然故障
本课通过受控方式让一个 Broker 突然失联,观察分区 Leader、ISR 与客户端的变化,并按“记录基线、注入故障、保留证据、验证选举、恢复副本、业务验收”的顺序完成一次完整演练。重点不是制造故障,而是验证故障发生后能否用证据判断可用性与恢复进度。
学习目标
- 能用分区状态判断 Broker 故障后的 Leader 与 ISR 变化
- 能按固定顺序完成故障注入、定位、恢复与副本追平验证
- 能区分控制面恢复、数据面恢复和业务面验收
演练场景与基线
假设 orders 主题的副本分布在 Broker 1、2、3 上,计划让 Broker 1 暂时失联。故障前先记录目标 Broker、受影响分区、当前 Leader 与 ISR;没有这份基线,故障后很难判断哪些变化由本次演练引起。
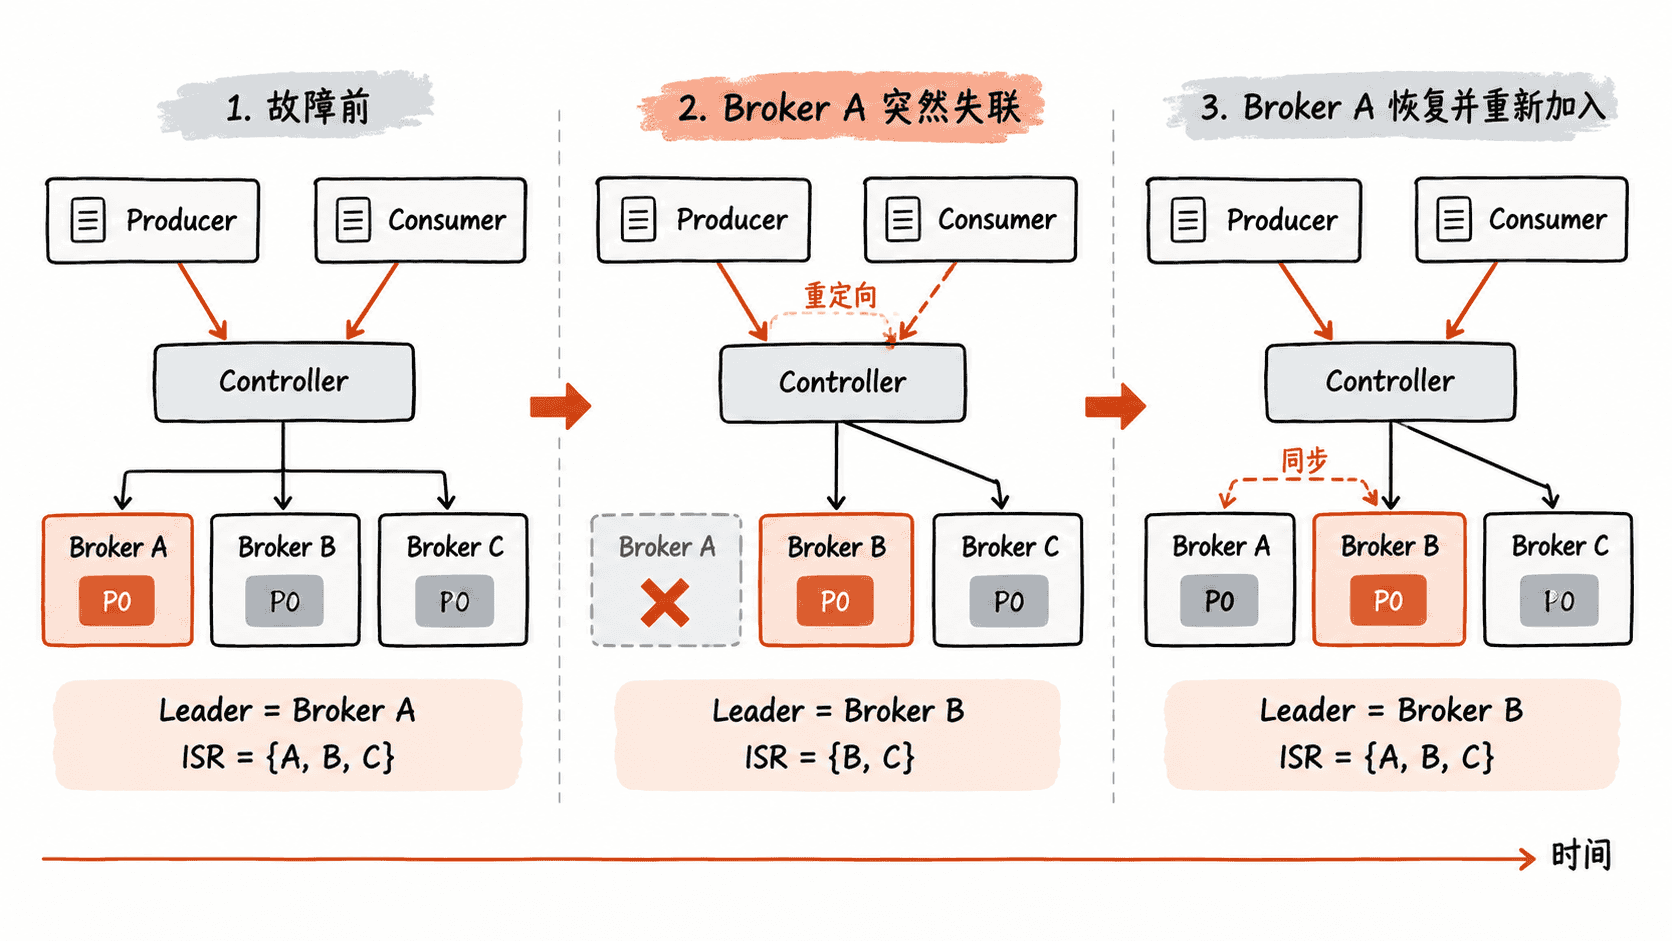
在故障前、故障后和 Broker 恢复追平后三个检查点,分别执行同一条分区状态命令。将 <IP>、<PORT> 替换为实际可访问的 Broker 地址;每次执行只反映当时状态,下面的三组输出是三个检查点的示例。
bin/kafka-topics.sh --bootstrap-server <IP>:<PORT> --describe --topic orders预期结果
# 检查点 1:故障前
Topic: orders  Partition: 0  Leader: 1  Replicas: 1,2,3  Isr: 1,2,3
Topic: orders  Partition: 1  Leader: 2  Replicas: 2,3,1  Isr: 2,3,1

# 检查点 2:Broker 1 失联后
Topic: orders  Partition: 0  Leader: 2  Replicas: 1,2,3  Isr: 2,3
Topic: orders  Partition: 1  Leader: 2  Replicas: 2,3,1  Isr: 2,3

# 检查点 3:Broker 1 恢复并追平后
Topic: orders  Partition: 0  Leader: 2  Replicas: 1,2,3  Isr: 2,3,1
Topic: orders  Partition: 1  Leader: 2  Replicas: 2,3,1  Isr: 2,3,1
实际 Leader、Broker 编号、分区数量和字段排列可能不同。关键不是编号是否一致,而是确认故障 Broker 退出 ISR、受影响分区是否由仍在 ISR 中的副本接任 Leader,以及恢复后该 Broker 是否重新进入 ISR。
注入故障并保留现场
确认目标 Broker 后,再通过实验环境允许的方式让它进入不可用状态,例如停止该节点上的 Kafka 进程,或使用经过审批的网络故障注入手段隔离该节点。生产演练必须事先限定范围、回退条件和最大持续时间,避免把演练变成不可控事故。
故障发生后不要立即重启所有 Broker。先记录故障时间、目标 Broker、客户端首个异常时间,并重新执行分区状态检查。若一开始就恢复节点,Leader 切换、ISR 收缩和客户端重试等关键证据可能很快消失,后续只能依赖不完整日志猜测发生了什么。
按证据顺序定位
先确认 Broker 是否真的失联,而不是仅看到生产者或消费者报错。随后检查受影响分区:正常情况下,若仍有可用 ISR 副本,控制器会为失去 Leader 的分区选择新的 Leader;原故障 Broker 会暂时退出相关 ISR。若没有可选的同步副本,分区可能保持不可用,此时不能把客户端超时简单归因于“重试还没结束”。
接着观察客户端。生产者应在元数据刷新后逐步恢复发送,消费者应重新连接并继续推进消费位点。若 Leader 已完成切换但客户端持续超时,应继续检查网络连通性、认证授权、客户端重试配置和剩余 Broker 负载,而不是直接宣布集群已恢复。
恢复 Broker 并验证追平
现场证据保留完成后再恢复目标 Broker。Broker 重新加入集群后,其副本需要从当前 Leader 继续复制缺失日志;只有追到满足同步条件后,才会重新进入 ISR。这个过程受积压量、磁盘 I/O、网络吞吐和 Leader 负载影响,不应预设固定秒数。
验证时重点看两个结果:第一,Broker 已重新加入且相关副本持续追平;第二,ISR 最终恢复到预期副本集合。Broker 恢复后 Leader 不一定自动切回原节点,因此“Leader 仍是 2、ISR 已恢复为 1,2,3”可以是正常结果。若 Broker 已在线但长时间不回 ISR,应继续检查副本复制、磁盘、网络和日志错误。
业务验收与演练记录
最后分别完成三层验收:控制面确认 Leader 与 ISR 稳定;数据面确认副本重新同步且没有持续欠副本;业务面确认生产持续成功、消费位点继续推进,并检查是否存在异常重试、长时间堆积或超出业务容忍范围的重复处理。
演练记录至少保留故障注入时间、受影响分区、Leader/ISR 变化、客户端异常与恢复时间、Broker 重新入 ISR 的时间,以及最终业务验收结果。这样复盘时才能把“发现慢、选举慢、追平慢或客户端恢复慢”区分开,并据此调整告警门槛和故障处置顺序。