
消息队列 / 系统课时
排查 ISR 持续缩小
排查 ISR 持续缩小
本课解决副本持续退出 ISR、恢复后又反复掉出的定位问题。核心不是固定按“网络、磁盘、负载”逐项猜测,而是先证明 ISR 变化和副本滞后是否持续,再把异常精确关联到 Broker 的资源与配置,形成可验证的证据链。
学习目标
- 能连续确认 ISR 缩小是否具有持续性和集中性
- 能用
IsrShrinksPerSec、IsrExpandsPerSec、MaxLag与ConsumerLag量化副本跟随状态 - 能把副本滞后与 Broker 的网络、磁盘、负载和复制配置关联起来定位根因
先确认 ISR 变化是否持续
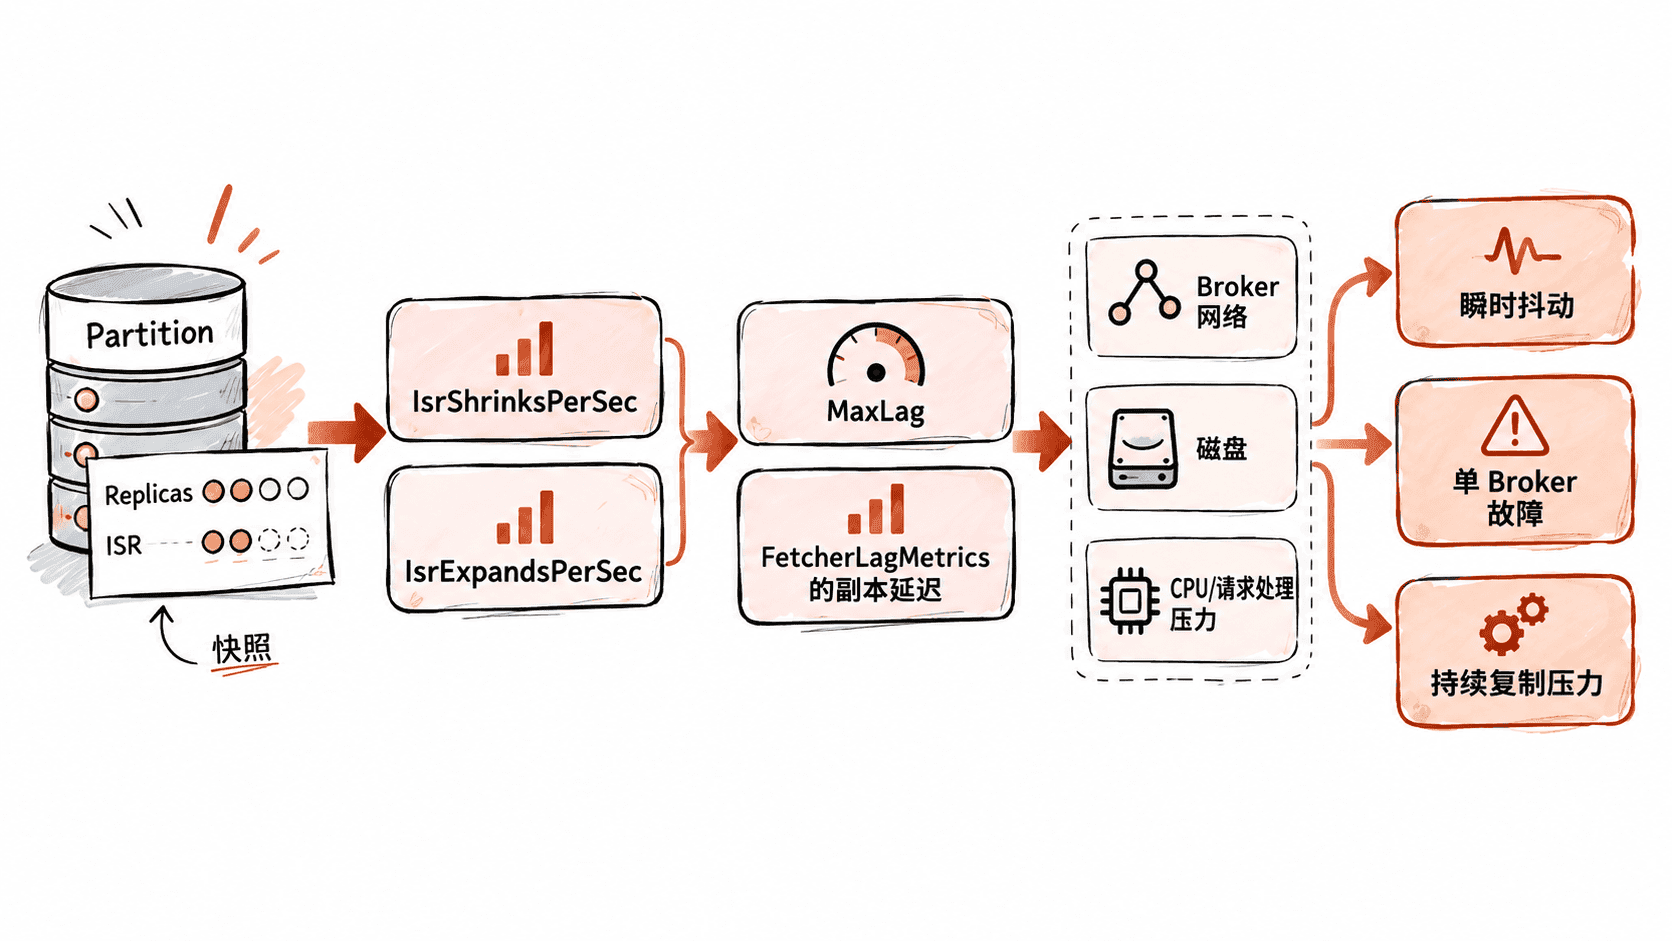
ISR 是当前仍能按要求跟随 Leader 的副本集合。一次 kafka-topics.sh --describe 只能给出快照,因此排查时应连续采样同一批分区,并记录哪些 Broker 反复从 ISR 中消失。
bin/kafka-topics.sh --bootstrap-server <BROKER> --describe --topic <TOPIC>预期结果:
Topic: <TOPIC> Partition: 2 Leader: 1 Replicas: 1,2,3 Isr: 1,3这个结果只说明 Broker 2 当前不在 ISR,不能单独证明根因。若连续采样出现 1,2,3 → 1,3 → 1 → 1,3,说明问题持续存在;若很快恢复并长期稳定,则更像瞬时抖动。还要观察问题是否集中在同一个 Broker,还是同时分散到多个 Broker。
用 Kafka 指标量化副本滞后
不要把“网络 → 磁盘 → 负载 → 复制延迟”当成固定通用顺序。更可靠的顺序是:先确认 ISR 是否持续变化,再量化 Follower 到 Leader 的复制滞后,最后根据受影响 Broker 回溯资源和配置。这样先证明“副本确实追不上”,再解释“为什么追不上”。
Kafka Broker 常用的相关 JMX 指标如下:
kafka.server:type=ReplicaManager,name=IsrShrinksPerSec
kafka.server:type=ReplicaManager,name=IsrExpandsPerSec
kafka.server:type=ReplicaFetcherManager,name=MaxLag,clientId=Replica
kafka.server:type=FetcherLagMetrics,name=ConsumerLag,clientId=<CLIENT_ID>,topic=<TOPIC>,partition=<PARTITION>其中,IsrShrinksPerSec 和 IsrExpandsPerSec 用来判断 ISR 是否在反复收缩和扩展;MaxLag 用来观察副本抓取器的最大消息滞后;ConsumerLag 可以下钻到具体 Follower、Topic 和 Partition。MaxLag 与 ConsumerLag 衡量的是消息或 offset 差距,不是毫秒延迟,不能直接解释为“慢了多少秒”。
判断时应关注趋势而不是单点值:如果 ISR 持续收缩,同时 MaxLag 或对应分区的 ConsumerLag 持续上升或长时间不回落,就能证明 Follower 的追赶能力不足;若 lag 很快回到正常水平,并伴随 ISR 扩展,则更符合短暂抖动。
按受影响 Broker 回溯资源证据
确认具体 Follower 的 lag 持续扩大后,再检查资源。若多个无关 Topic 的分区都集中从同一个 Broker 的 ISR 中退出,优先检查该 Broker 的磁盘、网络和请求处理能力;若多个 Broker 同时出现,则应提高对共享网络、存储或集群级流量压力的关注。
iostat -xz 1 3
ss -s
预期结果:
Device ... await ... aqu-sz ... %util
<DEVICE> ... <VALUE> ... <VALUE> ... <VALUE>

Total: <VALUE>
TCP:   <VALUE>
实际字段和值会因操作系统和工具版本不同而变化。这里要看的是故障时间窗口内是否出现磁盘等待和队列持续升高、设备利用率接近饱和、TCP 连接或重传等网络异常,并把这些现象与同一时间段的 ConsumerLag、MaxLag、ISR shrink/expand 和 Broker 日志对齐。系统指标只能提供相关证据,不能单独证明 Kafka 掉出 ISR 的原因。
检查长期追不上的配置与容量边界
如果 lag 长时间不能下降,还要检查复制参数与 Broker 容量是否匹配。replica.lag.time.max.ms 决定 Follower 多久没有及时从 Leader 获取数据后会被移出 ISR;replica.fetch.wait.max.ms 不应大于它,否则在低吞吐场景下也可能增加副本被误判为落后的风险。
配置之外,还应比较故障前后的变化:CPU 或请求处理线程是否持续繁忙、磁盘写入是否接近瓶颈、网络吞吐是否接近上限,以及这些变化是否与具体分区的 ConsumerLag 同时发生。只有时间窗口和影响范围都能对上,才应把 ISR 缩小归因到某个资源或容量问题。
区分抖动、单 Broker 故障与持续复制压力
可以用“ISR 变化 + lag 趋势 + 影响范围”完成分类判断:
- ISR 短暂缩小后迅速恢复,lag 也快速回落:更像瞬时抖动。
- 同一 Broker 上多个无关分区反复退出 ISR,且该 Broker 的 lag 持续偏高:更像单 Broker 故障或局部资源瓶颈。
- 多个 Broker、多个 Topic 同时出现 lag 扩大和 ISR 收缩:优先排查共享网络、存储或集群级复制压力。
最终证据链应是:哪些分区持续缩小 → 哪些 Broker 集中受影响 → IsrShrinksPerSec/IsrExpandsPerSec 是否反复变化 → MaxLag/ConsumerLag 是否持续扩大 → 同一时间窗口有哪些资源、日志或配置异常。闭环后再决定恢复 Broker、降低流量、迁移副本还是扩容,而不是把“ISR 缩小”本身当成根因。