
消息队列 / 系统课时
建立故障恢复验收
建立故障恢复验收
本课把“故障看起来结束了”变成可执行的恢复验收。你将把副本健康、分区可用、客户端成功率和资源压力组合成同一套门禁,避免只因为服务暂时可访问就过早结束故障处置。
学习目标
- 能建立覆盖副本、分区、客户端和资源的恢复验收条件
- 能区分“可以继续观察”和“可以正式结束故障处置”
- 能用统一的验收顺序减少漏项与过早收尾
把恢复从单一指标改成四类证据
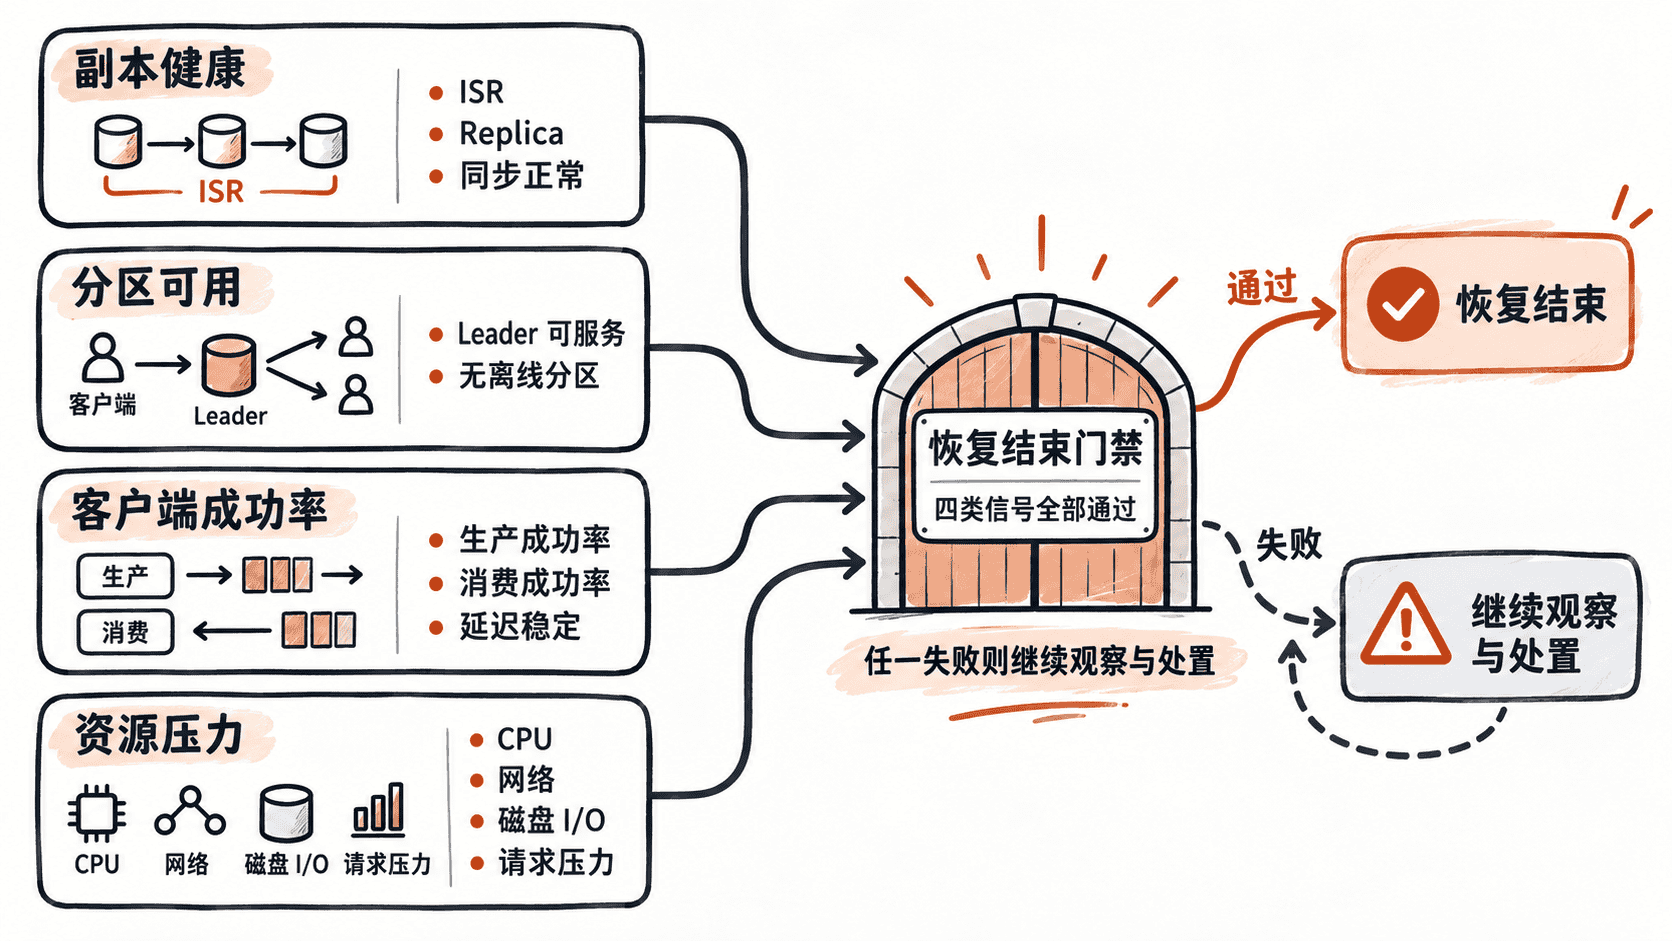
Kafka 恢复验收至少需要四类证据。副本健康确认分区副本没有持续缺口;分区可用确认业务分区能够正常选出 Leader 并提供服务;客户端成功率确认生产和消费链路真实恢复;资源压力确认 Broker 没有因为副本追赶、Leader 调整或流量回迁继续处于高压状态。
这四类证据回答的是不同问题:Kafka 内部是否健康、分区是否可服务、业务请求是否成功,以及集群能否稳定维持当前状态。只通过其中一两项,都不足以判定故障已经结束。
先验证集群内部状态
先检查分区描述结果,确认恢复没有留下明显的 Leader 或副本同步缺口。对关键 Topic 逐个检查,不要只因为一个分区正常就推断整个 Topic 已恢复。
bin/kafka-topics.sh --bootstrap-server <IP>:<PORT> --describe --topic orders预期结果:关键分区均有有效 Leader,并且在故障恢复完成、没有计划内副本迁移的情况下,ISR 已恢复到预期副本集合。实际 Broker ID 和分区数量可能不同。
Topic: orders  Partition: 0  Leader: 2  Replicas: 2,1,3  Isr: 2,1,3
Topic: orders  Partition: 1  Leader: 1  Replicas: 1,3,2  Isr: 1,3,2
验收时重点确认没有 Leader: -1,关键分区的 ISR 不再持续缺失副本,也没有异常反复缩减。一次命令只能证明“此刻的内部状态”,故障结束判定还必须继续核对客户端和资源趋势。
再验证客户端真的恢复
集群内部状态正常,不代表业务一定正常。生产端可能仍有发送失败、超时或重试堆积;消费端也可能继续停顿,或者消费延迟仍在扩大。因此客户端验收必须同时观察生产成功率、错误率、关键请求延迟以及消费进度。
与故障前基线比较时,不要只看某一个瞬时点。至少确认三件事:生产成功率和错误率已回到既定 SLO 或故障前正常区间;关键业务延迟已经回落且不再持续恶化;消费端能够持续推进,积压不再增长,并按预期向正常水平收敛。如果历史基线与当前业务量差异较大,应优先使用对应时段、相近流量下的基线或正式 SLO,而不是机械比较绝对数值。
这些条件还需要在有代表性的观察窗口内保持稳定。窗口可以覆盖一次典型流量波动或关键业务周期,具体长度由已有 SLO、业务节奏和故障影响范围决定;只有短暂恢复几分钟后又出现错误率反弹、重试增加或消费积压重新上升,都不能算客户端验收通过。
最后检查资源是否能稳住
副本重新同步、Leader 调整和客户端重试都会制造额外压力。即使错误率已经下降,也应确认 CPU、网络吞吐、磁盘 I/O、请求延迟和未完成请求等指标没有持续向坏的方向发展,并观察副本追赶完成后资源是否逐步回落。
用门禁决定是否结束故障处置
最终可以把验收写成四道门:副本健康通过、分区可用通过、客户端业务通过、资源压力稳定。只有四道门同时通过,并在约定观察窗口内没有反复,才进入正式收尾;任意一道未通过,都应继续保留故障状态,记录缺口和下一次复查条件。
线上应急还应保存本次验收证据,例如执行时间、关键 Topic、分区描述结果、生产成功率与错误率、消费积压、关键延迟以及资源指标区间。这样后续再次异常时,才能判断问题是恢复后反复,还是第一次验收就没有真正通过。
恢复验收的目标不是证明“系统现在没报错”,而是证明 Kafka 内部状态、真实业务链路和资源余量都已经恢复到可持续承载业务的状态。