
消息队列 / 系统课时
演练分区不可用事故
演练分区不可用事故
本课在隔离实验环境中主动制造目标分区暂时没有可用 Leader 的事故,完整演练现场取证、故障注入、止损恢复和数据验收,并建立“先确认副本状态,再恢复原副本,最后验证业务数据”的处置顺序。
学习目标
- 能区分分区不可用与普通消费延迟,并确认目标分区的 Leader、Replicas 和 ISR。
- 能以可复现、可回滚的方式停止目标分区全部副本,制造无可用 Leader 场景。
- 能结合 Kafka 分区状态与业务消息结果判断恢复是否真正完成。
事故场景与演练边界
选择非核心实验 Topic 的一个分区作为故障对象。主示例假设该分区的三个副本分别位于 broker-1、broker-2、broker-3,另有 broker-admin 保持在线,用于查询集群元数据。实际执行前必须确认这些 Broker 与真实副本分配一致。
如果集群采用 KRaft,并且 Broker 同时承担 Controller 角色,还要确保停止目标副本 Broker 后仍保留 Controller 多数派。演练目标只是让一个分区失去在线副本,不能顺带破坏控制器仲裁或让整个集群失联。
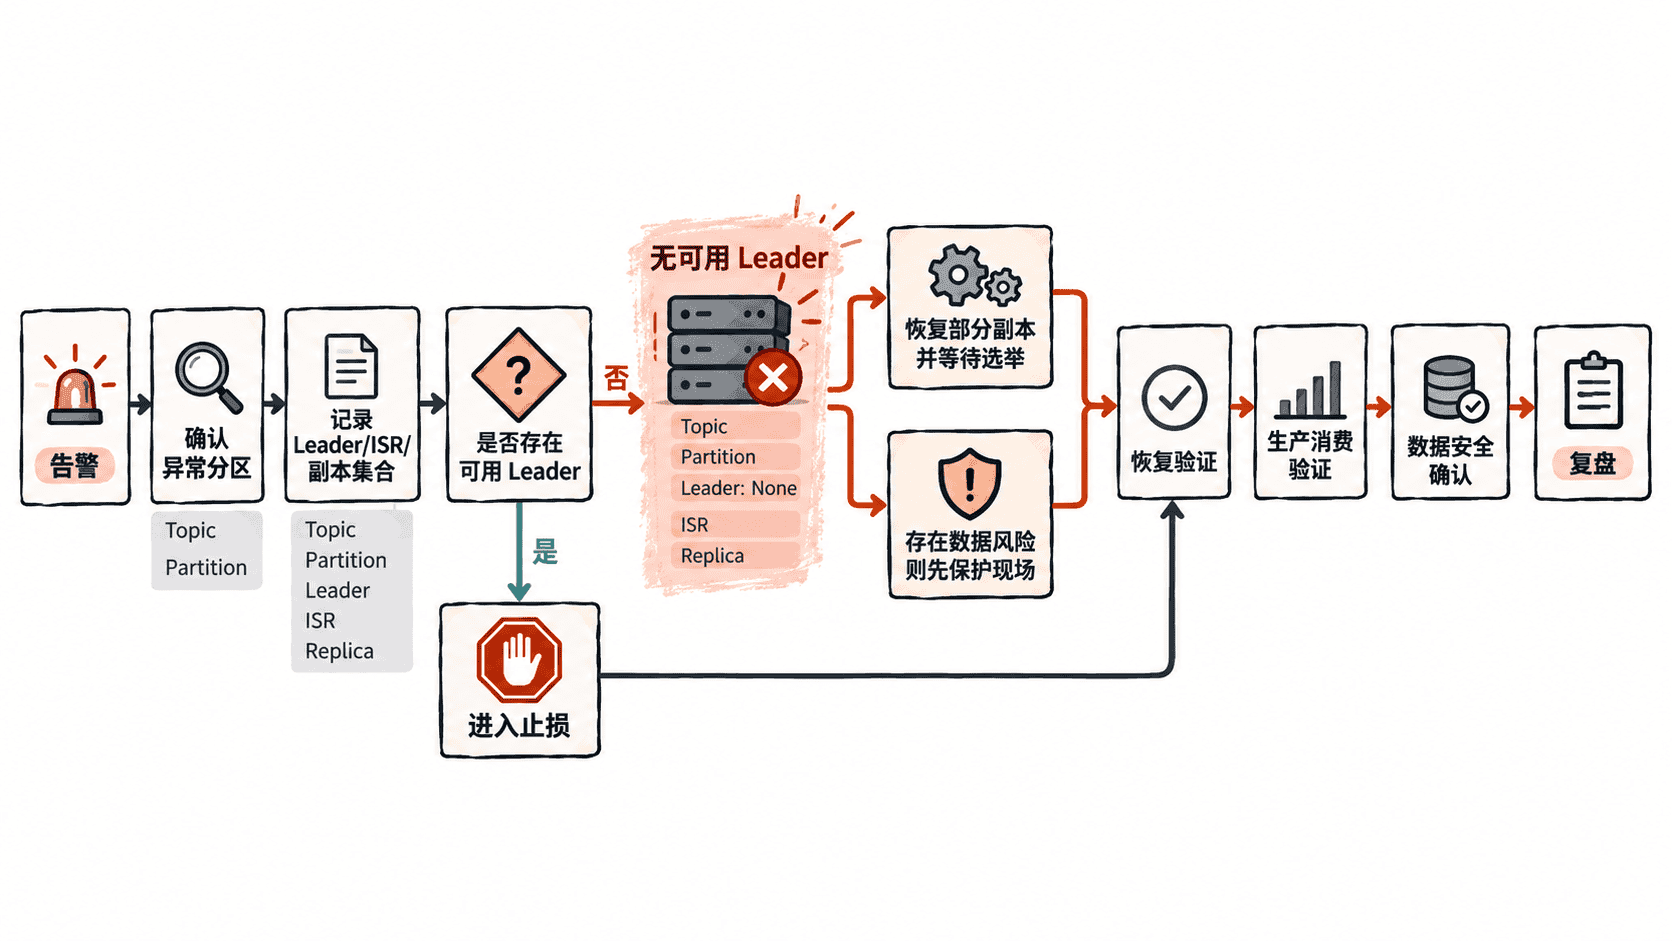
采集现场并确认故障对象
先从仍在线的 Broker 查询目标 Topic,记录目标分区的 Leader、Replicas 和 ISR。普通消费延迟通常仍有可用 Leader;分区不可用则会在元数据层直接表现为没有可服务 Leader,因此不能只依据消费积压判断事故类型。
ADMIN_BROKER="<ADMIN-BROKER>"
PORT="<PORT>"
TOPIC="<TOPIC>"

bin/kafka-topics.sh \
  --bootstrap-server "${ADMIN_BROKER}:${PORT}" \
  --describe \
  --topic "${TOPIC}"
预期输出
Topic: <TOPIC>  PartitionCount: <N>  ReplicationFactor: 3
Topic: <TOPIC>  Partition: <ID>  Leader: <LEADER-ID>  Replicas: <BROKER-A>,<BROKER-B>,<BROKER-C>  Isr: <ISR-LIST>
确认目标分区的 Replicas 正好对应计划停止的三个 Broker,并确认管理入口不属于这组副本。<PORT>、<ID>、Broker ID 等值以实际环境为准。
注入无可用 Leader 故障
在 Docker Compose 实验环境中,同时停止承载目标分区全部副本的三个 Broker。这是本课的核心故障注入动作:磁盘数据仍保留,但目标分区暂时没有任何在线副本能够担任 Leader。
docker compose stop broker-1 broker-2 broker-3
docker compose ps -a broker-1 broker-2 broker-3
预期结果
NAME       STATUS
broker-1   Exited (<VALUE>)
broker-2   Exited (<VALUE>)
broker-3   Exited (<VALUE>)
Compose 版本不同,表头和退出码显示可能不同;验收重点是三个目标服务均已停止。随后从仍在线的管理 Broker 再次查询分区状态。
ADMIN_BROKER="<ADMIN-BROKER>"
PORT="<PORT>"
TOPIC="<TOPIC>"

bin/kafka-topics.sh \
  --bootstrap-server "${ADMIN_BROKER}:${PORT}" \
  --describe \
  --topic "${TOPIC}"
预期输出
Topic: <TOPIC> Partition: <ID> Leader: none Replicas: <BROKER-A>,<BROKER-B>,<BROKER-C> Isr:不同 Kafka 版本可能把无 Leader 显示为 none 或 -1。只要目标分区没有有效 Leader,就说明故障已经成功注入。此时生产请求可能超时或返回与 Leader 不可用相关的错误,消费者也无法继续从该分区正常拉取数据。
恢复原副本并观察选主
恢复时优先启动原有副本,不立即执行副本重分配,也不要为了快速恢复而启用可能牺牲数据一致性的非同步副本选主。原副本上线后,等待 Broker 重新注册并观察目标分区是否选出 Leader、ISR 是否逐步恢复。
docker compose start broker-1 broker-2 broker-3
docker compose ps broker-1 broker-2 broker-3
预期结果
NAME       STATUS
broker-1   Up <TIME>
broker-2   Up <TIME>
broker-3   Up <TIME>
确认三个 Broker 已运行后,再查询 Kafka 元数据。启动完成与重新选主并非严格同时发生,因此短暂看到 ISR 未完全恢复并不代表恢复失败。
ADMIN_BROKER="<ADMIN-BROKER>"
PORT="<PORT>"
TOPIC="<TOPIC>"

bin/kafka-topics.sh \
  --bootstrap-server "${ADMIN_BROKER}:${PORT}" \
  --describe \
  --topic "${TOPIC}"
预期输出
Topic: <TOPIC> Partition: <ID> Leader: <LEADER-ID> Replicas: <BROKER-A>,<BROKER-B>,<BROKER-C> Isr: <BROKER-A>,<BROKER-B>,<BROKER-C>恢复验收不要求 Leader 必须回到原来的 Broker。关键条件是目标分区重新出现有效 Leader,并且 ISR 最终与健康在线副本状态一致。如果长时间仍无 Leader,应继续检查 Broker 日志、磁盘、网络以及 Controller 状态,而不是先归因于生产者或消费者。
数据安全验收
Kafka 元数据恢复只能证明分区重新可服务,不能单独证明演练窗口内的业务消息没有遗漏。生产端应核对发送确认、超时和重试记录;消费端应确认目标分区的消费位置重新推进,并依据业务唯一标识检查重复处理和遗漏。
最后保存故障前、故障中、恢复后的三份分区状态及业务验证结果。一次合格的演练应能明确回答:目标分区为什么失去 Leader、哪一步恢复了可服务副本,以及恢复后有哪些 Kafka 与业务证据能够证明数据仍然可信。