
消息队列 / 系统课时
定位分区不可用
定位分区不可用
本课解决“生产失败、消费中断或客户端拿不到有效元数据”时,如何快速判断到底是单个分区不可用、某个 Broker 故障,还是更大范围的集群问题。最终要形成一条从客户端现象反查到 Partition、Leader 和 Broker 的定位路径,而不是停留在错误日志表面。
学习目标
- 能从 Topic 分区描述判断是否存在不可用分区
- 能区分单分区故障、单 Broker 故障与集群级异常
- 能把生产、消费和元数据错误映射回具体分区状态
先确认分区是否真的不可用
“生产失败”本身不能证明分区已经不可用。客户端可能因为元数据过期、网络不可达、请求超时等原因失败,因此第一步必须直接检查分区状态。
使用 Topic 描述查看 Leader、Replicas 和 ISR。重点关注 Leader 是否缺失,以及 ISR 是否明显缩小。
kafka-topics.sh --bootstrap-server <BROKER> --describe --topic <TOPIC>预期结果
Topic: <TOPIC>  Partition: 0  Leader: 2   Replicas: 2,3,4  Isr: 2,3,4
Topic: <TOPIC>  Partition: 1  Leader: -1  Replicas: 3,4,2  Isr: 3,4
Topic: <TOPIC>  Partition: 2  Leader: 4   Replicas: 4,2,3  Isr: 4,2,3
其中 Leader: -1 是非常重要的现场信号:该分区当前没有可用 Leader,因此依赖该分区的读写请求无法按正常路径完成。相比之下,ISR 缩小但仍存在有效 Leader,说明分区可能处于降级状态,但不一定已经完全不可用。
从生产失败反查具体 Partition
生产端最有价值的信息不是“发送失败”,而是 Topic、Partition 以及错误发生的时间。先拿到失败分区,再回查对应分区描述,比从整个集群日志里盲目搜索效率高得多。
例如现场可以先做一次最小检查:
kafka-topics.sh --bootstrap-server <BROKER> --describe --topic <TOPIC>
kafka-consumer-groups.sh --bootstrap-server <BROKER> --describe --group <GROUP>
预期结果
Topic: <TOPIC>  Partition: 1  Leader: -1  Replicas: 3,4,2  Isr: 3,4

GROUP   TOPIC    PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG  CONSUMER-ID
<GROUP> <TOPIC>  0          1250            1260            10   <CONSUMER-ID>
<GROUP> <TOPIC>  1          980             980             0    -
如果故障客户端明确指向 Partition 1,同时该分区 Leader: -1,两者已经形成直接证据链。消费端如果也在同一分区失去正常处理,则更能说明根因位于分区可用性,而不是单纯的生产客户端问题。
区分单分区、Broker 和集群级问题
判断范围时,先看“受影响分区集合”,再看“这些分区的副本和 Broker 是否重合”。单分区异常通常表现为一个或少量分区失去 Leader;如果多个异常分区的副本大量集中在同一个 Broker,则应优先检查该 Broker;如果大量分区跨多个 Broker 同时不可用,则需要扩大到集群级网络、控制面或多 Broker 故障。
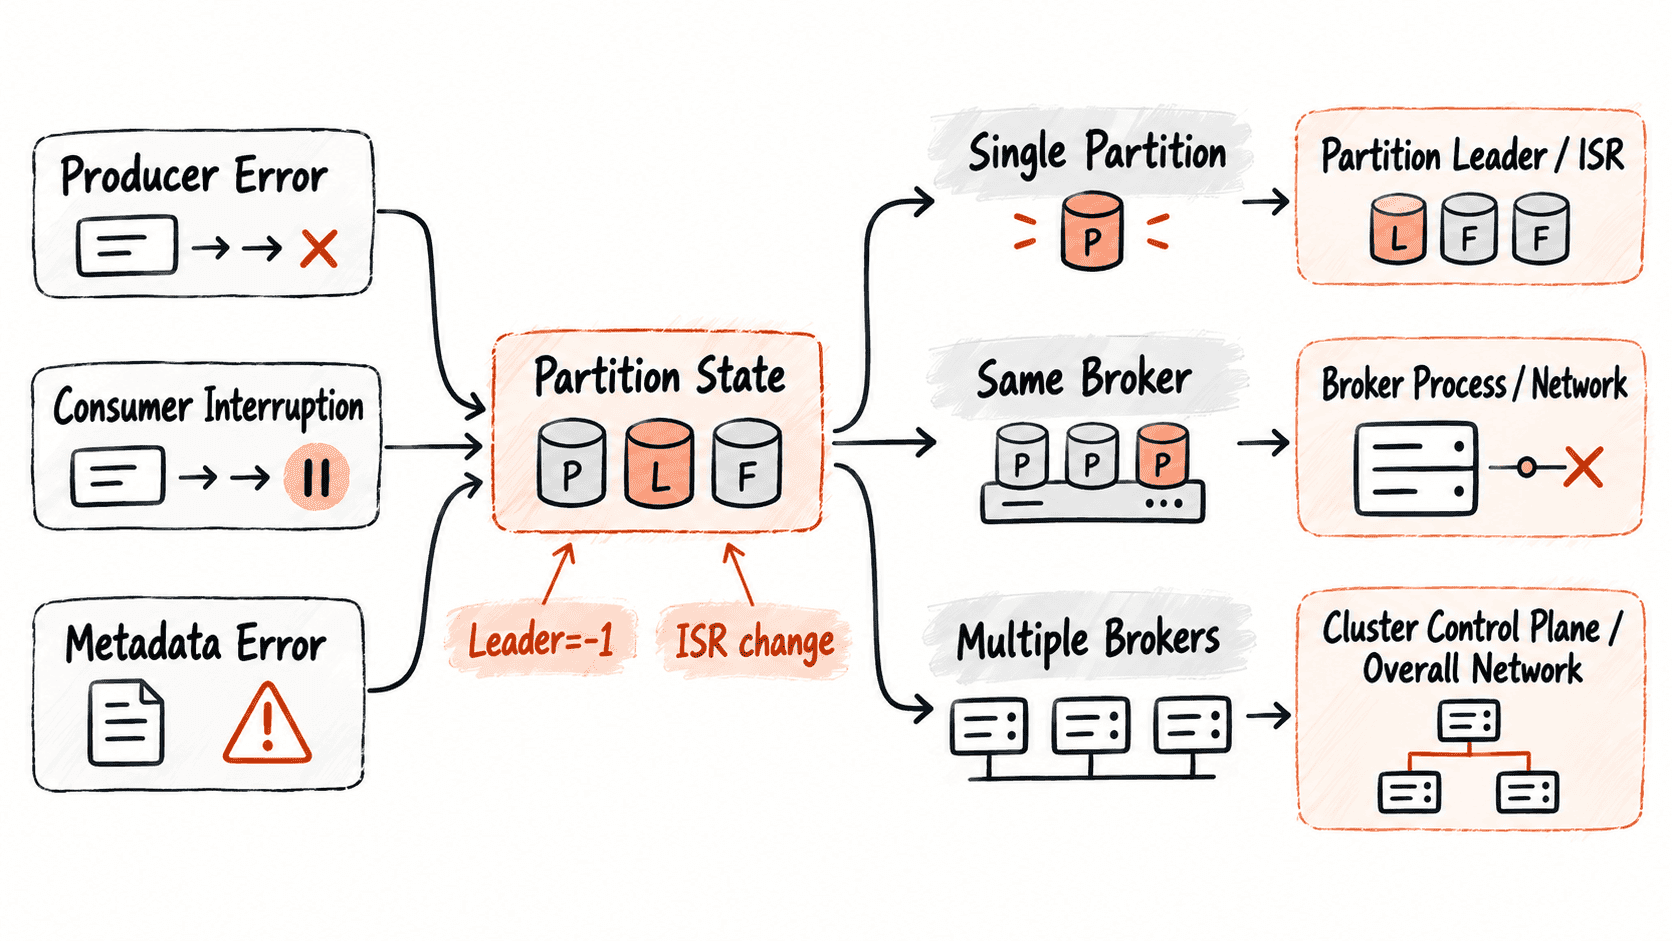
可以用一个简单规则快速缩小范围:先看分区,后看 Broker,再看集群。因为客户端最终访问的是某个 Topic-Partition,直接从受影响分区开始,通常比先翻所有 Broker 日志更容易发现故障边界。
不要把消费停顿直接当成分区不可用
消费中断还需要结合 offset 和分区状态判断。若消费者仍持有分区分配,但 Lag 快速增长,可能是处理变慢或下游阻塞;若某分区同时出现 Leader: -1 或无法获取有效元数据,则才更接近分区本身不可用。
同样,元数据错误也不能直接等同于分区永久故障。Leader 切换期间客户端可能短暂看到旧元数据,从而出现需要刷新元数据后才能恢复的错误。只有把客户端报错时间与实际 Partition 状态对上,才能确认“元数据异常”只是现象还是根因。
形成一次可复用的定位顺序
现场处理时,可以固定使用以下顺序:
- 从生产、消费或客户端元数据错误中提取 Topic、Partition 和时间窗口。
- 查询对应 Topic 的分区描述,确认 Leader、Replicas 和 ISR。
- 统计异常分区是否集中到同一个 Broker。
- 根据影响范围判断是单分区、Broker 级还是集群级问题。
- 在范围确定后,再检查 Broker 进程、网络、磁盘以及控制面相关事件。
- 修复后重新验证 Leader 是否恢复、客户端错误是否停止、消费是否恢复推进。
例如,一个 Broker 故障可能同时造成多个分区失去 Leader;这时修复单个生产客户端并不能解决问题。反过来,如果只有一个 Partition Leader: -1,其余分区均正常,就不应一开始就把整个集群判定为故障。
分区不可用排查的关键不是记住某一种客户端错误,而是把错误还原为明确的 Partition 状态,并通过异常分区之间的副本归属判断故障范围。只要先确定“哪个分区坏了、它的 Leader 在哪里、还有哪些 ISR、异常是否集中于某个 Broker”,后续的修复方向就会清晰很多。