
消息队列 / 系统课时
安全下线异常 Broker
安全下线异常 Broker
本课解决 Broker 需要维护或已经异常时,如何把下线动作控制在最小风险范围内。核心不是直接停止进程,而是先确认 Leader、Replica 和 ISR 的分布,再根据 Broker 是否健康选择正常关闭、副本迁移或故障处置。
学习目标
- 能区分健康 Broker 的正常关闭与无响应 Broker 的故障处置
- 能检查目标 Broker 承载的 Leader、Replica 和 ISR 风险
- 能在下线前后验证分区可用性与副本冗余状态
先判断 Broker 属于哪种状态
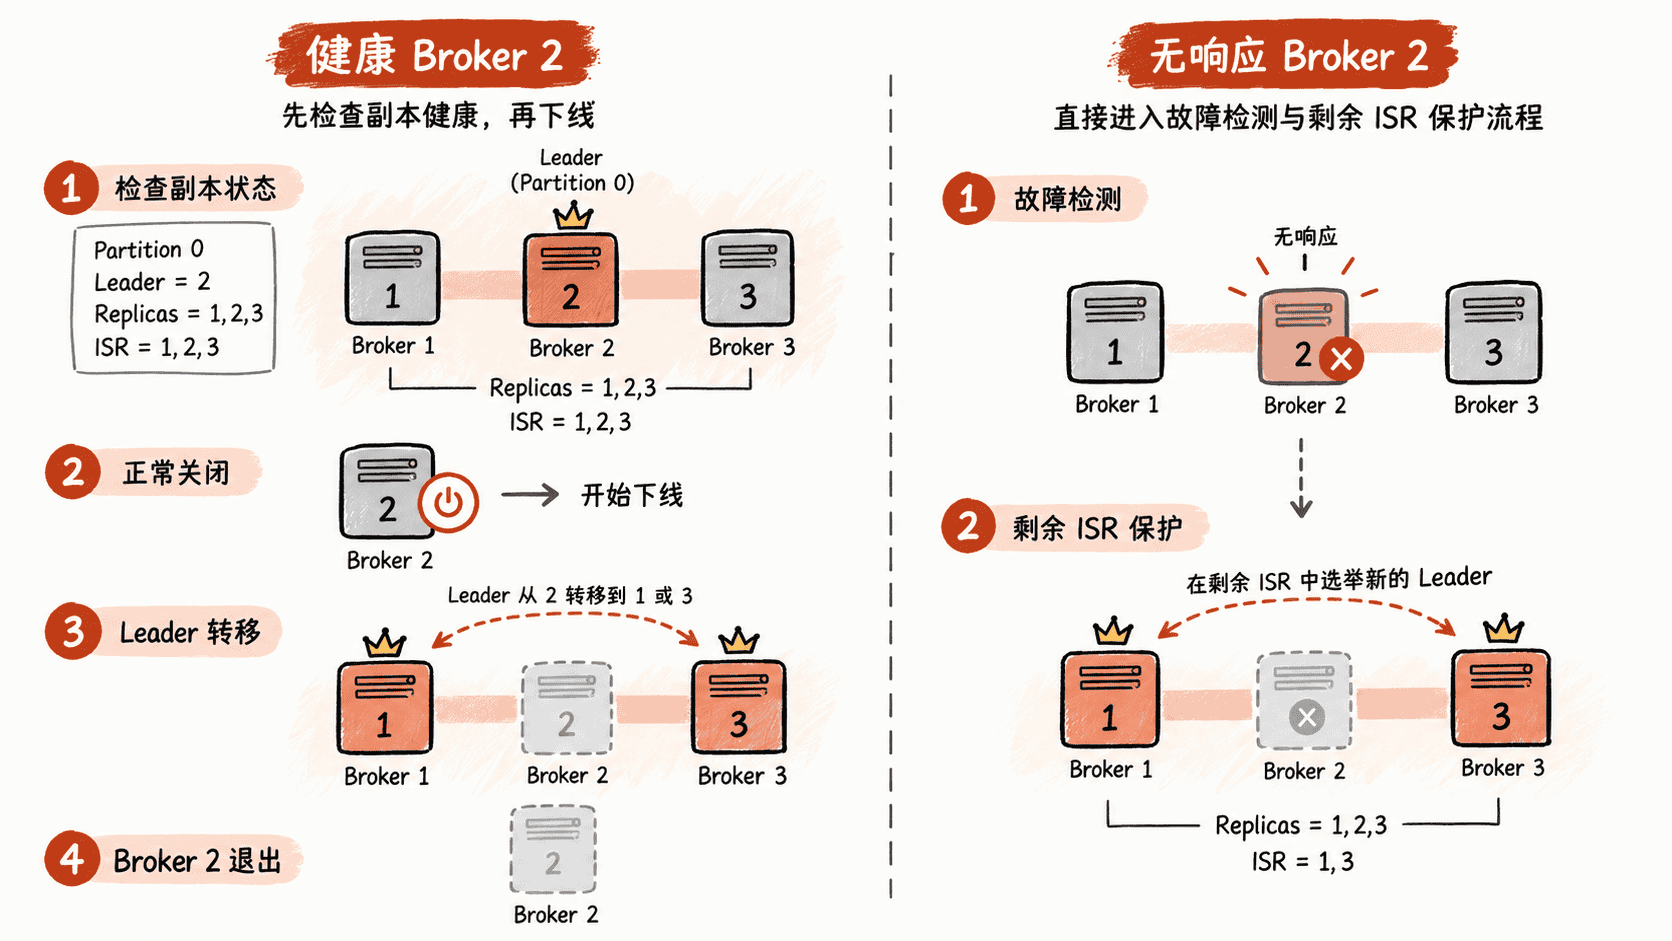
健康且可响应的 Broker 适合通过正常 shutdown 流程退出。启用受控关闭时,Kafka 会在 Broker 退出过程中尝试把其承载的 Leader 转移到其他可用副本,以缩短不可用窗口;但相关分区仍必须存在满足条件的其他副本。
controlled.shutdown.enable 决定是否启用这一行为,但它属于 read-only broker config。这意味着它不是下线前通过动态配置命令临时打开或关闭的运维开关,而是 Broker 正常关闭流程使用的配置。运维动作的重点仍然是以正常方式终止 Broker,并提前确认副本条件是否允许安全切换。
已经无响应或持续故障的 Broker 不能依赖正常 shutdown 流程完成 Leader 转移。此时应按故障 Broker 处理,优先保护仍在 ISR 中的其他副本,避免继续停止承载同一批关键分区的 Broker。
下线前检查副本分布
先确认目标 Broker 是否承载关键分区,以及这些分区当前有哪些 Replica 和 ISR。以下命令只读取主题状态,不会修改集群。
bin/kafka-topics.sh --bootstrap-server <HOST>:<PORT> --describe --topic orders预期结果
Topic: orders  Partition: 0  Leader: 2  Replicas: 1,2,3  Isr: 1,2,3
Topic: orders  Partition: 1  Leader: 4  Replicas: 2,4,5  Isr: 4,5
假设准备下线 Broker 2:分区 0 中 Broker 2 是 Leader 且属于 ISR,需要确认 Leader 能转移到 Broker 1 或 3;分区 1 中 Broker 2 虽然仍在 Replica 分配里,却已经不在 ISR,不能把它计入当前有效冗余。
选择正常关闭还是先迁移副本
对单台健康 Broker 做短时维护,可以优先使用正常关闭流程,让 Kafka 在退出过程中处理 Leader 转移。这里不要把“停止 Broker”和“迁移副本”混成一个动作:正常关闭解决进程退出与 Leader 切换,Replica 的分配关系并不会因此自动永久迁出该 Broker。
如果目标是永久移除 Broker,应先通过副本重分配把其承载的 Replica 迁移到其他 Broker,确认目标 Broker 已不再承担需要保留的副本后再停止服务。迁移过程中还要观察复制流量、磁盘和网络压力,避免重分配本身冲击在线业务。
无论短时维护还是永久移除,都不要一次下线多个承载相同关键分区副本的 Broker。尤其在 ISR 已收缩时,再停止另一个 ISR 成员,可能把冗余下降直接推进到分区不可用。
执行关闭并验证结果
确认目标 Broker 健康且关键分区存在其他可用副本后,再通过服务管理器或正常终止信号关闭 Broker。下面使用 SIGTERM 表示正常终止,生产环境应替换为实际的进程管理方式。
kill -TERM <PID>
echo $?
预期结果
0返回码 0 只表示信号已经成功发送,并不能证明 Kafka 层面的 Leader 转移和副本恢复已经完成。Broker 退出后还要重新检查关键分区状态。
bin/kafka-topics.sh --bootstrap-server <HOST>:<PORT> --describe --topic orders预期结果
Topic: orders  Partition: 0  Leader: 1  Replicas: 1,2,3  Isr: 1,3
Topic: orders  Partition: 1  Leader: 4  Replicas: 2,4,5  Isr: 4,5
示例中分区 0 的 Leader 已从 Broker 2 转移到 Broker 1,Broker 2 退出后也从 ISR 中消失;Replica 列表仍包含 Broker 2,因为正常关闭不会改写副本分配。如果只是短时维护,可以在 Broker 恢复后继续观察其重新追入 ISR;如果 Broker 不再恢复,则必须继续完成副本重分配,不能把“进程已经停掉”误判成“下线治理已经完成”。