
消息队列 / 系统课时
控制副本恢复速度
控制副本恢复速度
副本故障恢复不是越快越好。恢复会同时消耗 Broker 网络、磁盘 I/O 和复制线程资源;本课通过复制限速、受限副本范围和运行时观测,让副本持续追赶,同时避免恢复流量挤压正常生产与消费。
学习目标
- 能根据网络、磁盘和在线请求负载确定副本恢复节奏
- 能正确区分复制速率上限与受限副本范围,并组合配置二者
- 能根据复制 lag、ISR 和业务延迟动态调节限速并在恢复后清理配置
先判断资源瓶颈
副本恢复至少涉及两个方向:Leader 所在 Broker 读取日志并发送数据,Follower 所在 Broker 接收数据并写入本地日志。网络带宽不足时,继续增加同时恢复的分区只会加剧链路竞争;磁盘写入已经接近上限时,提高复制吞吐又会增加 I/O 排队,进而拖慢正常生产、消费和请求处理。
因此不要只看“恢复了多少 MiB/s”。开始恢复前应同时观察 Broker 网络吞吐、磁盘利用率或写入延迟,以及生产和消费请求延迟,并为正常业务的突发流量保留余量。如果一次重分配包含大量分区,还应把计划拆成较小批次;复制限速控制的是流量上限,并不会自动减少同时参与恢复的分区数量。
同时配置速率和受限副本
Kafka 的复制限速由两组配置共同生效。leader.replication.throttled.rate 与 follower.replication.throttled.rate 是 Broker 级的字节/秒速率上限;leader.replication.throttled.replicas 与 follower.replication.throttled.replicas 是 Topic 级的副本集合,用来指定哪些 partition:broker 受到对应方向的限制。
只设置 rate 并不等于给某次重分配中的目标副本完成了精确限速。必须同时确定受限副本范围。进行标准分区重分配时,优先使用 kafka-reassign-partitions.sh --throttle,工具会同时维护 Broker 级速率和 Topic 级副本列表;需要人工控制时,再分别配置这两组参数。
下面以 orders 的 0 号分区为例:当前 Leader 位于 <LEADER_BROKER_ID>,待恢复 Follower 位于 <FOLLOWER_BROKER_ID>,双方复制流量上限设为 50 MiB/s。运行前将动态占位符替换为实际值。
kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type brokers --entity-name <LEADER_BROKER_ID> \
  --alter --add-config 'leader.replication.throttled.rate=52428800'

kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type brokers --entity-name <FOLLOWER_BROKER_ID> \
  --alter --add-config 'follower.replication.throttled.rate=52428800'

kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type topics --entity-name orders \
  --alter --add-config 'leader.replication.throttled.replicas=0:<LEADER_BROKER_ID>,follower.replication.throttled.replicas=0:<FOLLOWER_BROKER_ID>'
预期结果
Completed updating config for broker <LEADER_BROKER_ID>.
Completed updating config for broker <FOLLOWER_BROKER_ID>.
Completed updating config for topic orders.
其中 52428800 的单位是字节/秒,即 50 MiB/s;副本列表采用 partition:broker 格式,也可以使用 * 表示该主题的全部副本。若重分配期间 Leader 可能切换,不应只把当前 Leader 写入范围;应覆盖可能承担 Leader 复制流量的相关旧副本,或直接让重分配工具自动维护限速集合。
恢复过程中动态调节
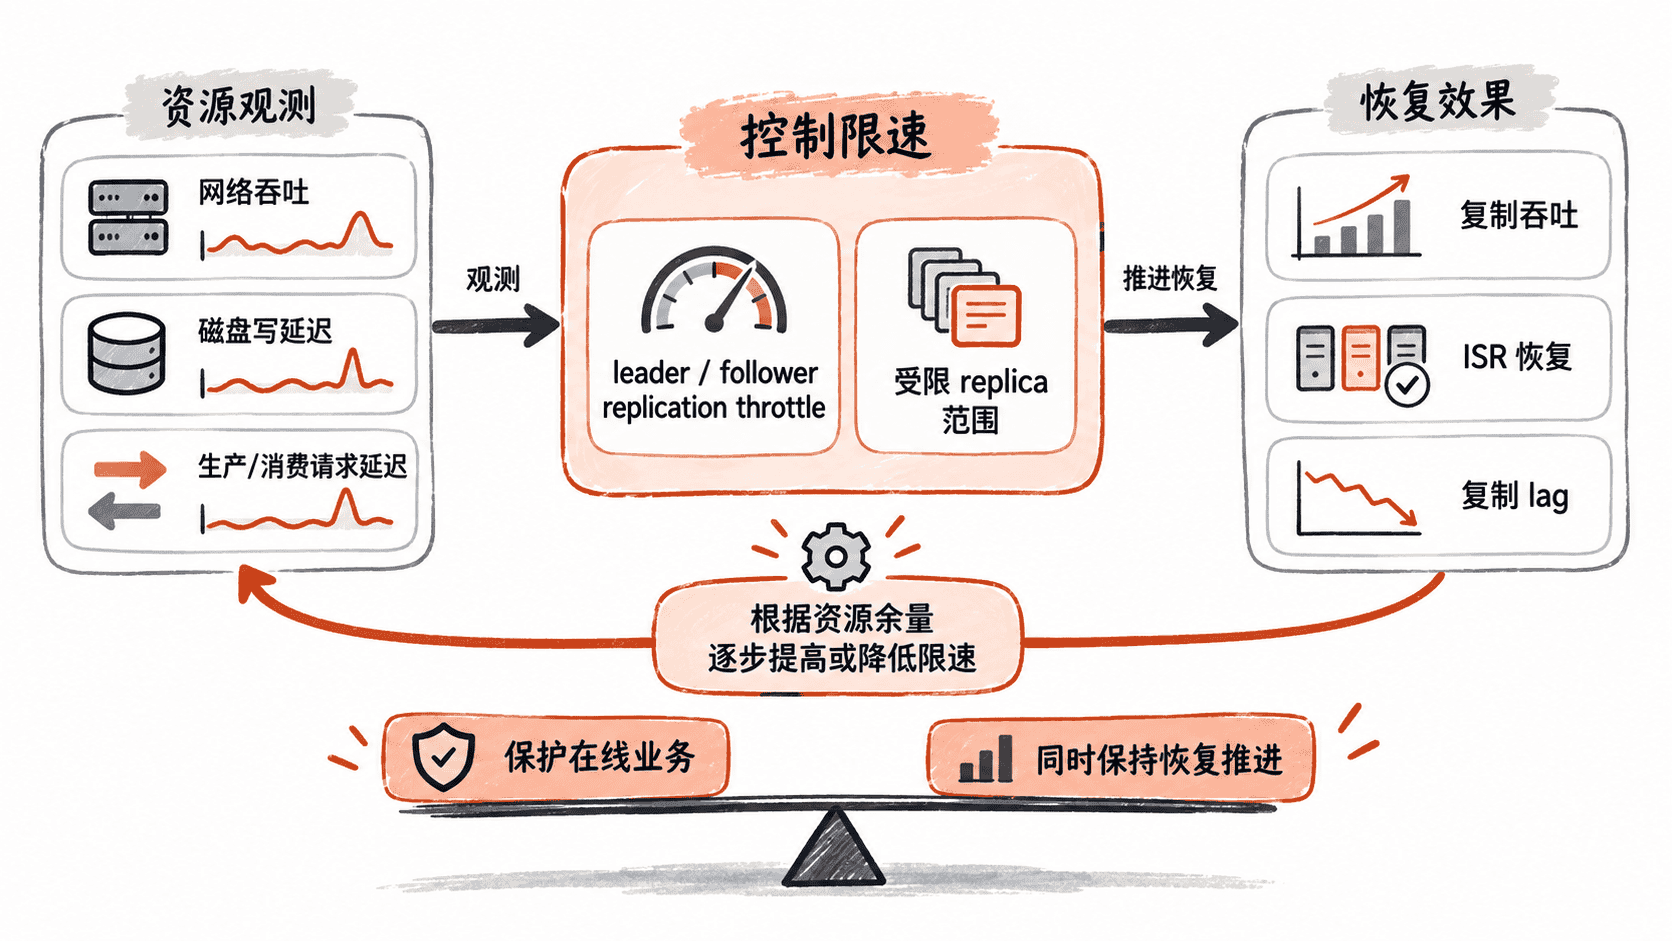
限速值不宜在故障开始时一次拉到资源上限。更稳妥的做法是从保守值启动,观察恢复流量和业务延迟,再根据资源余量逐步提高。重分配期间可重点观察 ReassignmentBytesInPerSec、ReassignmentBytesOutPerSec、副本 Fetcher lag、ISR 变化以及在线请求延迟。
判断是否可以继续提速时,核心不是某个瞬时吞吐值,而是恢复是否稳定取得进展:落后副本的 lag 应总体持续下降,ISR 应向正常状态收敛。如果限速过低,而生产写入速度持续高于副本能够追赶的速度,lag 可能长期不降甚至继续增长,此时需要在业务资源允许的前提下提高限速。
恢复完成后解除临时限制
确认副本已经追平、相关分区重新进入稳定 ISR 后,应清理本次人工设置的 Broker 级 rate 和 Topic 级受限副本集合。只删除 rate 或只删除 replica 列表都不是完整的收尾;遗留的限速配置可能影响后续正常复制或下一次重分配。
kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type brokers --entity-name <LEADER_BROKER_ID> \
  --alter --delete-config 'leader.replication.throttled.rate'

kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type brokers --entity-name <FOLLOWER_BROKER_ID> \
  --alter --delete-config 'follower.replication.throttled.rate'

kafka-configs.sh --bootstrap-server <BOOTSTRAP> \
  --entity-type topics --entity-name orders \
  --alter --delete-config 'leader.replication.throttled.replicas,follower.replication.throttled.replicas'
预期结果
Completed updating config for broker <LEADER_BROKER_ID>.
Completed updating config for broker <FOLLOWER_BROKER_ID>.
Completed updating config for topic orders.
控制副本恢复速度的重点是形成闭环:先限制参与复制的副本范围和流量上限,再通过 lag、ISR、网络、磁盘与业务延迟判断是否需要调速;大量分区同时恢复时还要控制重分配批次。这样才能在尽快恢复副本与保护在线业务之间取得平衡。