
消息队列 / 系统课时
恢复 Leader 与流量
恢复 Leader 与流量
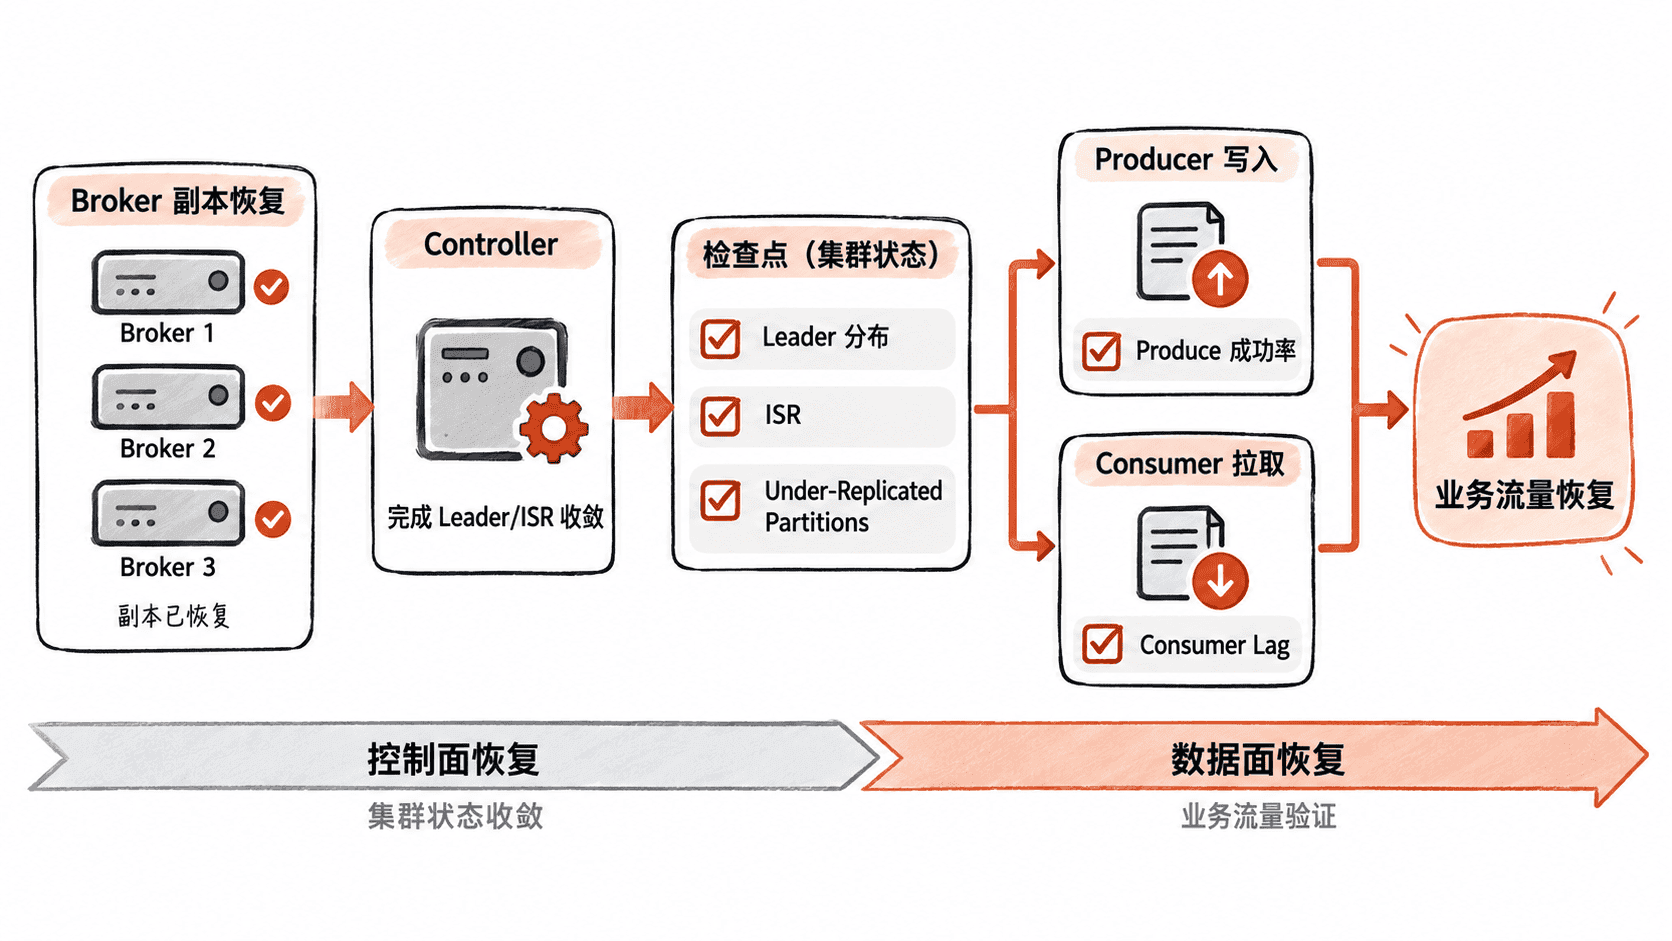
副本恢复并不等于业务恢复:还要确认分区已经形成稳定、可用的 Leader 分布,Producer 能持续写入,Consumer 能持续拉取,并且恢复动作没有留下新的热点或持续欠复制分区。
学习目标
- 能按分区状态、Producer、Consumer 和业务四个层次验证恢复结果。
- 能用 Kafka 管理命令检查 Leader、ISR、写入路径与消费积压。
- 能根据多层证据判断何时可以结束故障处置。
先确认 Leader 与副本状态收敛
Broker 恢复后,第一步不是立即宣布业务正常,而是确认受影响分区已经重新选出可服务的 Leader,ISR 正在恢复,并且欠复制状态没有继续恶化。Leader 频繁切换或 ISR 长时间缺少副本,都说明集群仍处于恢复过程中。
先检查目标 Topic 的分区状态:
kafka-topics.sh --bootstrap-server <BROKER> --describe --topic <TOPIC>预期结果:
Topic: <TOPIC> Partition: <PARTITION> Leader: <BROKER_ID> Replicas: <BROKER_ID>,<BROKER_ID>,<BROKER_ID> Isr: <BROKER_ID>,<BROKER_ID>,<BROKER_ID>Leader 应指向当前可服务的 Broker,Isr 应逐步恢复到预期副本集合。实际 Broker ID、分区号以及输出排版会随集群和 Kafka 版本不同而变化;如果 Leader 持续变化或 ISR 长时间不收敛,应继续排查 Broker、网络和副本同步状态。
验证 Producer 写入路径
分区状态正常后,还要验证真实写入。Leader 已可见并不代表应用层请求已经完全恢复,客户端可能仍持有旧元数据,或者网络连接虽然恢复,但写入错误率和延迟仍然异常。
可以向允许验证的 Topic 写入一条带唯一标识的测试消息;生产环境应使用专用测试 Topic 或约定的校验键,避免恢复检查污染业务数据。
printf 'recovery-check-<TIME>\n' | kafka-console-producer.sh --bootstrap-server <BROKER> --topic <TOPIC>预期结果:
命令完成写入且未持续出现 NOT_LEADER_OR_FOLLOWER、LEADER_NOT_AVAILABLE 等错误。如果连续出现 Leader 相关错误,不要只重启 Producer。先确认目标分区的 Leader 是否仍在切换,再检查客户端是否能够连接 bootstrap server 并重新获取元数据。
验证 Consumer 拉取与积压趋势
Consumer 恢复需要同时确认“能够拉取”和“积压正在恢复”。仅看到 Consumer Group 存活并不足以证明链路正常,因为消费者可能仍未推进 offset,或者故障期间形成的积压仍在持续增长。
kafka-consumer-groups.sh --bootstrap-server <BROKER> --describe --group <GROUP_ID>预期结果:
GROUP       TOPIC    PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
<GROUP_ID>  <TOPIC>  <PARTITION> <VALUE>         <VALUE>         <VALUE>
验收时重点观察 CURRENT-OFFSET 是否继续推进,以及 LAG 是否停止增长并进入可接受的下降趋势。对于原本没有积压的分区,LAG 可以保持为 0 或接近 0;发生过故障的分区则更应关注趋势,而不是要求瞬间全部归零。实际列宽和附加字段可能因 Kafka 版本不同而变化。
用多层证据结束恢复
恢复判断可以固定为四层:分区层确认 Leader 稳定且 ISR 收敛,Producer 层确认持续成功写入,Consumer 层确认 offset 推进并消化积压,业务层确认关键请求和处理结果恢复正常。任何一层缺少证据,都不应仅凭 Broker 已启动就结束故障处置。
只有当集群状态和端到端流量同时稳定,恢复操作才真正从“基础设施重新可用”进入“业务流量已经回归”。