
消息队列 / 系统课时
理解 Partition 与 Replica 关系
理解 Partition 与 Replica 关系
这一课解决 Kafka 中分区、副本和 Broker 容易混淆的问题。理解三者如何组合后,你就能判断副本数量、节点故障与数据可用性之间的关系,并为后续故障治理建立正确的观察视角。
学习目标
- 说清 Partition、Replica 与 Broker 各自承担的角色
- 理解一个 Partition 的多个 Replica 如何分布到不同 Broker
- 判断副本数量对单节点故障后的可用性与恢复空间意味着什么
三个对象怎么对应
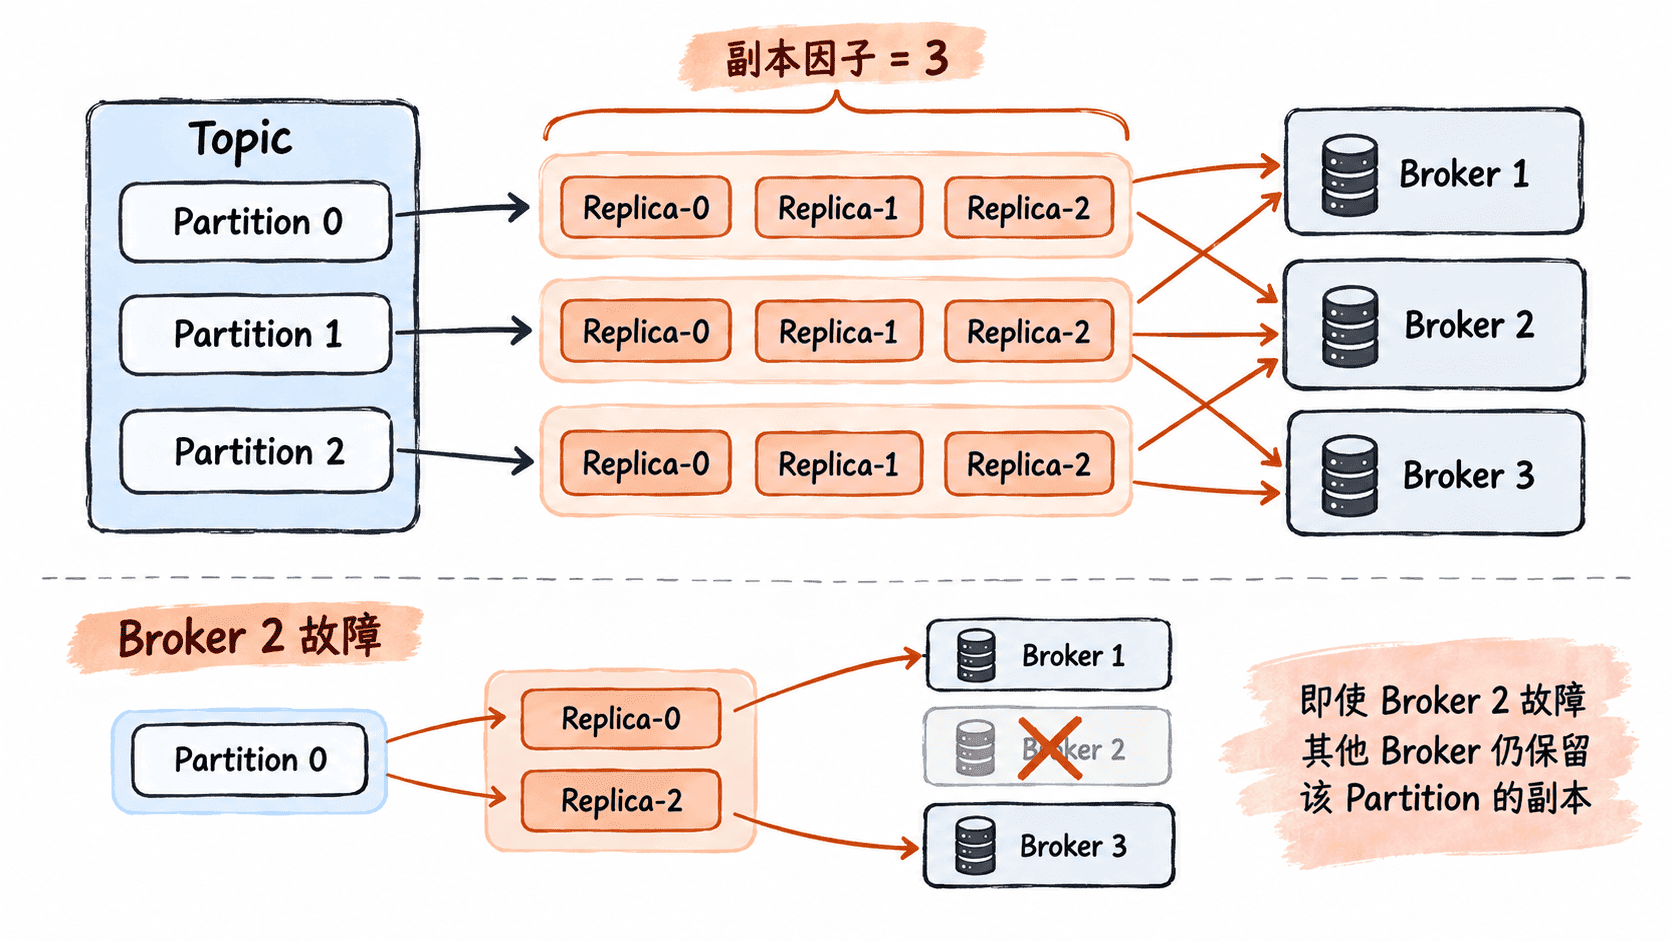
Partition 是 Topic 中可被独立管理和复制的数据分片;生产者和消费者实际围绕 Partition 工作。一个 Topic 可以有多个 Partition,而每个 Partition 又可以配置多个 Replica。
Replica 是某个 Partition 的副本。假设一个 Partition 的副本因子为 3,那么它会形成 3 个 Replica。Replica 不等于 Broker,它表示“同一分区的一份数据副本”。
Broker 是承载这些 Replica 的 Kafka 服务节点。Kafka 会把同一个 Partition 的不同 Replica 尽量放到不同 Broker 上,这样单个 Broker 故障时,其他节点仍可能保留该 Partition 的副本。
副本数量为什么影响可用性
副本因子为 1 时,一个 Partition 只有一份数据副本。承载它的 Broker 一旦不可用,该 Partition 就没有其他数据副本可接替,故障影响会直接暴露出来。
副本因子为 2 时,同一 Partition 有两份 Replica,通常分别放在两个 Broker。某一个 Broker 故障后,另一个副本仍可能继续承担服务,但系统可用性还取决于副本是否同步、当前选举条件以及其他运行状态。
副本因子为 3 时,单个 Broker 故障通常还有两份副本留存,因此相比副本因子 2 有更大的故障容忍和恢复空间。这里的“空间”不仅指还能剩多少副本,也包括重新复制数据时可利用的健康节点数量。
因此,副本因子并不是简单的“越大越好”。副本越多,需要维护、同步和恢复的数据量也越大,磁盘、网络与恢复时间都会增加。生产环境应根据可接受的故障范围和资源预算确定副本数量。
单节点故障时应该看什么
判断故障影响时,不要只看“这个 Broker 挂了多少个 Partition”。更重要的是确认这些 Partition 还有多少可用 Replica,以及这些 Replica 是否处于正常同步状态。
对于某个 Partition,可以把问题简化成三个连续判断:副本有几份 → 剩余副本在哪里 → 剩余副本能否继续承担服务。这比单独查看 Broker 数量更能解释故障后的真实风险。
例如,一个副本因子为 3 的 Partition,如果三个 Replica 恰好分散在三个 Broker,那么单个 Broker 故障通常只是让可用副本从 3 份减少到 2 份;如果多个 Replica 因异常分布集中在同一故障域,实际容灾能力就会低于表面的副本数量。
理解这一层关系后,排查 Kafka 副本故障时就应从“哪个 Broker 出问题”进一步追到“哪些 Partition 的 Replica 受到影响,以及还剩哪些健康副本”。