
消息队列 / 系统课时
分析 Producer 写入失败
分析 Producer 写入失败
本课解决 Producer 发送消息失败时“到底是暂时重试,还是已经进入副本故障”的判断问题。核心是把 acks、ISR、Leader 状态和具体错误放到同一条因果链上,最后形成可执行的处置结论。
学习目标
- 能结合
acks、min.insync.replicas和 ISR 判断写入是否具备足够副本保障 - 能从 Producer 异常和分区状态区分短暂可重试故障与持续性基础设施故障
- 能用分区描述和 Producer 日志验证故障是否已经恢复
先判断写入为什么会失败
Producer 写入通常先发送给当前分区 Leader。Leader 是否可用、ISR 是否满足写入要求,以及 Producer 的 acks 设置,共同决定请求能否成功。
acks=0 不等待 Broker 确认;acks=1 只等待 Leader 写入本地日志后的确认;acks=all 要求 Leader 等待 ISR 中副本满足确认条件。实际可靠性还受 min.insync.replicas 约束:当 ISR 数量低于该值时,即使 Producer 使用 acks=all,写入也可能被拒绝。
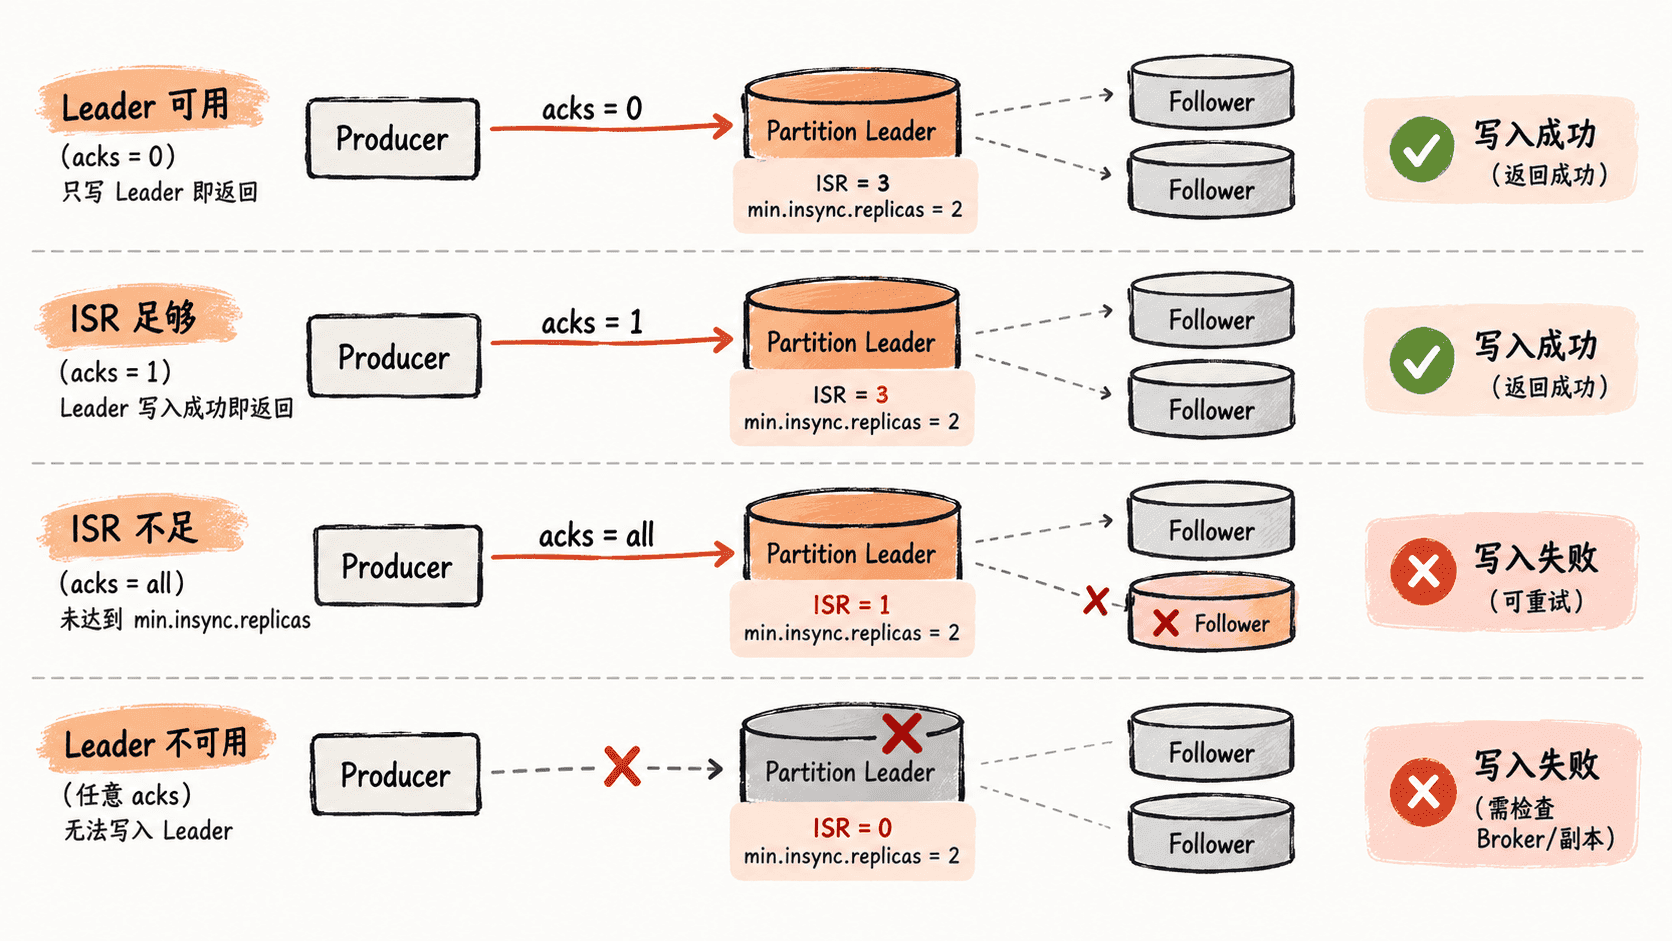
例如 Topic 的复制因子为 3、min.insync.replicas=2,某时刻只有 Leader 还处于 ISR。此时 Producer 使用 acks=all,写入会因为 ISR 不满足门槛而失败。这里的关键不是“Producer 突然坏了”,而是“当前副本健康度已经不足以满足可靠性策略”。
区分可重试错误和持续故障
可重试错误通常表示集群状态正在变化,例如 Leader 切换、短暂网络抖动或请求超时。Producer 可以按自身重试策略继续发送,但重试只能处理暂时性状态变化,不能替代副本故障治理。
下面用 Kafka CLI 查看某个分区的 Leader、ISR 和副本集合。命令中的占位符需要替换成实际环境值。
kafka-topics.sh \
  --bootstrap-server <BOOTSTRAP> \
  --describe \
  --topic <TOPIC> \
  --partition 0
预期结果
Topic: <TOPIC> Partition: 0 Leader: 3 Replicas: 1,2,3 Isr: 2,3如果看到 Leader 正常、ISR 也满足业务要求,而 Producer 偶发出现 LEADER_NOT_AVAILABLE、NOT_LEADER_OR_FOLLOWER 或网络类超时,应优先考虑正在发生的 Leader 变更或短时连接问题。若这些错误持续存在,则继续检查 Leader 是否反复切换,以及对应 Broker 是否稳定。
相反,当 ISR 长时间缩小、Leader 所在 Broker 不稳定,或者 acks=all 持续返回副本不足相关错误时,重复重试通常不会自行恢复。此时应转向 Broker 日志、磁盘、网络和副本同步状态,而不是无限提高 Producer 重试次数。
用最小信息形成故障结论
分析一次写入失败,至少记录四类证据:Producer 实际错误、目标分区的 Leader、ISR 数量,以及 Topic 的 min.insync.replicas。四项信息能把“客户端请求失败”还原为“分区当前不能满足什么条件”。
可以把判断简化为下面的顺序:先看请求是不是瞬时错误,再确认 Leader 是否存在;Leader 正常后,再看 ISR 是否满足 min.insync.replicas;如果 ISR 持续不足,就进入副本故障处理,而不是把它当作普通网络重试。
什么时候需要人工干预
需要人工介入的典型信号是:Leader 长时间不可用、ISR 持续不足、同一 Broker 反复掉出 ISR、磁盘或网络异常,以及故障已经影响多个分区。此时首先保护数据可靠性,确认是否存在持续复制落后,再决定是否迁移 Leader、恢复 Broker 或调整容量。
不要把“Producer 最终成功”直接等同于“集群已经健康”。消息能够重新写入,只说明当前请求恢复;只有当 Leader 稳定、ISR 恢复到预期规模并且副本同步没有持续积压,才可以认为副本层面的风险已经解除。