
消息队列 / 系统课时
建立客户端影响基线
建立客户端影响基线
本课把服务器侧故障转换成客户端可见信号,重点观察 Producer、Consumer 在 Leader 变化、副本落后和分区不可用期间的错误、延迟与重试,从而判断故障到底影响了什么。
学习目标
- 能区分 Producer 与 Consumer 在分区异常中的主要表现
- 能用错误、延迟和重试三个维度建立客户端故障基线
- 能把客户端时间线与 Leader 变化、分区不可用事件对齐
先建立客户端视角
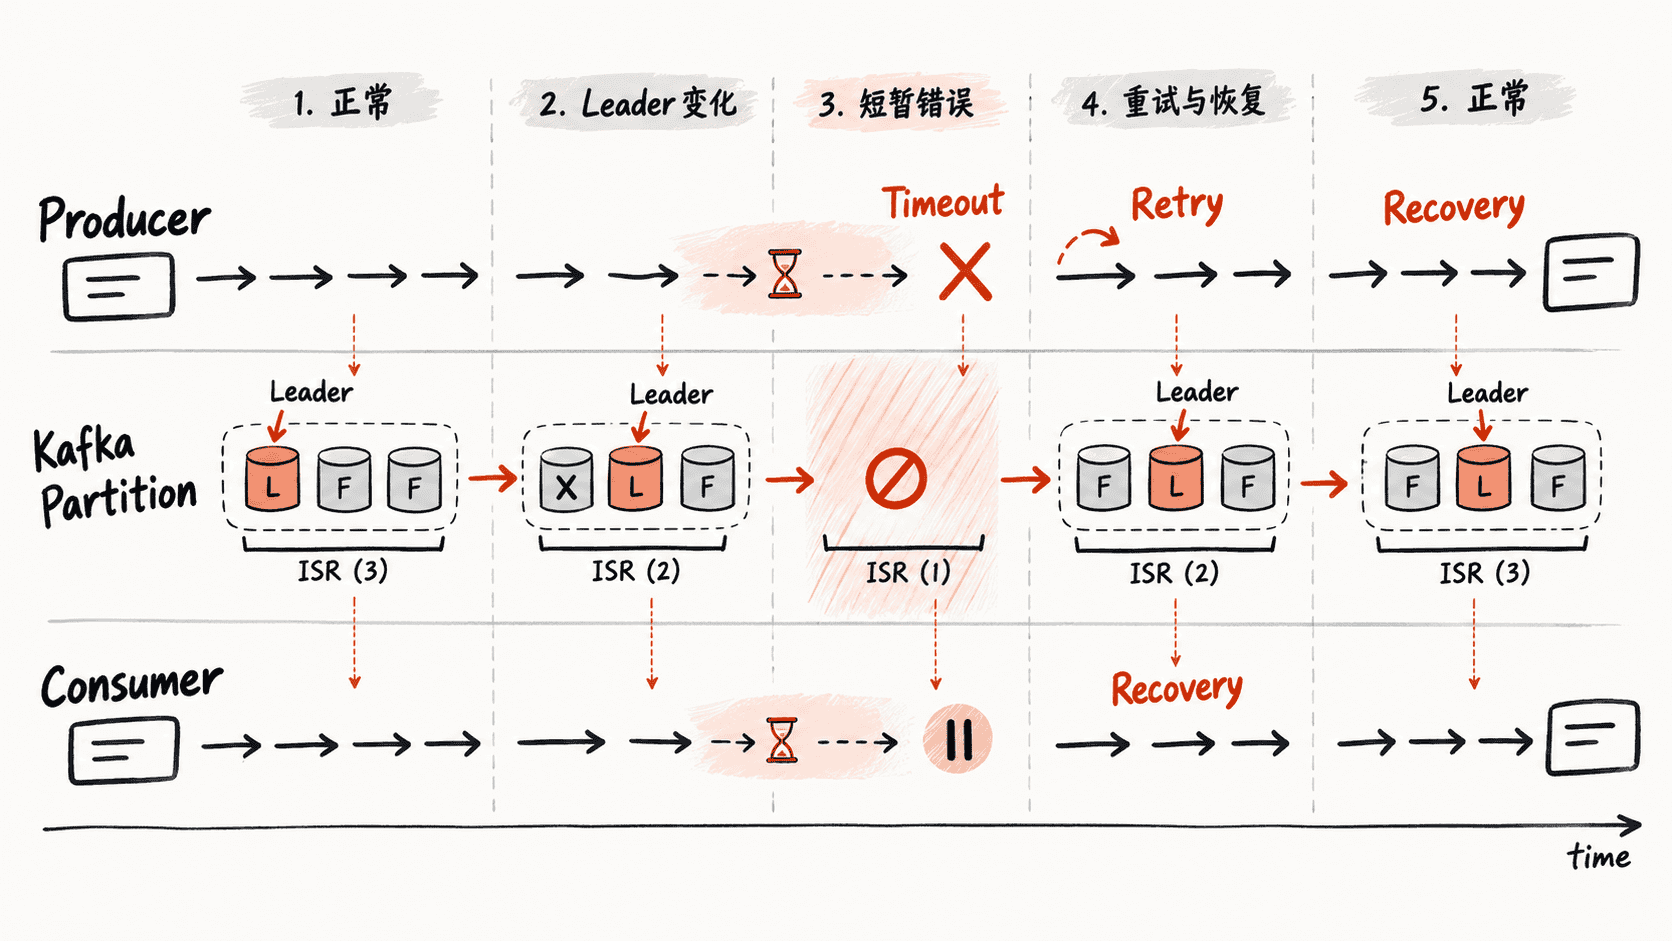
Broker 侧看到的是副本、Leader 和请求处理状态,客户端看到的却是发送失败、请求超时、重试、拉取中断或消费延迟。因此治理客户端影响时,不能只记录“Kafka 有故障”,而要记录什么时候开始失败、失败了多久、客户端重试了多少次,以及恢复后是否追平。
Producer 更关注发送确认、请求延迟和重试;Consumer 更关注拉取延迟、消费停顿、重新分配后的恢复时间以及消息积压变化。两者发生异常的时间点可能不同。
用日志建立 Producer 基线
先让 Producer 执行一段可控发送,再从客户端日志中观察成功、错误和重试。下面示例使用 Kafka 自带控制台 Producer,重点不是业务消息格式,而是确认客户端是否能持续发送。
kafka-console-producer.sh --bootstrap-server <BROKER:PORT> --topic <TOPIC>预期结果
> baseline-message-1
> baseline-message-2
> baseline-message-3
在基线阶段,应记录发送是否持续成功以及端到端延迟。发生 Leader 变化时,客户端可能出现短暂重试或请求延迟增加;这类短暂波动与持续失败需要区分。
对于实际业务 Producer,还应记录客户端错误类型、请求延迟分位数、重试次数以及发送失败率。不要把“重试发生”直接等价成“消息丢失”,两者属于不同问题,必须进一步核对确认语义与应用处理逻辑。
用 Consumer 基线观察恢复速度
Consumer 的基线重点是“还能不能持续拉取”和“恢复后多久追平”。可以使用控制台 Consumer 持续读取指定 Topic,用于验证分区在异常期间是否仍可消费。
kafka-console-consumer.sh --bootstrap-server <BROKER:PORT> --topic <TOPIC> --group <GROUP_ID> --from-beginning预期结果
baseline-message-1
baseline-message-2
baseline-message-3
发生 Leader 变化时,Consumer 可能出现短暂的拉取暂停、重新连接或重新分配,随后恢复。真正需要关注的是恢复后消费速率是否回到基线、积压是否继续增长,以及恢复耗时是否稳定。
用三类指标定义影响程度
客户端影响可以压缩成三个维度:错误、延迟、重试。错误回答“请求有没有成功”,延迟回答“成功需要多久”,重试回答“客户端为了成功付出了多少额外请求”。三者同时上升时,通常比单独出现某一项更值得关注。
| 维度 | Producer 观察 | Consumer 观察 | 判断重点 |
|---|---|---|---|
| 错误 | 发送失败、超时 | 拉取失败、重连 | 是否集中发生在故障窗口 |
| 延迟 | 请求确认延迟 | 拉取或消费恢复延迟 | 峰值与持续时间 |
| 重试 | Retry 增加 | 重连、重新分配 | 是否形成持续恢复压力 |
还要把客户端时间戳和 Broker 事件时间戳放在同一时间轴上。例如 Leader 变化发生在 <TIME>,Producer 从该时刻开始出现短时重试,Consumer 在随后出现短暂停顿,这比只记录“客户端报错”更有诊断价值。
区分短暂抖动和真实不可用
故障基线至少应保留四个数字:故障前正常延迟、故障期间峰值延迟、错误持续时间、恢复到稳定状态所需时间。对于 Consumer,再增加恢复后的积压或追平速度。
当客户端指标恢复、重试停止,并且 Consumer 能重新稳定消费时,可以认为客户端影响已经结束;若 Broker 状态恢复而客户端仍持续超时或积压,则故障治理还没有闭环,应继续向网络、客户端连接配置或应用处理速度方向定位。