
架构与系统设计 / 系统课时
处理 Streaming RPC 的失败恢复
处理 Streaming RPC 的失败恢复
Streaming RPC 一旦中断,真正困难的不是“再连一次”,而是判断哪些消息已经到达应用、哪些业务结果已经提交,以及从哪里继续才不会丢数据或重复执行。本课建立一套可落地的重新建流、检查点与幂等恢复方法。
学习目标
- 区分传输进度、应用读取进度和业务提交进度
- 为 Server Streaming、Client Streaming 与双向流选择合适的恢复策略
- 用序号、检查点和幂等处理设计可验证的断点续传
先分清三层进度
流式调用里最容易犯的错误,是把“gRPC 已收到消息”当成“业务已经处理完成”。实际上至少有三层进度:消息是否完成传输并进入接收端 gRPC、应用是否通过流读取到消息、业务是否已经持久化处理结果与进度。三者可能并不同步。
例如客户端已经通过 Recv() 得到事件 42,但还没把事件写入本地数据库,此时连接断开。如果重连后从 43 开始,会直接丢掉 42;如果从 41 继续,则 42 可能再次出现,因此处理逻辑必须能识别重复。
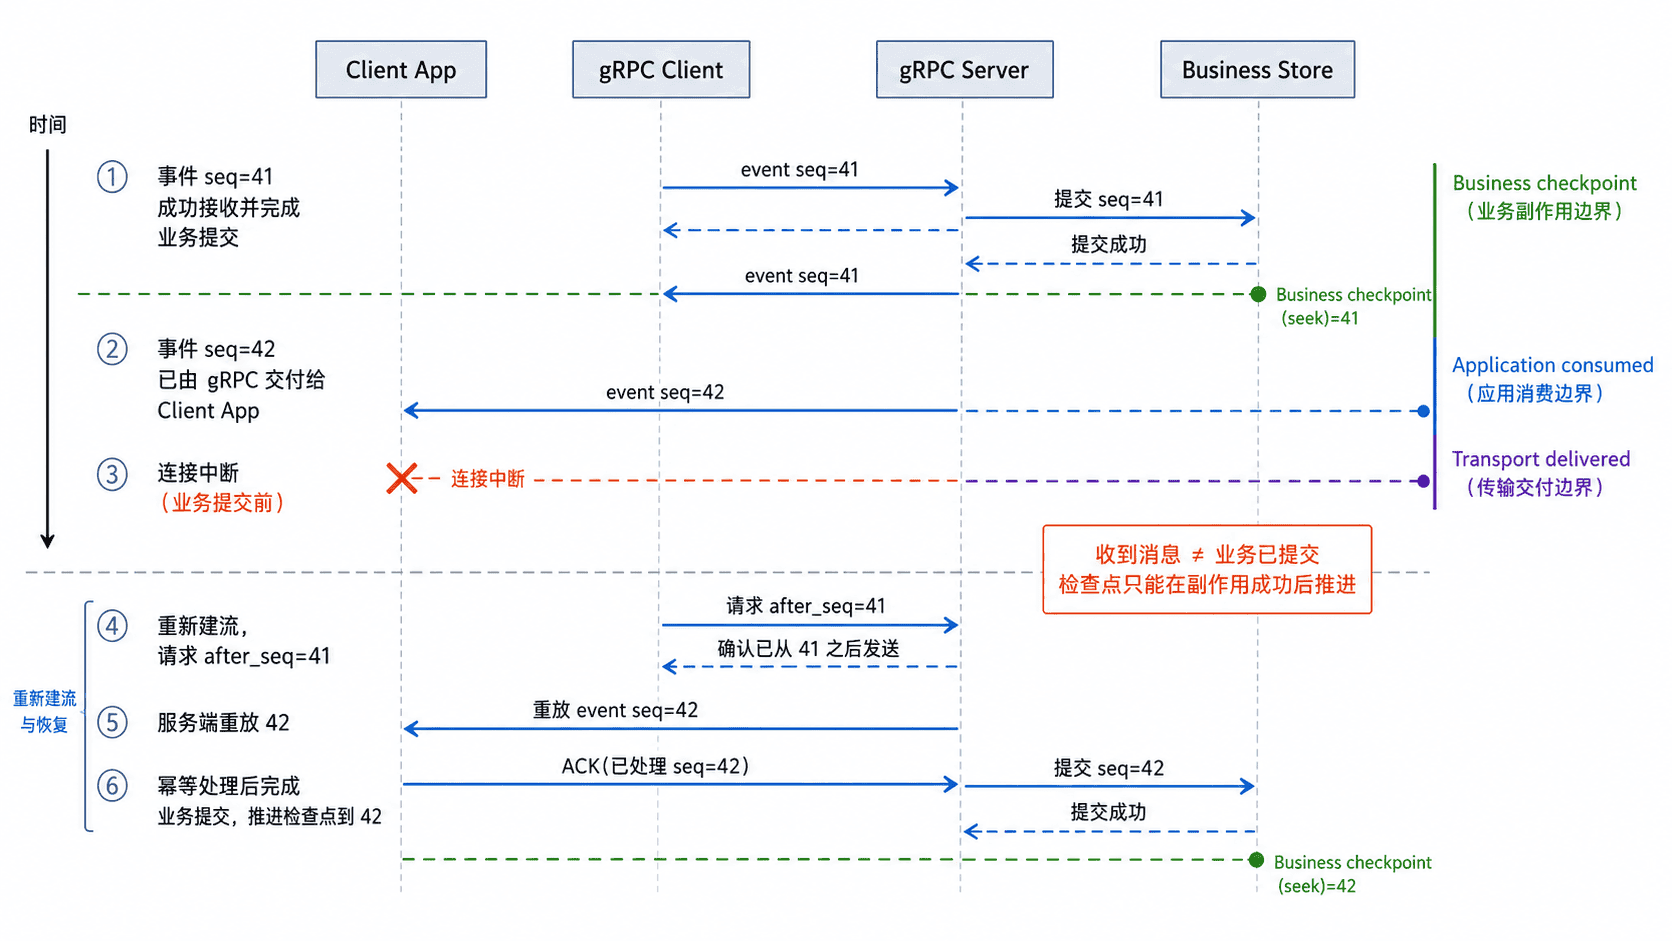
因此,恢复依据应该是业务已提交的进度,而不是最后一次 Recv() 或 Send() 成功返回的位置。尤其对写操作,Send() 成功只能说明本端已经接受该消息用于发送,不能证明对端应用已经读取,更不能证明业务副作用已经持久化。
选择与 RPC 类型匹配的恢复策略
Server Streaming 常见于事件订阅、日志拉取和持续结果流。稳妥的方式是让每条消息携带稳定的单调序号或游标,客户端只在业务处理成功后保存检查点;重新建流时携带该检查点,由服务端从下一个可恢复位置继续发送。
Client Streaming 和双向流更复杂,因为客户端无法仅凭本地 Send() 判断服务端是否已经处理某条消息。应用协议通常需要增加稳定消息 ID、序号和确认语义,例如由服务端返回“已持久化到序号 N”,客户端只重放尚未确认的部分。
对于扣款、设备控制等不能随意重复的业务操作,不能把“重新建流”直接等价为“重新发送”。这类消息必须结合幂等键、事务状态、补偿流程或人工确认,先确定业务事实,再决定是否重放。
用检查点实现 Server Streaming 续传
下面的接口定义是片段示例,依赖具体语言生成代码和服务端实现。核心约定是把恢复位置放在请求中,并让服务端返回带稳定序号的事件。
syntax = "proto3";

package events;

service EventService {
  rpc Watch(WatchRequest) returns (stream Event);
}

message WatchRequest {
  int64 after_seq = 1;
}

message Event {
  int64 seq = 1;
  string payload = 2;
}
这里约定 after_seq=41 表示 41 及之前的业务结果已经提交完成,服务端应从 42 或语义等价的位置继续。验证时可以主动断开流,再使用相同检查点重新调用 Watch,确认首条恢复消息符合这一契约。
客户端侧必须把检查点推进放在业务提交之后。下面是片段示例,其中 client、ctx、loadCheckpoint、handleAndCommit、saveCheckpoint、isRecoverable 和 waitBackoff 由应用提供。
checkpoint := loadCheckpoint()

for {
    stream, err := client.Watch(ctx, &eventspb.WatchRequest{
        AfterSeq: checkpoint,
    })
    if err != nil {
        return err
    }

    for {
        ev, err := stream.Recv()
        if err != nil {
            if !isRecoverable(err) {
                return err
            }
            waitBackoff(ctx)
            break // 暂时故障时退出内层循环并重新建流
        }

        if err := handleAndCommit(ev); err != nil {
            return err
        }

        // 只有业务副作用成功后,才推进可恢复进度。
        checkpoint = ev.Seq
        if err := saveCheckpoint(checkpoint); err != nil {
            return err
        }
    }
}预期结果是:连接中断后,新流从最后一个已提交检查点之后继续;如果事件 42 已提交业务结果但检查点尚未保存就发生崩溃,42 可能再次出现,因此 handleAndCommit 应按 seq 或稳定消息 ID 做幂等去重。条件允许时,应把业务结果与检查点写入同一个本地事务,缩小“业务已提交、检查点未推进”的故障窗口。
验证恢复边界
不要只测试服务端正常结束流。至少应覆盖三个故障窗口:消息到达前断链、应用读取后但业务提交前断链、业务提交后但检查点保存前崩溃。验收标准不是“没有重放”,而是最终业务结果不丢失,并且允许重放时不会产生重复副作用。
还要区分暂时故障与不可重试错误。UNAVAILABLE、连接重置等通常可以在退避后重新建流;INVALID_ARGUMENT、PERMISSION_DENIED 等请求或权限错误通常应直接暴露并修正。CANCELLED 与 DEADLINE_EXCEEDED 则要结合调用方是否主动取消、截止时间是否仍有效来判断,不能只看状态码机械重连。
Streaming RPC 的恢复核心不是“永远重试”,而是让通信双方对已经提交到哪里有稳定、可持久化的定义。恢复点来自业务进度,并且重放路径具备幂等性后,传输中断才能从随机故障变成可验证的恢复流程。