
架构与系统设计 / 系统课时
用 OpenTelemetry 追踪重试与选路
用 OpenTelemetry 追踪重试与选路
指标能告诉你重试和尾延迟在上升,却解释不了一次逻辑 RPC 内经历了几次 Attempt、每次在哪个阶段耗时。本课用 grpc-go 与 OpenTelemetry 建立完整 Trace:显式配置 TracerProvider、Trace Context propagator 和 otelgrpc stats handler,再用时间线定位重试、选路与 Deadline 消耗。
学习目标
- 建立“逻辑 RPC → Client Attempt → Server Span”的可排障 Trace 层次。
- 在 grpc-go 中显式接入 TracerProvider、propagator 与
otelgrpctracing instrumentation。 - 根据 Span 时间线区分重试退避、选路或建连等待、网络传输与服务端处理延迟。
先定义可排障的 Trace 层次
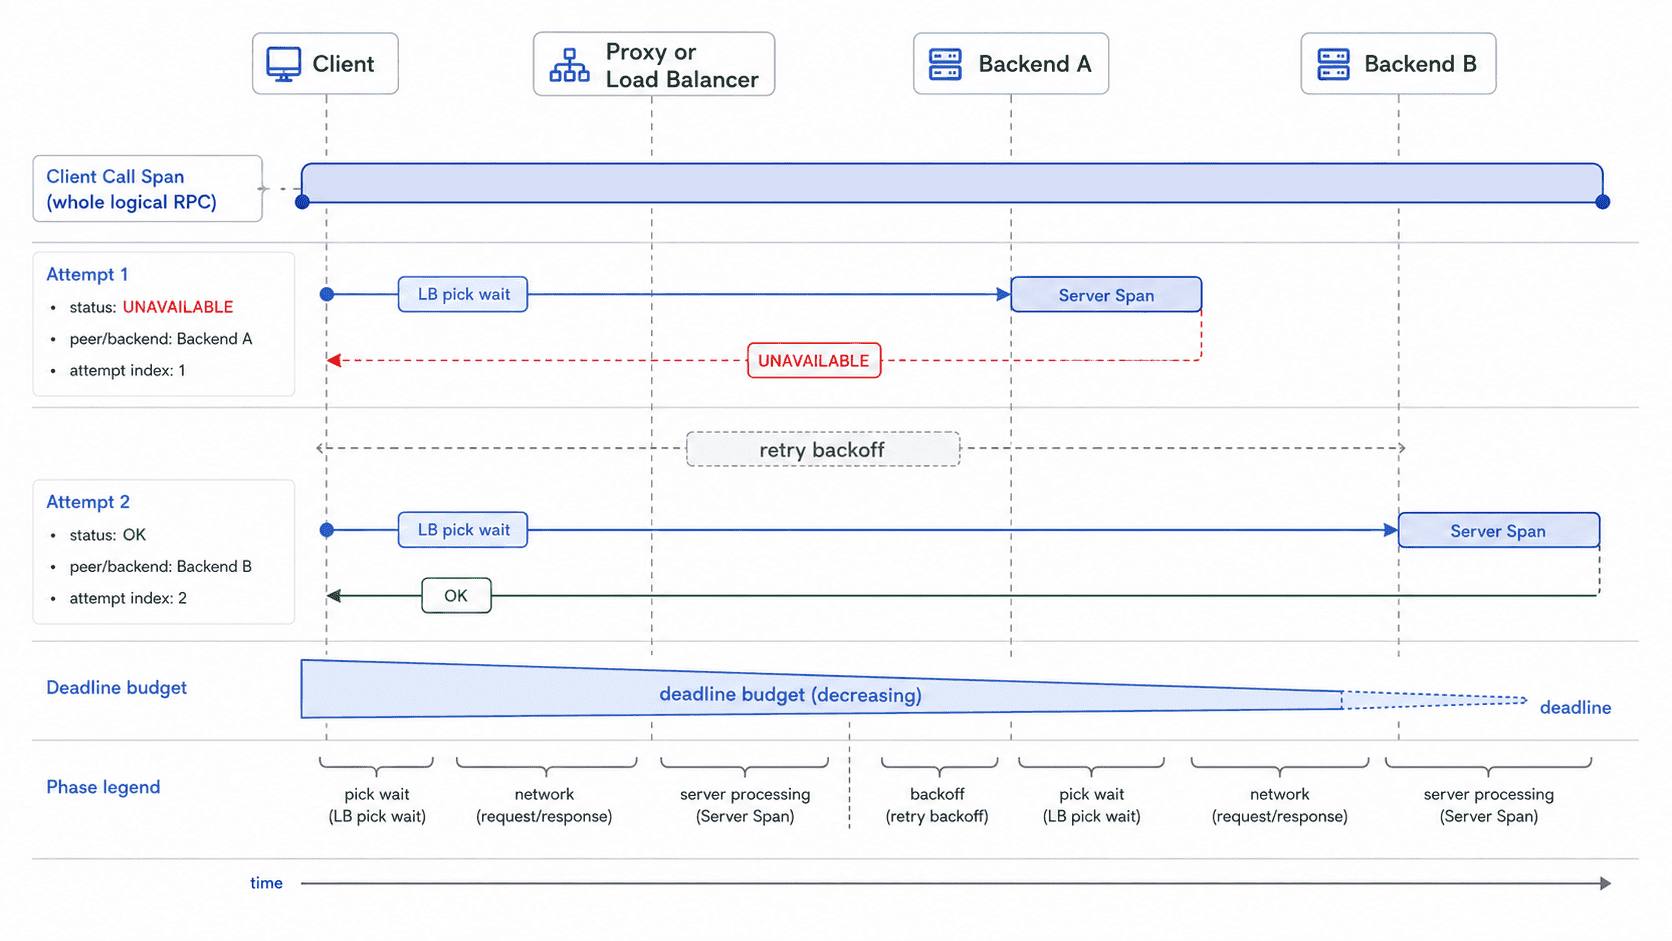
grpc-go 的一次应用调用可能产生多个传输 Attempt。otelgrpc.NewClientHandler 通过 grpc.WithStatsHandler 接入;grpc-go 会为每个 Attempt 触发一套 RPC stats 生命周期,因此客户端 instrumentation 会为每次 Attempt 创建独立 Client Span。服务端使用 otelgrpc.NewServerHandler 提取该 Attempt 注入的 Trace Context,再创建对应 Server Span。
如果还需要观察“从第一次尝试到最终成功、失败或取消”的总预算,应在应用调用外显式创建一个逻辑父 Span。这样父 Span 覆盖完整 Deadline,两次 Client Attempt 与各自 Server Span 都挂在同一条 Trace 下;Attempt 之间没有 Span 覆盖的空档,通常就是重试退避或下一次尝试尚未开始的等待。
接通 grpc-go 与 Collector
Collector 只接收、处理和导出 Trace,不会替 grpc-go 自动创建 Client Span 或 Server Span。先把下面配置保存为 otel-collector.yaml,让 Collector 在本机 4317 端口接收 OTLP/gRPC,并用 debug exporter 查看实验数据。
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: "0.0.0.0:4317"

processors:
  batch: {}

exporters:
  debug:
    verbosity: detailed

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch]
      exporters: [debug]
这份配置只定义采集链路;grpc-go 端仍必须创建 OTLP exporter 与 TracerProvider,并把同一个 TraceContext propagator 传给客户端和服务端的 otelgrpc handler。下面程序启动一个健康检查服务:第一次 Check 返回 UNAVAILABLE,客户端按 Service Config 重试一次并成功,同时创建逻辑 RPC 父 Span。
package main

import (
	"context"
	"fmt"
	"net"
	"sync/atomic"
	"time"

	"go.opentelemetry.io/contrib/instrumentation/google.golang.org/grpc/otelgrpc"
	"go.opentelemetry.io/otel/attribute"
	"go.opentelemetry.io/otel/exporters/otlp/otlptrace/otlptracegrpc"
	"go.opentelemetry.io/otel/propagation"
	"go.opentelemetry.io/otel/sdk/resource"
	sdktrace "go.opentelemetry.io/otel/sdk/trace"
	"google.golang.org/grpc"
	"google.golang.org/grpc/codes"
	"google.golang.org/grpc/credentials/insecure"
	healthpb "google.golang.org/grpc/health/grpc_health_v1"
	"google.golang.org/grpc/status"
)

type flakyHealthServer struct {
	healthpb.UnimplementedHealthServer
	calls atomic.Int32
}

func (s *flakyHealthServer) Check(
	context.Context,
	*healthpb.HealthCheckRequest,
) (*healthpb.HealthCheckResponse, error) {
	if s.calls.Add(1) == 1 {
		return nil, status.Error(codes.Unavailable, "transient failure")
	}
	return &healthpb.HealthCheckResponse{
		Status: healthpb.HealthCheckResponse_SERVING,
	}, nil
}

// 每个进程通常只需要一个 TracerProvider;本例同进程模拟客户端与服务端,
// 因而分别设置 service.name,便于在 Collector 输出中区分两侧资源。
func newTracerProvider(
	ctx context.Context,
	serviceName string,
) (*sdktrace.TracerProvider, error) {
	exporter, err := otlptracegrpc.New(
		ctx,
		otlptracegrpc.WithEndpoint("127.0.0.1:4317"),
		otlptracegrpc.WithInsecure(),
	)
	if err != nil {
		return nil, err
	}

	res, err := resource.New(
		ctx,
		resource.WithAttributes(attribute.String("service.name", serviceName)),
	)
	if err != nil {
		return nil, err
	}

	return sdktrace.NewTracerProvider(
		sdktrace.WithBatcher(exporter),
		sdktrace.WithResource(res),
		sdktrace.WithSampler(sdktrace.AlwaysSample()),
	), nil
}

func main() {
	ctx := context.Background()
	propagator := propagation.TraceContext{}

	// 服务端:显式传入 TracerProvider 和 propagator。
	serverTP, err := newTracerProvider(ctx, "retry-demo-server")
	if err != nil {
		panic(err)
	}
	defer func() { _ = serverTP.Shutdown(context.Background()) }()

	lis, err := net.Listen("tcp", "127.0.0.1:50051")
	if err != nil {
		panic(err)
	}

	server := grpc.NewServer(
		grpc.StatsHandler(otelgrpc.NewServerHandler(
			otelgrpc.WithTracerProvider(serverTP),
			otelgrpc.WithPropagators(propagator),
		)),
	)
	healthpb.RegisterHealthServer(server, &flakyHealthServer{})
	go func() {
		_ = server.Serve(lis)
	}()
	defer server.Stop()

	// 客户端重试策略:最多两次 Attempt,UNAVAILABLE 可重试。
	const serviceConfig = `{
      "methodConfig": [{
        "name": [{"service": "grpc.health.v1.Health", "method": "Check"}],
        "retryPolicy": {
          "maxAttempts": 2,
          "initialBackoff": "0.05s",
          "maxBackoff": "0.05s",
          "backoffMultiplier": 1.0,
          "retryableStatusCodes": ["UNAVAILABLE"]
        }
      }]
    }`

	clientTP, err := newTracerProvider(ctx, "retry-demo-client")
	if err != nil {
		panic(err)
	}
	defer func() { _ = clientTP.Shutdown(context.Background()) }()

	// 客户端:stats handler 会参与每个 Attempt 的生命周期并注入 Trace Context。
	conn, err := grpc.NewClient(
		"127.0.0.1:50051",
		grpc.WithTransportCredentials(insecure.NewCredentials()),
		grpc.WithDefaultServiceConfig(serviceConfig),
		grpc.WithStatsHandler(otelgrpc.NewClientHandler(
			otelgrpc.WithTracerProvider(clientTP),
			otelgrpc.WithPropagators(propagator),
		)),
	)
	if err != nil {
		panic(err)
	}
	defer conn.Close()

	callCtx, cancel := context.WithTimeout(ctx, 2*time.Second)
	defer cancel()

	// 逻辑父 Span 覆盖首次 Attempt、退避和重试后的最终结果。
	callCtx, logicalSpan := clientTP.Tracer("retry-demo").Start(
		callCtx,
		"logical grpc.health.v1.Health/Check",
	)
	resp, err := healthpb.NewHealthClient(conn).Check(
		callCtx,
		&healthpb.HealthCheckRequest{},
	)
	logicalSpan.End()
	if err != nil {
		panic(err)
	}

	fmt.Println("health:", resp.Status.String())
}
将程序保存为 main.go,在空目录初始化模块并运行。下面固定版本用于复现实验,首次执行时依赖下载日志可能不同。
go mod init retry-trace-demo
go get google.golang.org/grpc@v1.83.2
go get go.opentelemetry.io/contrib/instrumentation/google.golang.org/grpc/otelgrpc@v0.70.0
go get go.opentelemetry.io/otel/exporters/otlp/otlptrace/otlptracegrpc@v1.45.0 go.opentelemetry.io/otel/sdk@v1.45.0
go run .
预期输出:
health: SERVING这行只证明逻辑 RPC 最终成功。Collector 的具体文本格式会随版本变化,验证重点不是逐字匹配日志,而是同一个 Trace ID 下能看到逻辑父 Span、第一次 UNAVAILABLE 的 Client Attempt 与对应 Server Span,以及第二次成功的 Client Attempt 与 Server Span。若客户端和服务端落到不同 Trace,优先检查两端是否使用一致的 propagator,以及中间代理是否继续传播 Trace Context。
读懂重试与选路字段
按当前 OpenTelemetry gRPC 语义约定,优先关注 rpc.system.name=grpc、rpc.method、rpc.response.status_code、server.address 和 server.port。其中 server.address 表示 channel 面向的逻辑服务地址,语义上不应被当作“本次负载均衡实际选中的实例”。
实际 backend 可能由 network.peer.address、代理 Span、负载均衡层的可观测字段或自定义低基数属性提供,但具体是否由当前 instrumentation 自动填充要以实际 Span 为准。若需要显式记录 Attempt 序号、剩余 Deadline 或重试原因,可增加应用自定义属性;这些字段不是 grpc-go 或 otelgrpc 自动生成的标准字段。
{
  "app.grpc.attempt.index": 1,
  "app.grpc.deadline.remaining_ms": 180,
  "app.grpc.retry.reason": "UNAVAILABLE"
}
这只是属性设计片段,不是可独立运行的程序。生产环境不要把完整请求 ID、用户标识、认证 Metadata 或任意 backend 文本直接复制成指标标签,否则既可能泄漏敏感信息,也会制造高基数。
按时间线定位尾延迟
先看逻辑父 Span 的总时长,再按开始时间排列 Client Attempt,并与各自 Server Span 对齐。第一次 Attempt 很短且返回 UNAVAILABLE,随后出现几十毫秒空档,通常对应本例的重试退避;gRPC 重试退避带有随机抖动,因此不要把空档期望成固定的 50ms。
如果 Client Attempt 已开始但迟迟没有对应 Server Span,优先检查 picker 等待、连接建立、代理排队和传输阶段;如果 Client Attempt 很长而 Server Span 很短,问题更可能在后端之外;如果两边都长,则继续检查服务端处理和下游依赖。
DEADLINE_EXCEEDED 必须沿整条逻辑 Trace 解释。最后一次 Attempt 可能只拿到很少的剩余预算,真正的耗时已经发生在前一次失败、退避或选路等待中;只看最后一个 Server Span,很容易把超时责任错误归给最终后端。
让采样保住高价值故障
高 QPS 系统不适合长期 AlwaysSample,本例只为确保实验稳定。SDK 的头采样在 Span 开始时做决定,看不到最终错误、总延迟或是否发生多次 Attempt;如果要优先保留错误、接近 SLO 或发生重试的完整 Trace,应在 Collector 或后端采用尾采样,并保证采样决策点能接收到同一 Trace 的完整 Span 集合。
最终排障闭环应是:指标先发现重试率或尾延迟异常,Trace 再回答哪次 Attempt 失败、时间耗在哪个阶段、实际后端信息由哪一层提供,最后回到重试策略、负载均衡、代理或服务端完成修复。