
架构与系统设计 / 系统课时
按证据链排查 gRPC 生产故障
按证据链排查 gRPC 生产故障
gRPC 生产故障最容易被误判成“网络问题”或“服务端异常”。有效的排查方式是先固定一条失败 RPC,再沿 Status、Deadline、Resolver、Balancer、Subchannel、xDS 或 Envoy 到后端实例逐层收集证据,把范围持续收窄到可验证的根因。
学习目标
- 从失败 RPC 建立可复现的最小证据集,而不是先猜组件
- 使用 Channelz 与 CSDS/xDS 状态定位解析、连接和控制面问题
- 区分 proxyless gRPC 与 Envoy sidecar 两条数据路径,并验证修复是否真正生效
先固定一条失败样本
排查开始时先锁定同一条 RPC:记录客户端时间、完整方法名、target、gRPC Status、错误描述、Deadline、请求或 Trace ID、客户端版本以及所在实例。没有这组锚点,后续看到的 Resolver 日志、xDS 资源和后端指标很可能属于另一批请求。
DEADLINE_EXCEEDED 只说明调用方在截止时间前没有得到完成结果,并不能证明服务端没有执行成功;UNAVAILABLE 常见于瞬时连接或可用性问题,但也不能单凭状态码断定根因。先把 Status 当作入口证据,再继续向下验证。
沿真实数据路径逐层下钻
第一步不是打开 Envoy,而是确认部署模式。proxyless gRPC 可能由 gRPC 客户端直接消费 xDS 并连接后端,此时 Envoy 根本不在 RPC 数据路径上;sidecar 模式才需要把 Envoy 的路由、集群和连接状态纳入主证据链。
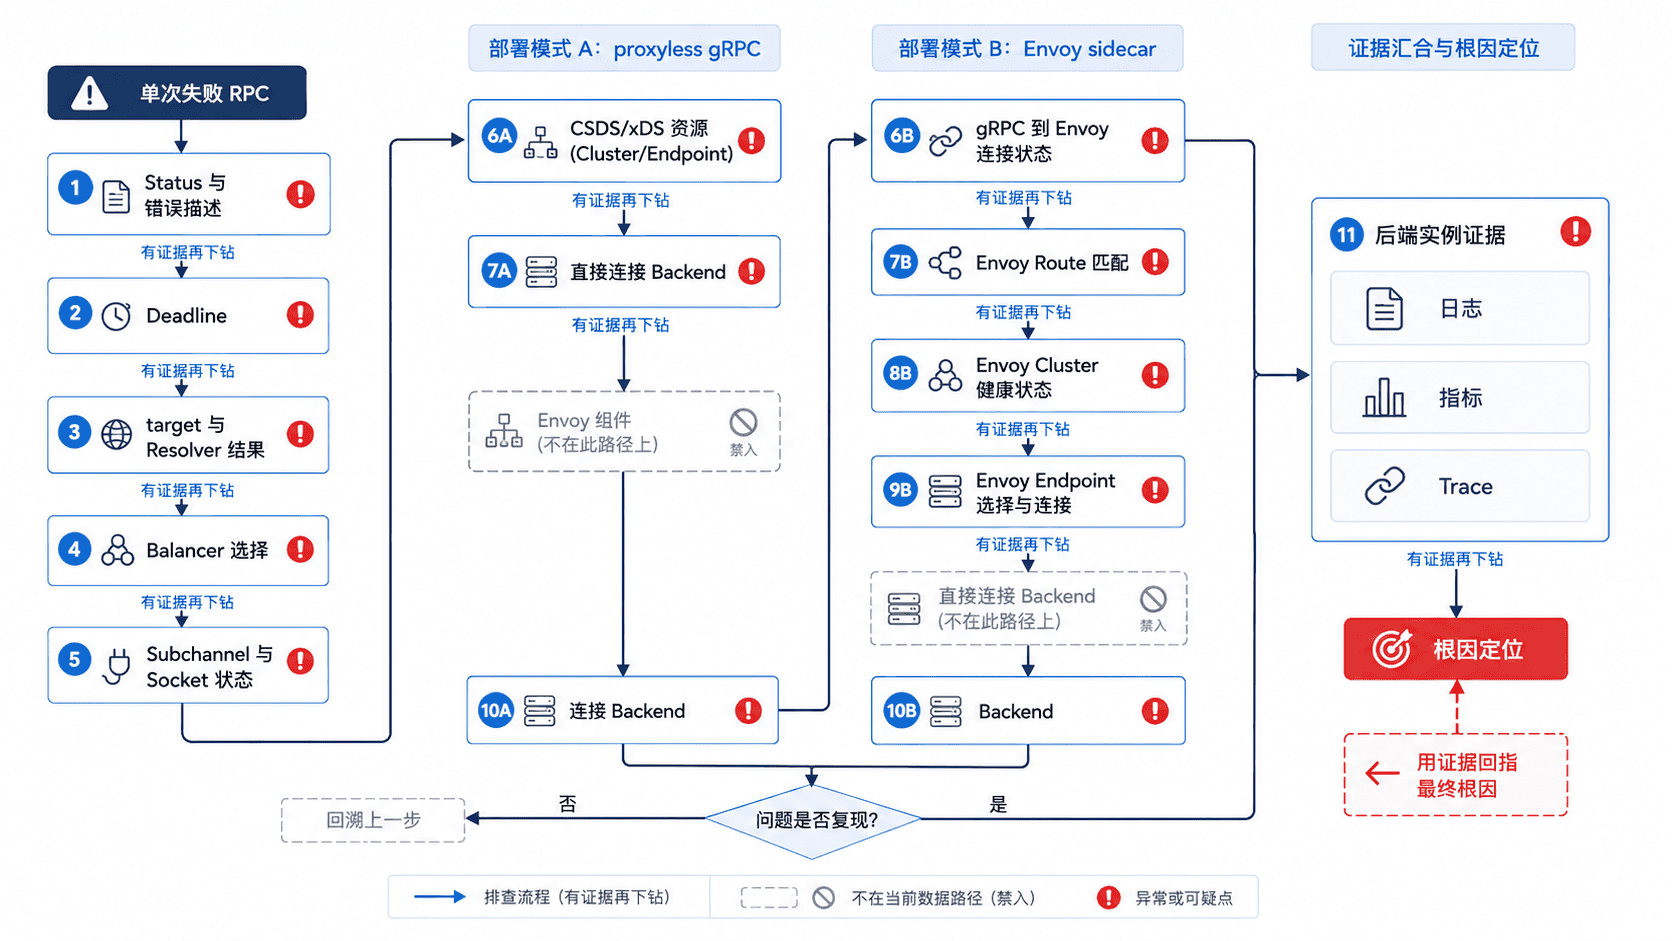
这张图的关键不是组件数量,而是排查顺序:上层证据正常才继续向下,发现异常就围绕该层做交叉验证。这样可以避免看到一个 UNAVAILABLE 就同时翻客户端、Envoy、控制面和所有后端日志。
用 Channelz 检查 Channel 与 Subchannel
如果应用启用了受保护的 gRPC Admin Services,grpcdebug 可以从 Channelz 读取 Channel、Subchannel、Socket 和调用统计。先列出客户端 Channel,确认 target 与连接状态:
grpcdebug <ADMIN_HOST>:<PORT> channelz channels预期结果会出现 Channel ID、Target、State 和调用统计;ID 与计数是动态值:
Channel ID   Target              State   Calls(Started/Succeeded/Failed)
<ID>         <TARGET>            READY   <VALUE>/<VALUE>/<VALUE>
若目标 Channel 不是预期 target,优先查客户端配置或名称解析入口;若 Channel 存在但长期不是 READY,继续查看指定 Channel:
grpcdebug <ADMIN_HOST>:<PORT> channelz channel <ID>预期结果应列出该 Channel 的 Subchannel 和状态信息;具体字段顺序可能随 grpcdebug 版本不同:
Channel ID:      <ID>
Target:          <TARGET>
State:           READY
...
Subchannel ID   Target       State
<ID>            <ADDRESS>    READY
如果 Channelz 中出现的后端地址符合预期,但某个 Subchannel 持续 TRANSIENT_FAILURE,证据就已从“名称解析入口”收敛到连接、TLS、网络路径或后端可达性;此时继续反复查 DNS 的价值很低。
核对 xDS 或 Envoy 的实际生效状态
在 proxyless xDS 模式中,重点确认客户端实际接受了哪些资源,而不是只看控制面期望下发什么。若启用了 CSDS,可直接查看 Endpoint 资源状态:
grpcdebug <ADMIN_HOST>:<PORT> xds config --type=eds预期结果应包含当前 Endpoint 资源及其客户端状态;地址、版本和资源名因环境而异:
dynamicEndpointConfigs:
  ...
  clientStatus: ACKED
  ...
出现 NACK 时应查看对应资源与错误信息,确认是字段不兼容、引用缺失还是资源本身非法。若资源是 ACKED 但调用仍失败,则继续核对其 Endpoint、权重和 locality,并与后端实际健康状态对照。
在 Envoy sidecar 模式中,证据链不同:先确认 gRPC 客户端连接的是本地或指定 Envoy,再检查 Envoy 当前 Route、Cluster、Endpoint 与 upstream 连接统计,最后核对后端。不要把 proxyless 客户端的 CSDS 状态与 Envoy 的配置状态混为一谈,它们属于不同数据面。
用证据组合收敛根因
单个信号通常不够,组合证据才有诊断力。例如:Channel READY、大多数 Subchannel 正常,但某个 Subchannel 失败率明显偏高,根因更可能落在该 Endpoint 或连接路径;所有 Subchannel 健康而大量 RPC 在同一 Deadline 附近失败,则优先检查预算是否过短、下游耗时是否上升,以及服务端是否及时响应取消。
如果 xDS 新版本刚发布后 NACK 激增,应优先停止继续发布并回退有问题的配置或版本;如果全部 ACKED 但错误率只在某个 locality 上升,则继续对比该 locality 的 Endpoint 与后端容量。若 Envoy upstream 失败而后端本身健康,再把范围收敛到代理到后端的 TLS、连接池、路由或网络路径。
验证修复而不是只看告警消失
修复后必须用原来的失败样本重新走一遍关键证据:同一方法和 target 的 Status 恢复、Deadline 有余量、Channel/Subchannel 状态稳定、xDS 或 Envoy 实际配置正确、后端错误与尾延迟回落。若只是重启后暂时恢复,但证据链中的异常没有解释清楚,故障仍未真正关闭。
一条可靠的 gRPC 排障链最终应能回答三个问题:失败发生在哪一层、哪条证据排除了相邻层、修复后哪些同类证据恢复正常。做到这一点,复杂生产故障就不再是“全栈同时排查”,而是范围不断缩小的验证过程。