
架构与系统设计 / 系统课时
完成多区域故障治理演练
完成多区域故障治理演练
这次演练把单实例过载、区域数据面失效和控制面变更放进同一条故障闭环,重点验证流量转移、重试约束、告警和回滚能否协同工作。验收必须落到指标与时间点,而不是只凭“最终恢复了”判断成功。
学习目标
- 为三类多区域故障定义可观测、可判定的验收条件。
- 验证局部过载时重试受预算约束,区域失效时请求能转移到健康区域。
- 完成故障注入、告警观察、回滚和恢复确认,并保留可复盘证据。
先写清演练边界和成功标准
假设服务同时部署在 Region A 和 Region B,客户端通过全局入口或 xDS 获得后端地址,每个区域有多个 gRPC 实例。优先在预生产环境执行;若必须在生产演练,应使用审批过的低风险窗口,并提前定义终止条件、回滚负责人和最大影响范围。
| 场景 | 故障注入 | 主要观察项 | 通过标准 |
|---|---|---|---|
| 单实例过载 | 只对 Region A 一个现有 Pod 注入 CPU 压力 | P95/P99、实例错误率、重试率、预算消耗 | 局部异常不演变成持续重试风暴,整体 SLO 在约定窗口内恢复 |
| 单区域失效 | 将 Region A 服务副本缩为 0 | 区域流量占比、成功率、切换时延 | 新请求转移到 Region B,错误率在约定窗口内恢复 |
| 控制面变更 | 发布一版经过评审的演练路由配置 | 配置版本、端点集合、区域权重、告警 | 异常能被发现,回滚后端点与权重恢复基线 |
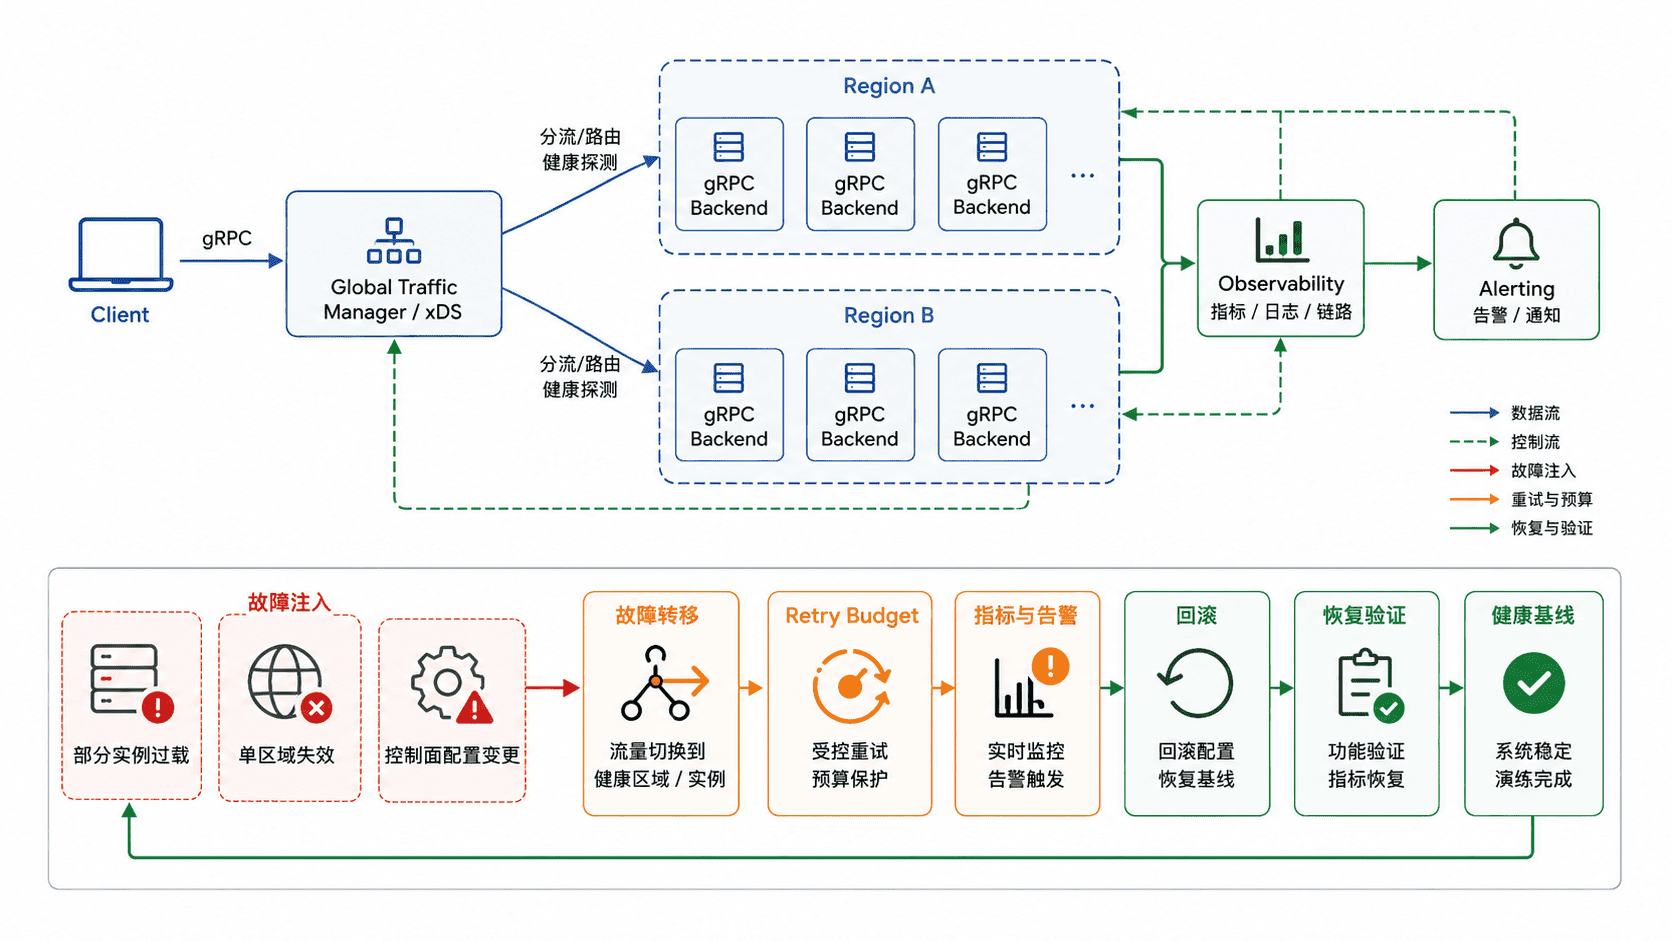
演练前记录成功率、P95/P99、每请求重试次数、Retry Budget 或 retry throttling 的可观测水位、各区域流量占比和当前控制面配置版本。不同客户端或网格的“重试预算”实现并不相同,验收时应以当前系统实际暴露的预算或限流指标为准。
建立基线并验证两个区域都可服务
下面示例假设两个 Kubernetes 上下文分别为 prod-region-a、prod-region-b,Deployment 为 grpc-backend,外部入口为 grpc.example.com:443。环境需要 kubectl 和 grpc-health-probe;命名空间、标签和副本数以实际环境为准。
set -euo pipefail

NAMESPACE=default
DEPLOYMENT=grpc-backend

for ctx in prod-region-a prod-region-b; do
  ready=$(kubectl --context "$ctx" -n "$NAMESPACE" get deployment "$DEPLOYMENT" -o jsonpath='{.status.readyReplicas}')
  desired=$(kubectl --context "$ctx" -n "$NAMESPACE" get deployment "$DEPLOYMENT" -o jsonpath='{.spec.replicas}')
  echo "$ctx: ${ready:-0}/${desired} ready"
done

grpc-health-probe -addr=grpc.example.com:443 -tls
预期输出
prod-region-a: <VALUE>/<VALUE> ready
prod-region-b: <VALUE>/<VALUE> ready
status: SERVING
实际副本数会因环境不同而变化。只有两个区域都健康、告警面板没有遗留异常,并且重试预算处于正常水位时才开始注入故障,否则本轮结果会被已有问题污染。
只让一个实例过载并观察重试约束
若直接对 deployment/grpc-backend 执行 kubectl set resources,会修改 Deployment Pod 模板并触发滚动更新,Region A 的多个副本都可能被替换,无法证明“部分实例过载”,同时还引入 rollout 变量。这里改用 Chaos Mesh 的 Pod 级 StressChaos,通过 mode: one 只命中一个带 app=grpc-backend 标签的现有 Pod。
执行前确认 Region A 已安装 Chaos Mesh,并核对该标签至少匹配两个业务 Pod;否则“单实例故障”没有对照组。
set -euo pipefail

NAMESPACE=default

cat <<'YAML' | kubectl --context prod-region-a -n "$NAMESPACE" apply -f -
apiVersion: chaos-mesh.org/v1alpha1
kind: StressChaos
metadata:
  name: grpc-backend-one-pod-cpu
spec:
  mode: one
  selector:
    namespaces:
      - default
    labelSelectors:
      app: grpc-backend
  stressors:
    cpu:
      workers: 1
      load: 100
  duration: "5m"
YAML
预期输出
stresschaos.chaos-mesh.org/grpc-backend-one-pod-cpu created注入期间持续发送与真实业务分布相近的请求,并同时观察被命中实例的 CPU、P95/P99、错误率、客户端重试次数和 Retry Budget。通过标准不是零重试,而是局部异常出现后,重试总量仍受既定预算或 retry throttling 约束,整体成功率和尾延迟在约定范围内恢复。
观察完成后删除故障对象,并确认被命中实例恢复正常。
kubectl --context prod-region-a -n default delete stresschaos grpc-backend-one-pod-cpu预期输出
stresschaos.chaos-mesh.org "grpc-backend-one-pod-cpu" deleted模拟单区域失效并恢复原副本数
将 Region A 的业务副本缩到 0,可以稳定模拟“该区域没有可服务的数据面实例”,适合测量端点摘除和跨区域接管;它不等同于真实网络隔离或整座区域基础设施失效。若 Deployment 受 HPA、KEDA 等控制器管理,应先使用演练环境批准的暂停或覆盖机制,否则自动伸缩器可能把副本数重新拉起。
执行前先读取并保存 Region A 的原副本数,再缩容到 0。这样恢复时不会把环境硬编码成 3 个副本。
set -euo pipefail

NAMESPACE=default
DEPLOYMENT=grpc-backend
STATE_FILE=/tmp/grpc-region-a-original-replicas

original=$(kubectl --context prod-region-a -n "$NAMESPACE" get deployment "$DEPLOYMENT" -o jsonpath='{.spec.replicas}')
printf '%s\n' "$original" > "$STATE_FILE"
echo "saved replicas: $original"

kubectl --context prod-region-a -n "$NAMESPACE" scale deployment "$DEPLOYMENT" --replicas=0
kubectl --context prod-region-a -n "$NAMESPACE" rollout status deployment "$DEPLOYMENT" --timeout=2m
grpc-health-probe -addr=grpc.example.com:443 -tls
预期输出
saved replicas: <VALUE>
deployment.apps/grpc-backend scaled
deployment "grpc-backend" successfully rolled out
status: SERVING
外部健康检查仍为 SERVING 只能证明至少还有可用后端,还要用区域维度指标确认 Region A 流量降到接近 0、Region B 接管请求,并记录从故障注入到成功率恢复的实际时长。
验证完成后从保存文件恢复原副本数,而不是写死副本数量。
set -euo pipefail

NAMESPACE=default
DEPLOYMENT=grpc-backend
STATE_FILE=/tmp/grpc-region-a-original-replicas

original=$(cat "$STATE_FILE")
test "$original" -ge 1

kubectl --context prod-region-a -n "$NAMESPACE" scale deployment "$DEPLOYMENT" --replicas="$original"
kubectl --context prod-region-a -n "$NAMESPACE" rollout status deployment "$DEPLOYMENT" --timeout=5m
rm -f "$STATE_FILE"
预期输出
deployment.apps/grpc-backend scaled
deployment "grpc-backend" successfully rolled out
如果 Region A 已无健康端点而客户端仍持续向其重试,优先检查端点摘除、服务发现传播延迟、负载均衡策略和重试预算是否按预期生效。
做一次控制面变更并完成回滚闭环
最后一轮验证控制面的配置发布与回滚。选择一项可逆、影响明确的演练变更,例如调整区域权重、端点优先级或故障转移阈值;变更必须有独立版本号,并能从观测系统中确认客户端当前接收的配置版本。由于 xDS 控制面的实现和发布接口并不统一,这里应使用当前平台真实的版本化发布机制,而不是编造“通用 xDS 命令”。
发布后检查客户端是否在预期时间内收到新配置、端点集合和区域权重是否符合预期、异常是否触发告警。若任一核心 SLO 越过预设终止条件,应立即回滚到上一稳定版本,而不是继续观察。
回滚后重新执行基线健康检查,并确认成功率、P95/P99、重试率、Retry Budget、区域流量占比和配置版本全部回到演练前范围。一次合格的多区域演练还应记录每个故障的注入时间、首次告警时间、流量转移完成时间、预算最低水位、回滚时间和恢复时间,使整个故障治理过程能够被日志和指标完整复盘。