
架构与系统设计 / 系统课时
设计指数退避与抖动
设计指数退避与抖动
指数退避决定失败后等待多久再试,随机抖动负责打散大量客户端的重试时刻。本课从 gRPC Retry Policy 的实际退避语义出发,结合 Deadline 计算可承受的尝试次数与等待预算,避免把重试变成新的流量峰值。
学习目标
- 能根据
initialBackoff、backoffMultiplier和maxBackoff推导每轮基础退避时间。 - 能解释 gRPC RPC 重试的 ±20% 随机抖动如何打散并发客户端。
- 能用 Deadline 约束
maxAttempts与总退避预算。
从公式看基础退避与实际等待
把第 次重试对应的基础退避记为 ,其中 表示第一次重试,则:
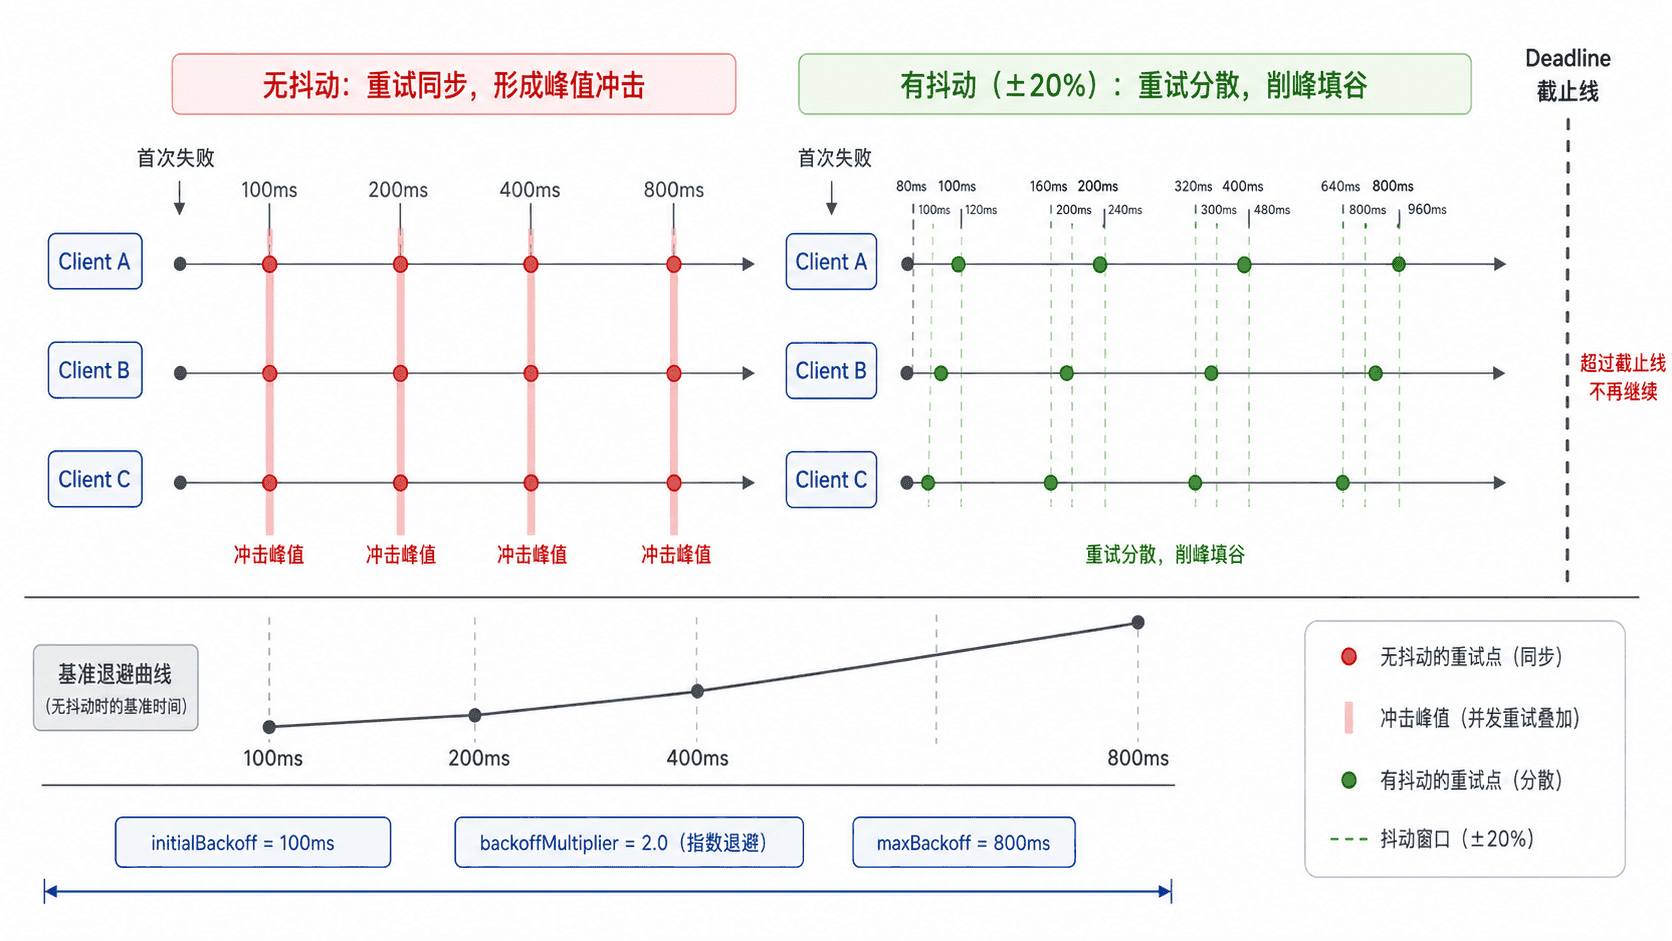
这里 是 initialBackoff, 是 backoffMultiplier, 是 maxBackoff。例如参数为 100ms、2、800ms 时,各轮基础退避依次为 100ms → 200ms → 400ms → 800ms,之后保持在 800ms。
gRFC A6 的 RPC Retry Policy 会在基础退避上乘以 0.8 到 1.2 之间的随机因子,而不是从 0 到当前退避上限之间做 full jitter。因此实际等待可写成 ,其中 在 [0.8, 1.2] 范围内均匀随机。以 800ms 为基础退避时,实际等待可能接近 640ms 到 960ms,所以 maxBackoff 限制的是抖动前的基础值。
抖动为什么能削峰
如果大量客户端同时收到 UNAVAILABLE,又全部严格等待 100ms、200ms、400ms,指数增长只会把同步流量峰值向后移动。加入随机因子后,同一轮客户端会分散在基础退避附近的不同时间点,后端恢复时的瞬时重试压力会降低。
不要把 RPC Retry Policy 与连接建立退避混为一谈。gRPC 的 Connection Backoff 也包含随机扰动,但它作用于底层连接尝试;RPC Retry Policy 作用于单次逻辑 RPC 的各个 attempt。两者处于不同层次,也不共享同一组 Service Config 参数。规范表述可分别对照 gRFC A6《Client Retries》和 gRPC《Connection Backoff Protocol》。
用小程序观察随机窗口
下面的程序不替代 gRPC 内置重试,而是按 gRFC A6 的 ±20% 抖动规则,计算每轮基础退避并为三个客户端生成独立等待时间。这样可以直接观察相同故障下的客户端为什么不会全部在同一时刻再次请求。
package main

import (
    "fmt"
    "math"
    "math/rand"
    "time"
)

func backoffBase(retry int, initial, max time.Duration, multiplier float64) time.Duration {
    // 先按指数增长计算本轮基础退避,再用 maxBackoff 封顶。
    base := float64(initial) * math.Pow(multiplier, float64(retry-1))
    if base > float64(max) {
        base = float64(max)
    }
    return time.Duration(base)
}

func jitteredDelay(r *rand.Rand, base time.Duration) time.Duration {
    // gRFC A6:在基础退避上乘以 [0.8, 1.2) 的随机因子。
    factor := 0.8 + 0.4*r.Float64()
    return time.Duration(float64(base) * factor)
}

func main() {
    r := rand.New(rand.NewSource(time.Now().UnixNano()))

    for retry := 1; retry <= 4; retry++ {
        base := backoffBase(retry, 100*time.Millisecond, 800*time.Millisecond, 2)
        low := time.Duration(float64(base) * 0.8)
        high := time.Duration(float64(base) * 1.2)
        fmt.Printf("retry=%d base=%v range=[%v,%v] samples=", retry, base, low, high)

        for client := 1; client <= 3; client++ {
            fmt.Printf("%v ", jitteredDelay(r, base))
        }
        fmt.Println()
    }
}
预期输出:
retry=1 base=100ms range=[80ms,120ms] samples=<VALUE> <VALUE> <VALUE>
retry=2 base=200ms range=[160ms,240ms] samples=<VALUE> <VALUE> <VALUE>
retry=3 base=400ms range=[320ms,480ms] samples=<VALUE> <VALUE> <VALUE>
retry=4 base=800ms range=[640ms,960ms] samples=<VALUE> <VALUE> <VALUE>
<VALUE> 每次运行都可能不同,但应落在所在行给出的抖动范围内。这个程序只生成“计划等待时长”,没有执行真实 Sleep,因此输出不受系统调度延迟影响。
从 Deadline 反推参数
maxAttempts 统计的是初始调用和后续重试的总尝试次数,而不是“额外重试次数”。例如 maxAttempts=4 时,最多只有 3 次重试,因此最多需要经历前三个退避阶段。
若最多有 次重试,并暂不考虑服务端 retry pushback,按 ±20% 抖动做保守估算时可使用:
以 initialBackoff=100ms、倍率 2、maxBackoff=800ms 为例,maxAttempts=5 最多产生 4 次重试,基础退避累计为 1500ms,加入抖动后的保守上界约为 1800ms。Deadline 还必须覆盖每个 attempt 的网络、排队和服务端处理时间,因此不能只给退避留预算。
设计参数时应先确定整次逻辑 RPC 的 Deadline,再预留一次正常调用所需的处理预算,最后决定剩余时间最多允许多少次重试。若后端已经明显过载,与其增加 maxAttempts,通常更应该减少尝试次数、扩大基础退避,并结合服务端 retry pushback 或客户端重试节流限制重试压力。
避免叠加和误重试
已经通过 Service Config 启用 gRPC 重试时,不要再在业务代码外层套一层同类重试循环,否则实际尝试次数可能成倍增长,Deadline 与退避预算也会变得难以推断。RPC 重试策略本身已经包含抖动,通常也不需要再额外手工 Sleep。
退避只能降低重试造成的瞬时压力,不能消除重复副作用。创建订单、扣款、发送消息等非天然幂等操作,只有具备幂等键、去重记录或等价保护后,才适合让可重试状态触发自动重放。