
架构与系统设计 / 系统课时
建立 RPC 与 Attempt 指标
建立 RPC 与 Attempt 指标
重试会让“用户只看到一次成功 RPC”与“系统实际执行了几次网络尝试”产生偏差。本课把逻辑 Call 与底层 Attempt 分开度量,并用 grpc-go v1.83.1 的原生 OpenTelemetry metrics instrumentation 产生真实指标,最后用放大系数识别被最终成功率掩盖的额外成本。
学习目标
- 区分一次逻辑 RPC Call 与一次实际 Attempt,理解重试和 Hedging 对指标口径的影响。
- 在 grpc-go 客户端与服务端启用 OpenTelemetry metrics instrumentation,并通过 OTLP 导出到 Collector。
- 用 Call 成功率、Attempt 错误率和放大系数识别“最终成功但成本已经升高”的故障。
把一次 RPC 拆成 Call 与 Attempt
应用发起一次 RPC,客户端最终只返回一次结果,这个应用视角的逻辑调用可以看作一个 Call。启用重试或 Hedging 后,一个 Call 可能创建多个 Attempt;每个真正到达服务端的 Attempt,又对应服务端看到的一次 Call。
因此“最终成功率 99.99%”并不等于系统没有故障。第一次 Attempt 可能以 UNAVAILABLE 失败,第二次才成功;业务仍得到 OK,但客户端延迟、网络流量和服务端负载都已经被放大。
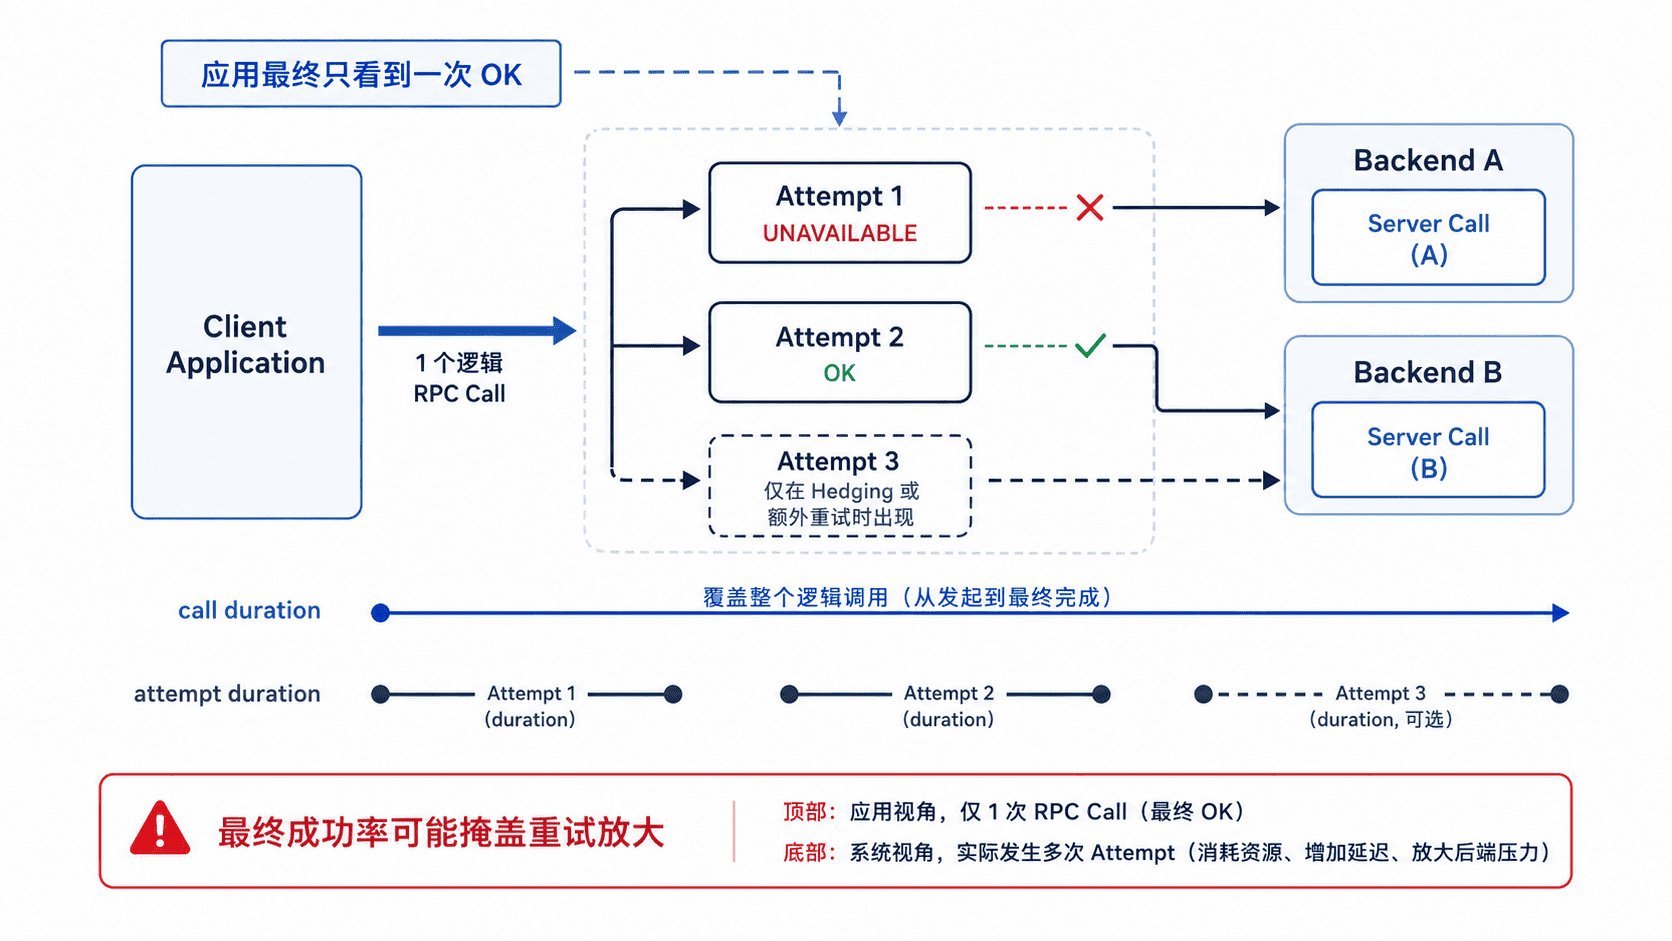
建立最小指标集
以 grpc-go v1.83.1 的默认 OpenTelemetry 指标为基线,先围绕稳定的 per-call、per-attempt 与 server call 指标建面板。重试或 Hedging 的专用统计即使实现提供,也可能属于实验性且默认关闭的指标,不应代替下面这组基础口径。
| 视角 | 指标 | 用途 |
|---|---|---|
| Client Call | grpc.client.call.duration |
统计应用视角的最终状态与端到端延迟 |
| Client Attempt | grpc.client.attempt.started |
统计实际启动了多少次 Attempt |
| Client Attempt | grpc.client.attempt.duration |
按 grpc.status 观察单次尝试延迟与失败 |
| Server Call | grpc.server.call.started |
统计服务端真正接收到的调用量 |
| Server Call | grpc.server.call.duration |
统计服务端处理延迟与最终状态 |
grpc.method、grpc.target 和 grpc.status 是核心聚合维度。不要把实例 IP、Trace ID、用户 ID 这类高基数字段塞进指标标签。
设稳定时间窗内完成的逻辑调用数为 ,启动的尝试数为 ,放大系数为 。 可由 grpc.client.call.duration 的 histogram count 得到;无重试或 Hedging 时 接近 1。若最终成功率稳定而 从 1.00 升到 1.25,说明系统已用额外流量换取表面成功。
Attempt 错误率则从 grpc.client.attempt.duration 按 grpc.status != OK 统计。由于 grpc.client.attempt.started 包含尚未完成的 Attempt,时间窗太短时放大系数会轻微偏斜,应使用稳定窗口,并与 Attempt duration 的完成计数一起核对。
在 grpc-go 中启用并产生指标
下面是一套主实验:同一进程同时启动服务端和客户端,服务端第一次 Health.Check 返回 UNAVAILABLE,客户端依据 service config 最多执行两次 Attempt。示例假设已安装 Go 1.25.x 与 otelcol-contrib,从空工作目录开始即可复现。
先准备 Go 模块和依赖:
mkdir grpc-metrics-lab
cd grpc-metrics-lab
go mod init grpc-metrics-lab
go get google.golang.org/grpc@v1.83.1
go get go.opentelemetry.io/otel/exporters/otlp/otlpmetric/otlpmetricgrpc@v1.44.0
go get go.opentelemetry.io/otel/sdk/metric@v1.44.0
printf 'deps-ready\n'
预期输出的末行:
deps-ready保存下面配置为 collector.yaml。它在 4317 接收 OTLP gRPC metrics,并通过 debug exporter 把原始指标写入日志。
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: "0.0.0.0:4317"

exporters:
  debug:
    verbosity: detailed

service:
  pipelines:
    metrics:
      receivers: [otlp]
      exporters: [debug]
启动 Collector:
otelcol-contrib --config collector.yaml > collector.log 2>&1 &
COLLECTOR_PID=$!
printf '%s\n' "$COLLECTOR_PID" > collector.pid
sleep 1
printf 'collector-started\n'
预期输出:
collector-started将下面程序保存为 main.go。关键点是创建非空的 MeterProvider,再把同一组 grpcotel.Options 分别通过 grpcotel.ServerOption 和 grpcotel.DialOption 安装到真实的 gRPC 服务端和客户端;只配置 Collector receiver 不会自动产生 gRPC 指标。
package main

import (
    "context"
    "fmt"
    "log"
    "net"
    "sync/atomic"
    "time"

    "go.opentelemetry.io/otel/exporters/otlp/otlpmetric/otlpmetricgrpc"
    sdkmetric "go.opentelemetry.io/otel/sdk/metric"
    "google.golang.org/grpc"
    "google.golang.org/grpc/codes"
    "google.golang.org/grpc/credentials/insecure"
    healthpb "google.golang.org/grpc/health/grpc_health_v1"
    grpcotel "google.golang.org/grpc/stats/opentelemetry"
    "google.golang.org/grpc/status"
)

type healthServer struct {
    healthpb.UnimplementedHealthServer
    calls atomic.Int32
}

func (s *healthServer) Check(context.Context, *healthpb.HealthCheckRequest) (*healthpb.HealthCheckResponse, error) {
    // 第一次服务端调用故意失败,让 retryPolicy 创建第二个 Attempt。
    if s.calls.Add(1) == 1 {
        return nil, status.Error(codes.Unavailable, "injected first-attempt failure")
    }
    return &healthpb.HealthCheckResponse{Status: healthpb.HealthCheckResponse_SERVING}, nil
}

func newMeterProvider(ctx context.Context) (*sdkmetric.MeterProvider, error) {
    exporter, err := otlpmetricgrpc.New(
        ctx,
        otlpmetricgrpc.WithEndpoint("127.0.0.1:4317"),
        otlpmetricgrpc.WithInsecure(),
    )
    if err != nil {
        return nil, err
    }

    // PeriodicReader 聚合 gRPC instrumentation 产生的指标并通过 OTLP 导出。
    reader := sdkmetric.NewPeriodicReader(exporter)
    return sdkmetric.NewMeterProvider(sdkmetric.WithReader(reader)), nil
}

func main() {
    ctx := context.Background()
    mp, err := newMeterProvider(ctx)
    if err != nil {
        log.Fatal(err)
    }
    defer func() {
        shutdownCtx, cancel := context.WithTimeout(context.Background(), time.Second)
        defer cancel()
        _ = mp.Shutdown(shutdownCtx)
    }()

    // MeterProvider 非空才会启用 grpc-go 的 OpenTelemetry metrics 记录。
    otelOpts := grpcotel.Options{
        MetricsOptions: grpcotel.MetricsOptions{
            MeterProvider: mp,
            Metrics:       grpcotel.DefaultMetrics(),
        },
    }

    lis, err := net.Listen("tcp", "127.0.0.1:0")
    if err != nil {
        log.Fatal(err)
    }
    hs := &healthServer{}
    server := grpc.NewServer(grpcotel.ServerOption(otelOpts))
    healthpb.RegisterHealthServer(server, hs)
    go func() {
        if err := server.Serve(lis); err != nil {
            log.Printf("server stopped: %v", err)
        }
    }()
    defer server.GracefulStop()

    // Health.Check 是幂等读操作,适合演示一次 UNAVAILABLE 后的自动重试。
    retryConfig := `{
      "methodConfig": [{
        "name": [{"service": "grpc.health.v1.Health", "method": "Check"}],
        "retryPolicy": {
          "maxAttempts": 2,
          "initialBackoff": "0.01s",
          "maxBackoff": "0.01s",
          "backoffMultiplier": 1,
          "retryableStatusCodes": ["UNAVAILABLE"]
        }
      }]
    }`

    conn, err := grpc.NewClient(
        lis.Addr().String(),
        grpc.WithTransportCredentials(insecure.NewCredentials()),
        grpc.WithDefaultServiceConfig(retryConfig),
        grpcotel.DialOption(otelOpts),
    )
    if err != nil {
        log.Fatal(err)
    }
    defer conn.Close()

    callCtx, cancel := context.WithTimeout(ctx, 2*time.Second)
    defer cancel()
    resp, err := healthpb.NewHealthClient(conn).Check(callCtx, &healthpb.HealthCheckRequest{})
    if err != nil {
        log.Fatal(err)
    }
    fmt.Printf("final status=%s server calls=%d\n", resp.GetStatus().String(), hs.calls.Load())

    // 不等待默认导出周期,退出前主动触发一次采集与导出。
    flushCtx, flushCancel := context.WithTimeout(ctx, time.Second)
    defer flushCancel()
    if err := mp.ForceFlush(flushCtx); err != nil {
        log.Fatal(err)
    }
}
运行程序:
go run .预期输出:
final status=SERVING server calls=2这里应用只得到一次最终成功结果,但服务端实际处理了两次调用,正好形成“一次 Call、两次 Attempt”的可观测场景。
验证指标与设置告警
程序结束后检查 Collector 日志。debug exporter 的数据点排版可能随 Collector 版本变化,因此只锁定指标名,不依赖完整日志格式。
grep -oE 'grpc\.(client\.(call\.duration|attempt\.(started|duration))|server\.call\.(started|duration))' collector.log | sort -u
kill "$(cat collector.pid)"
预期输出至少包含:
grpc.client.attempt.duration
grpc.client.attempt.started
grpc.client.call.duration
grpc.server.call.duration
grpc.server.call.started
如果 final status=SERVING server calls=2 已经证明发生了重试,却完全看不到 Attempt 指标,优先检查创建业务 ClientConn 时是否真正传入 grpcotel.DialOption(otelOpts),以及 MetricsOptions.MeterProvider 是否非空;服务端指标同理检查 grpcotel.ServerOption(otelOpts)。
告警不要只盯最终成功率。更有效的早期信号是“Call 成功率仍正常,但放大系数持续高于基线”,再联动 grpc.client.attempt.duration 中的 UNAVAILABLE、RESOURCE_EXHAUSTED 与 P95/P99 Call 延迟。若服务端 Call QPS 同步升高,说明重试成本已经真实传递到后端。