
架构与系统设计 / 系统课时
理解 Wait-for-Ready 行为
理解 Wait-for-Ready 行为
Wait-for-Ready 解决的不是失败后自动重试,而是连接暂时不可用时,这次 RPC 是否继续等待。弄清它与默认 fail-fast、Deadline 和 Retry 的边界后,就能在启动抖动或短暂无可用实例时延迟失败,同时避免请求无限排队。
学习目标
- 说清默认 fail-fast 与 Wait-for-Ready 在通道暂不可用时的差异
- 用 Deadline 为排队等待设置明确上限
- 区分 Wait-for-Ready 与 Retry 分别处理哪一阶段的失败
默认调用何时会快速失败
gRPC 通道可能处于 IDLE、CONNECTING、READY、TRANSIENT_FAILURE 或 SHUTDOWN。历史上所谓 fail-fast,重点是:当通道已经进入 TRANSIENT_FAILURE 时,默认 RPC 不继续等待连接恢复,而是尽快以不可用状态结束。它并不意味着 RPC 在 IDLE 或 CONNECTING 时一定立即失败;调用仍可能触发建连并等待连接结果。
启用 Wait-for-Ready 后,RPC 在通道处于 TRANSIENT_FAILURE 时也可以继续等待,直到连接再次可用于发送。若通道已经 SHUTDOWN,或 RPC 的 Deadline 先到,调用仍会终止。
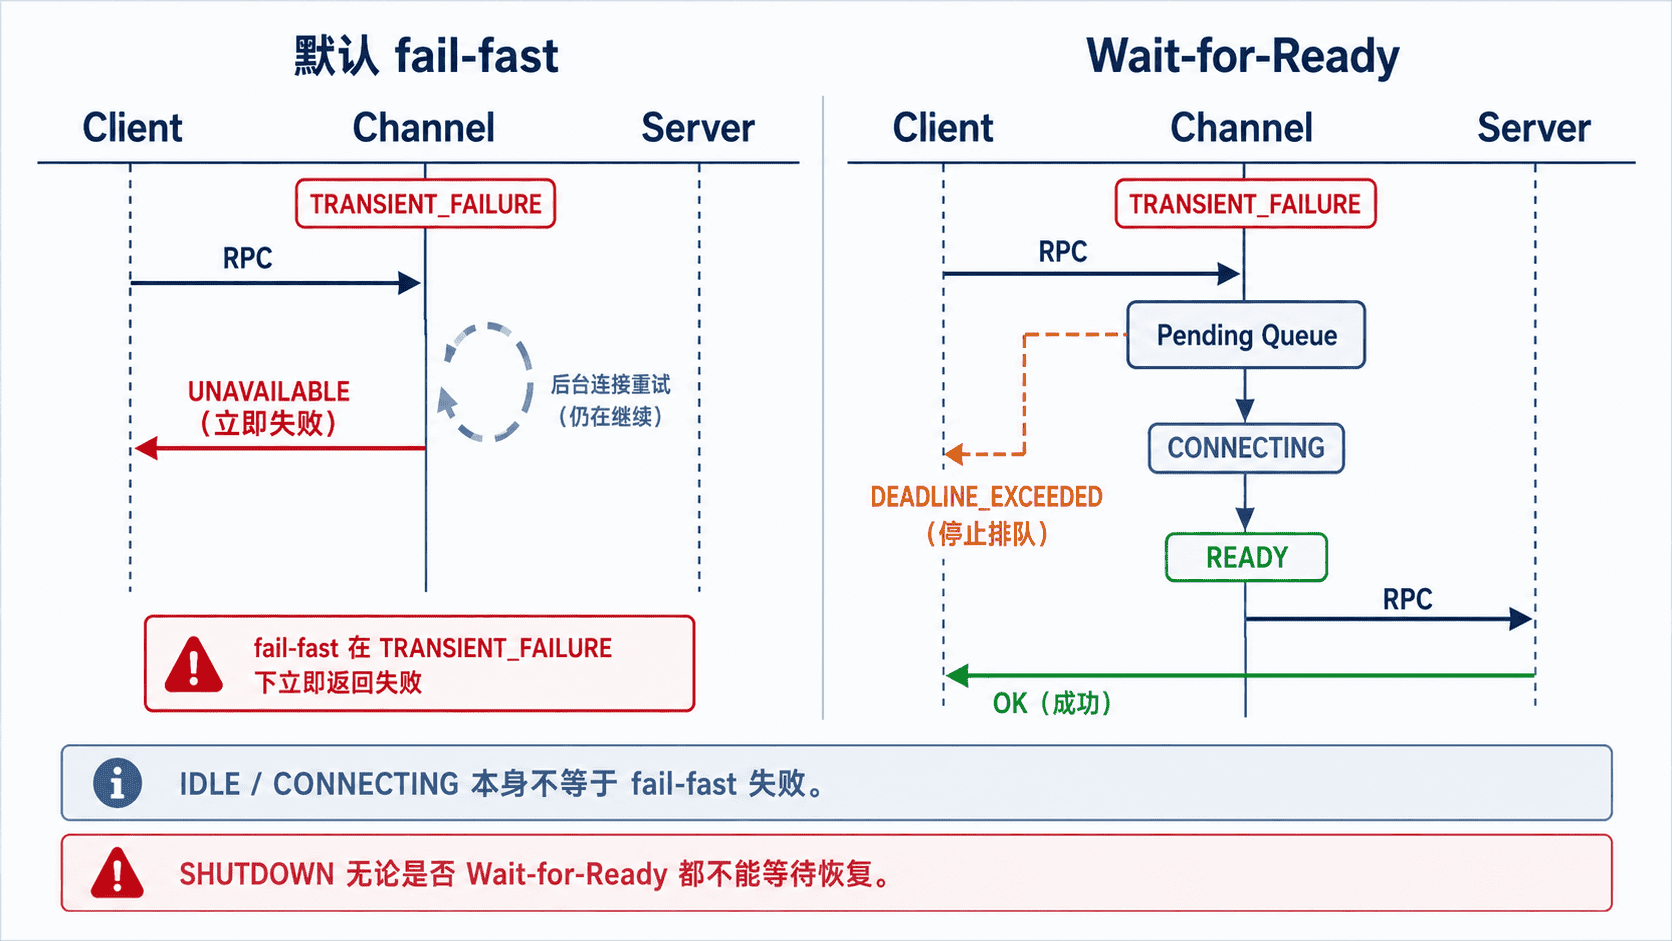
Wait-for-Ready 改变的是发送前等待
Wait-for-Ready 主要改变“当前还没有可用传输路径时”的调用行为:它允许 RPC 等待连接恢复,而不是因为通道进入 TRANSIENT_FAILURE 就立即结束。它不会把服务端返回的业务错误改成成功,也不会因为一次已发送的业务请求失败而自行重新执行该请求。
这与 Retry 的触发点不同:Retry 会在一次尝试失败且满足重试策略时创建新的尝试,可能再次把请求发送到服务端;Wait-for-Ready 则主要延长一次 RPC 在尚不能发送时的等待。两者可以同时使用,但排队预算、重试预算和写操作的幂等语义需要分别设计。
| 机制 | 主要处理的问题 | 是否会主动创建新的业务尝试 |
|---|---|---|
| Wait-for-Ready | 发送前暂时没有可用连接 | 否 |
| Retry | 已有尝试失败且满足重试条件 | 是 |
| Deadline | 限制整次 RPC 最长持续时间 | 否 |
用 Deadline 把等待时间封顶
开启 Wait-for-Ready 时必须同时考虑 Deadline,因为连接等待也消耗这次 RPC 的总时间预算。即使随后恢复到可发送状态,Deadline 也不会重新计时;剩余时间还要覆盖网络传输和服务端处理。
下面是 Go 的片段示例。它依赖已经通过 Protobuf 生成的 ordersv1.OrderServiceClient,并假设变量 client 已经连接到目标服务。
package main

import (
    "context"
    "log"
    "time"

    ordersv1 "example.com/orders/gen/orders/v1"
    "google.golang.org/grpc"
    "google.golang.org/grpc/status"
)

func getOrder(client ordersv1.OrderServiceClient) {
    // Deadline 同时限制连接等待、传输和服务端处理时间。
    ctx, cancel := context.WithTimeout(context.Background(), 1500*time.Millisecond)
    defer cancel()

    resp, err := client.GetOrder(
        ctx,
        &ordersv1.GetOrderRequest{OrderId: "order-123"},
        grpc.WaitForReady(true),
    )
    if err != nil {
        log.Printf("rpc failed: code=%s", status.Code(err))
        return
    }

    log.Printf("order=%s", resp.OrderId)
}
预期输出(后端在 1.5 秒内恢复,并在 Deadline 前完成调用):
<TIME> order=order-123预期输出(Deadline 在连接恢复或 RPC 完成前到达):
<TIME> rpc failed: code=DeadlineExceeded<TIME> 为日志时间,实际值会不同。这里的关键不是 1.5 秒本身,而是等待连接恢复的时间与后续执行时间共享同一个 RPC Deadline。
什么时候适合开启
Wait-for-Ready 适合“短暂不可用时多等一会儿,比立即失败更合理”的调用,例如批处理任务启动时依赖服务仍在拉起,或扩缩容过程中短时间没有可用后端。调用方接受有限等待,可以减少瞬时连接故障暴露给业务层的次数。
对强交互、低延迟接口则要谨慎。大量请求在不可用期间排队,会把故障从快速失败转化为更高的内存占用和尾延迟;如果上游需要尽快触发降级、熔断或备用路径,默认行为通常更合适。
验证时可以制造通道进入 TRANSIENT_FAILURE 的条件再发起调用:默认模式应较快返回不可用;启用 Wait-for-Ready 后,在较长 Deadline 内恢复服务应能成功,而 Deadline 先耗尽时应得到 DEADLINE_EXCEEDED。这组现象验证的是“有限时间内等待可发送条件”,而不是无限重试。