
架构与系统设计 / 系统课时
划清客户端与 Envoy 的重试边界
划清客户端与 Envoy 的重试边界
这一课解决重试到底应该放在哪一层的问题:先比较 gRPC 客户端与 Envoy 能看到的失败信息,再算清嵌套重试的放大倍数,最后用单一主责和明确预算把一次逻辑调用限制在可控范围内。
学习目标
- 区分客户端重试与 Envoy 重试各自能可靠判断的失败语义。
- 计算两层重试叠加后的上游尝试上限,并把总 deadline 纳入预算。
- 配置单一重试主责层,并用客户端与 Envoy 的尝试指标验证没有嵌套放大。
先按可见性决定重试主责
客户端离业务语义最近。它知道调用的是哪个 gRPC 方法、调用方设置了什么 deadline,也更容易判断操作是否只读、是否携带幂等键,以及一次逻辑调用已经尝试了多少次。Envoy 更接近网络和上游实例,擅长处理连接失败、流重置、上游主机切换和代理侧超时。
| 维度 | gRPC 客户端 | Envoy |
|---|---|---|
| 最清楚的信息 | 方法、deadline、幂等语义、调用级 attempt | 连接、流重置、上游主机、代理尝试次数 |
| 更适合处理 | 与方法语义绑定的可重试失败 | 连接建立失败、实例级瞬时故障 |
| 主要盲区 | 不一定知道代理内部换过几次上游 | 通常不知道业务副作用是否已经发生 |
| 典型观测 | grpc.client.attempt.*、调用级 trace |
%UPSTREAM_REQUEST_ATTEMPT_COUNT%、response flags |
因此,先判断操作能不能安全重复,再讨论谁来重试。即使状态是 UNAVAILABLE,写操作如果没有幂等保护,也不能仅凭状态码认定“服务端一定没执行”;DEADLINE_EXCEEDED 或取消同样不能证明服务端已经停止执行。
先算清嵌套尝试上限
两个配置里的“次数”口径不同。gRPC retryPolicy.maxAttempts 表示包括首次调用在内的总 attempt 数;Envoy num_retries 表示首次上游尝试之外还能追加多少次重试。
例如客户端 maxAttempts = 3,Envoy num_retries = 2,最坏情况下一个逻辑 RPC 可以触发 3 × (1 + 2) = 9 次上游尝试。九次尝试不等于一定产生九个业务副作用,但只要某些尝试已经到达应用层,重复执行风险就已经存在。
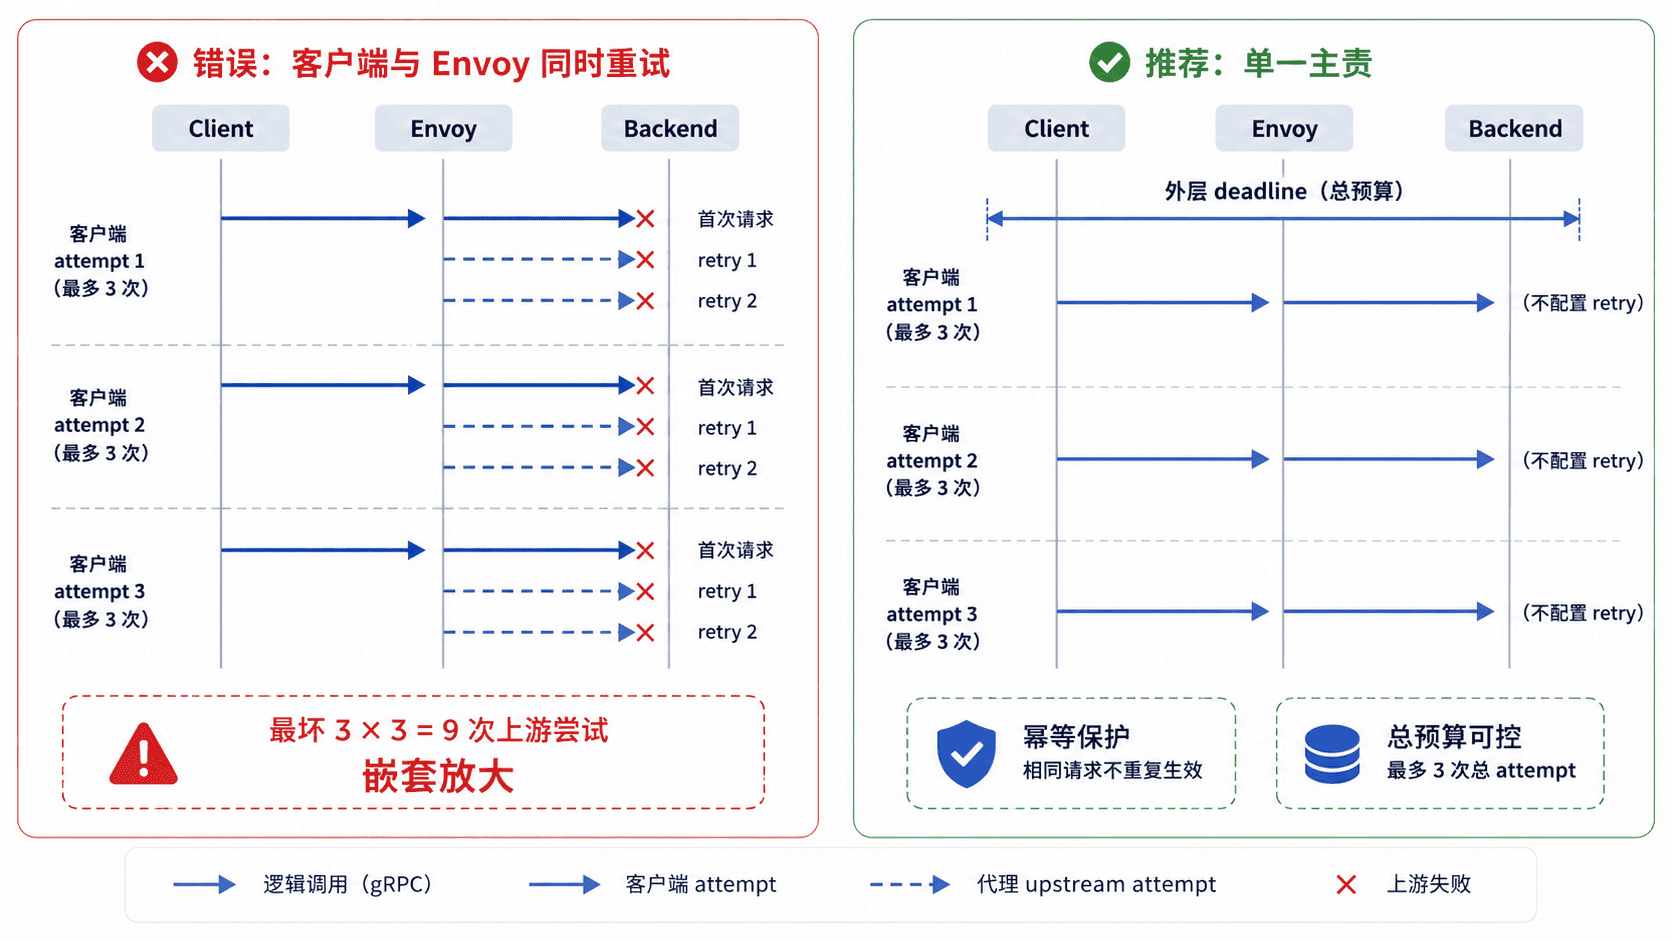
deadline 也不能分层各算一份。客户端的外层 deadline 应覆盖整个逻辑调用;任何代理侧 per-try timeout 或 route timeout 都必须落在这个剩余预算内,否则上游仍在尝试时,调用方可能已经放弃,只会制造额外无效负载。
选择单一主责或显式分摊
优先采用单一主责层。如果客户端版本可治理,而且重试条件明显依赖方法语义,通常让 gRPC 客户端负责应用级重试更清楚:策略可以按 service/method 下发,调用方也能把幂等键、deadline 与一次逻辑调用绑定起来。
如果调用方非常异构,或者主要问题是 Envoy 到上游的连接建立、实例切换和短暂网络故障,可以让代理承担主责,但客户端就不要再配置同类显式 retry。若确实必须两层都保留,应按失败阶段和次数拆预算,例如 Envoy 只处理确认尚未进入业务执行的连接级失败,客户端只处理有幂等保护的应用级失败,并计算两层联合上限。
配置客户端作为重试主责
下面采用最容易审计的一种边界:客户端负责 GetOrder 的显式重试,Envoy 不配置 route retry。GetOrder 是只读方法,因此允许对 UNAVAILABLE 做有限重试;写方法只有在具备幂等键或等价保护后才能采用同样策略。
片段示例:gRPC Service Config 把总 attempt 限制为 3,并给整个逻辑调用设置 1.2 秒 timeout。
{
  "methodConfig": [
    {
      "name": [
        {
          "service": "orders.v1.OrderService",
          "method": "GetOrder"
        }
      ],
      "timeout": "1.2s",
      "retryPolicy": {
        "maxAttempts": 3,
        "initialBackoff": "0.1s",
        "maxBackoff": "0.4s",
        "backoffMultiplier": 2,
        "retryableStatusCodes": [
          "UNAVAILABLE"
        ]
      }
    }
  ]
}
生效行为:首次 attempt 失败且满足策略时,客户端会在剩余 deadline 内按退避再次发起调用;maxAttempts: 3 包含首次 attempt。gRPC retry 一旦进入“已提交”状态,例如客户端已经收到初始响应头,后续策略重试就不会再继续。
片段示例:Envoy 对该 gRPC 路由只负责转发,不声明 retry_policy。
routes:
  - match:
      prefix: "/orders.v1.OrderService/"
    route:
      cluster: order_backend
生效行为:在该路由没有其他继承或覆盖的重试配置时,Envoy 不增加路由级 retry,客户端成为应用级重试主责。gRPC 运行时仍可能发生透明重试等传输级行为;其具体开关与限制能力取决于语言实现,因此容量模型应以故障注入和 attempt 指标的实测结果为准。
用三个数字验收边界
故障注入时同时观察逻辑调用数、客户端 attempt 数和 Envoy 上游尝试数。在只触发配置型 retry 的场景里,客户端一次逻辑调用最多应出现 3 个策略性 attempt;如果 grpc.client.attempt.started 还更多,要继续排查透明重试或其他中间层。
常规 HTTP/2 gRPC 路径中,Envoy access log 的 %UPSTREAM_REQUEST_ATTEMPT_COUNT% 对每个进入代理的下游请求应保持为 1,因为代理没有配置 route retry。最后再核对业务侧幂等命中或写入次数。只要看到“客户端 attempt 增长”和“Envoy upstream attempt 也同步大于 1”,就说明重试边界重新变成了乘法关系;此时应先收紧主责和预算,而不是继续增加重试次数。