
架构与系统设计 / 系统课时
用压测调优重试与负载均衡
用压测调优重试与负载均衡
这节课解决一个常见误区:压测不是把 QPS 打高,而是在固定负载和故障条件下证明可靠性参数是否真的改善结果。你会比较逻辑错误率、尾延迟、重试放大和后端流量分布,再逐项调整 Deadline、退避、并发上限与负载均衡策略。
学习目标
- 设计可重复的 gRPC 固定负载实验,避免同时改变多个变量
- 用逻辑请求与实际尝试两个视角识别重试放大、尾延迟和后端倾斜
- 按证据调整 Deadline、退避、并发上限和流量策略,并完成回归验证
固定负载与故障条件
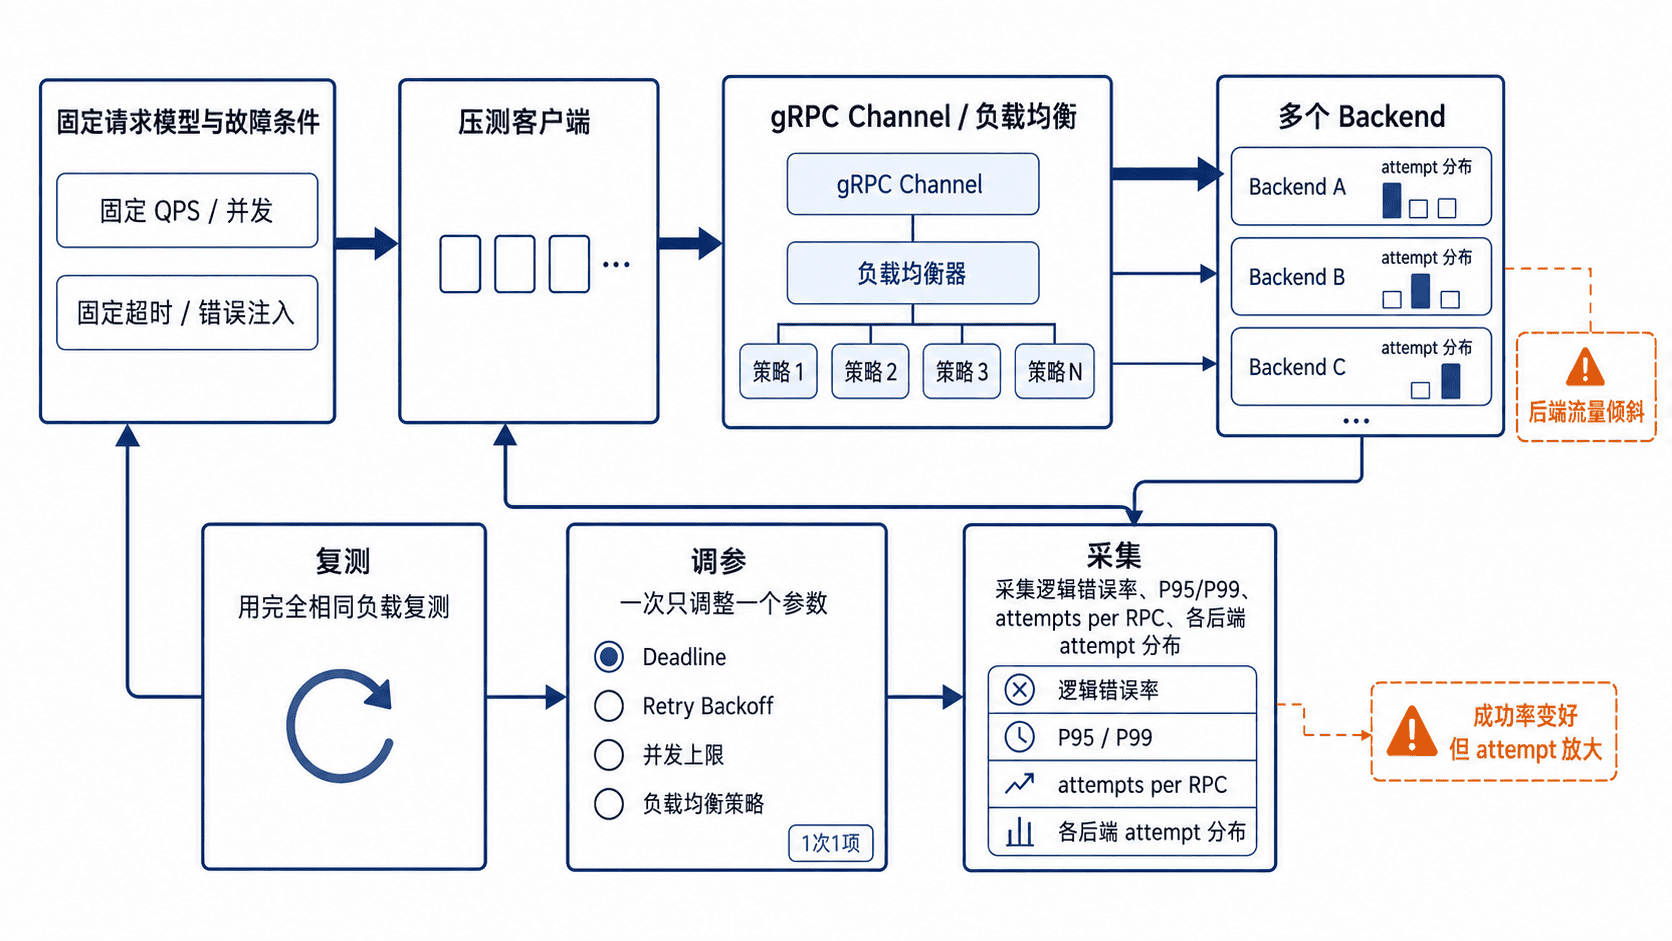
调优前先固定请求模型、并发或到达率、请求体、测试时长、后端实例数,以及注入的延迟或错误比例。否则一次测试改并发、下一次又改故障率,P99 变化就无法归因。
建议至少记录四组指标:逻辑 RPC 错误率、P95/P99 延迟、每个逻辑 RPC 的平均 attempt 数,以及各后端收到的 attempt 数。这里要区分“请求”与“尝试”:一次逻辑 RPC 可能因为重试产生多个 attempt,成功率上升也可能伴随后端压力显著增加。
跑一组可复现基线
下面示例使用 ghz 对同一个 RPC 发送固定总请求数和固定并发。它依赖已经可访问的 gRPC 服务、对应的 .proto 文件,以及本机已安装 ghz;--call 要替换成真实全限定方法名。基线测试期间不要同时修改服务端容量、故障注入比例或客户端策略。
ghz \
  --insecure \
  --proto ./api.proto \
  --call demo.v1.Catalog/GetItem \
  --data '{"id":"bench-1"}' \
  --concurrency 32 \
  --total 20000 \
  127.0.0.1:50051
预期输出会包含请求总数、平均延迟、请求速率、延迟分位和状态码分布;实际数值取决于机器与服务端负载。
Summary:
  Count:        <VALUE>
  Total:        <TIME>
  Slowest:      <TIME>
  Fastest:      <TIME>
  Average:      <TIME>
  Requests/sec: <VALUE>
Latency distribution:
  50 % in <TIME>
  90 % in <TIME>
  99 % in <TIME>
Status code distribution:
  [OK] <VALUE> responses
ghz 的客户端摘要只能回答端到端结果。要判断重试与负载均衡是否健康,还要从客户端、代理或服务端指标补上 attempt 次数、UNAVAILABLE、DEADLINE_EXCEEDED 等状态,以及每个后端实例的请求量。动态值如 <TIME>、<VALUE> 每次运行都可能不同。
一次只调一个可靠性旋钮
先看 Deadline。它应覆盖正常请求的大多数延迟,但不能长到让已无业务价值的调用继续占用资源。若 P99 经常贴近 Deadline 且 DEADLINE_EXCEEDED 增多,应先确认后端是否变慢或排队,而不是直接放大 Deadline 掩盖容量问题。
再看重试。gRPC Service Config 中的 maxAttempts 表示原始尝试加后续重试的总 attempt 数,不是“额外重试次数”。如果逻辑错误率下降,但 attempts / RPC 从接近 1 快速升高,说明重试正在放大压力。此时应优先收窄可重试状态、降低最大尝试数,并保留退避;若使用的实现支持抖动,也应避免大量客户端同步重试。
并发上限决定故障时系统能积压多少工作。正常流量下吞吐没问题、故障注入后在途请求与排队同时飙升,通常说明客户端、网关或服务端缺少并发约束。应把上限控制在后端可持续容量以内,再观察拒绝、排队和尾延迟是否可控。
最后比较负载均衡。不要只看总 QPS;应检查每个后端的 attempt 数和延迟。如果少数实例持续偏热,先排除连接数、健康状态和地址发现差异,再比较 round_robin 等候选策略。负载策略改变后必须保持同一负载与故障模型复测,否则无法判断倾斜是否真的改善。
用同一组指标判断改善
每轮只改一个变量,并把结果放进同一张表。判断标准不是“某个数字更小”,而是业务目标和资源代价是否同时可接受。
| 观察项 | 改善信号 | 退化信号 |
|---|---|---|
| 逻辑 RPC 错误率 | 在相同故障率下降 | 下降很少或反而升高 |
| P99 | 稳定或下降 | 因重试或排队明显上升 |
| attempts / RPC | 接近 1,故障时有限增加 | 持续接近最大尝试数 |
| 后端分布 | 各实例接近预期比例 | 少数实例长期偏热 |
| 在途并发 | 故障时仍受控 | 随重试与超时持续堆积 |
一个候选参数集只有在多轮相同负载下都满足错误率、P99、重试放大和容量门槛,才值得进入生产灰度。若成功率提高的代价是 attempts 和尾延迟同时恶化,那不是“更可靠”,只是把失败从客户端转移成了后端过载。