
架构与系统设计 / 系统课时
设计负载削减与准入控制
设计负载削减与准入控制
过载时最危险的做法不是拒绝请求,而是把所有请求都塞进队列,最终让它们一起超时。本课用 Deadline、有界等待队列、执行并发上限和优先级组成准入门,主动削减低价值负载,为核心 RPC 保留可用容量。
学习目标
- 能按 Deadline、优先级、等待队列和执行并发设计准入顺序
- 能用 gRPC Unary Interceptor 在业务处理前拒绝过载请求
- 能用压测指标判断削减是否真正保护了核心 RPC
先把过载变成可控拒绝
Load shedding 的目标不是“让错误率变成零”,而是在容量不足时把失败限制在入口。请求一旦进入昂贵的数据库查询、下游调用或大对象计算,再超时退出,已经消耗了最稀缺的资源,还会继续推高排队时间。
一个实用的准入链路可以按“剩余 Deadline → 优先级 → 执行容量 → 有界等待”组织:Deadline 明显不足时尽早返回;核心流量可以使用普通流量不可占用的部分执行容量;执行槽位暂时不足时,只允许有限数量的请求等待;等待区已满则立即拒绝。
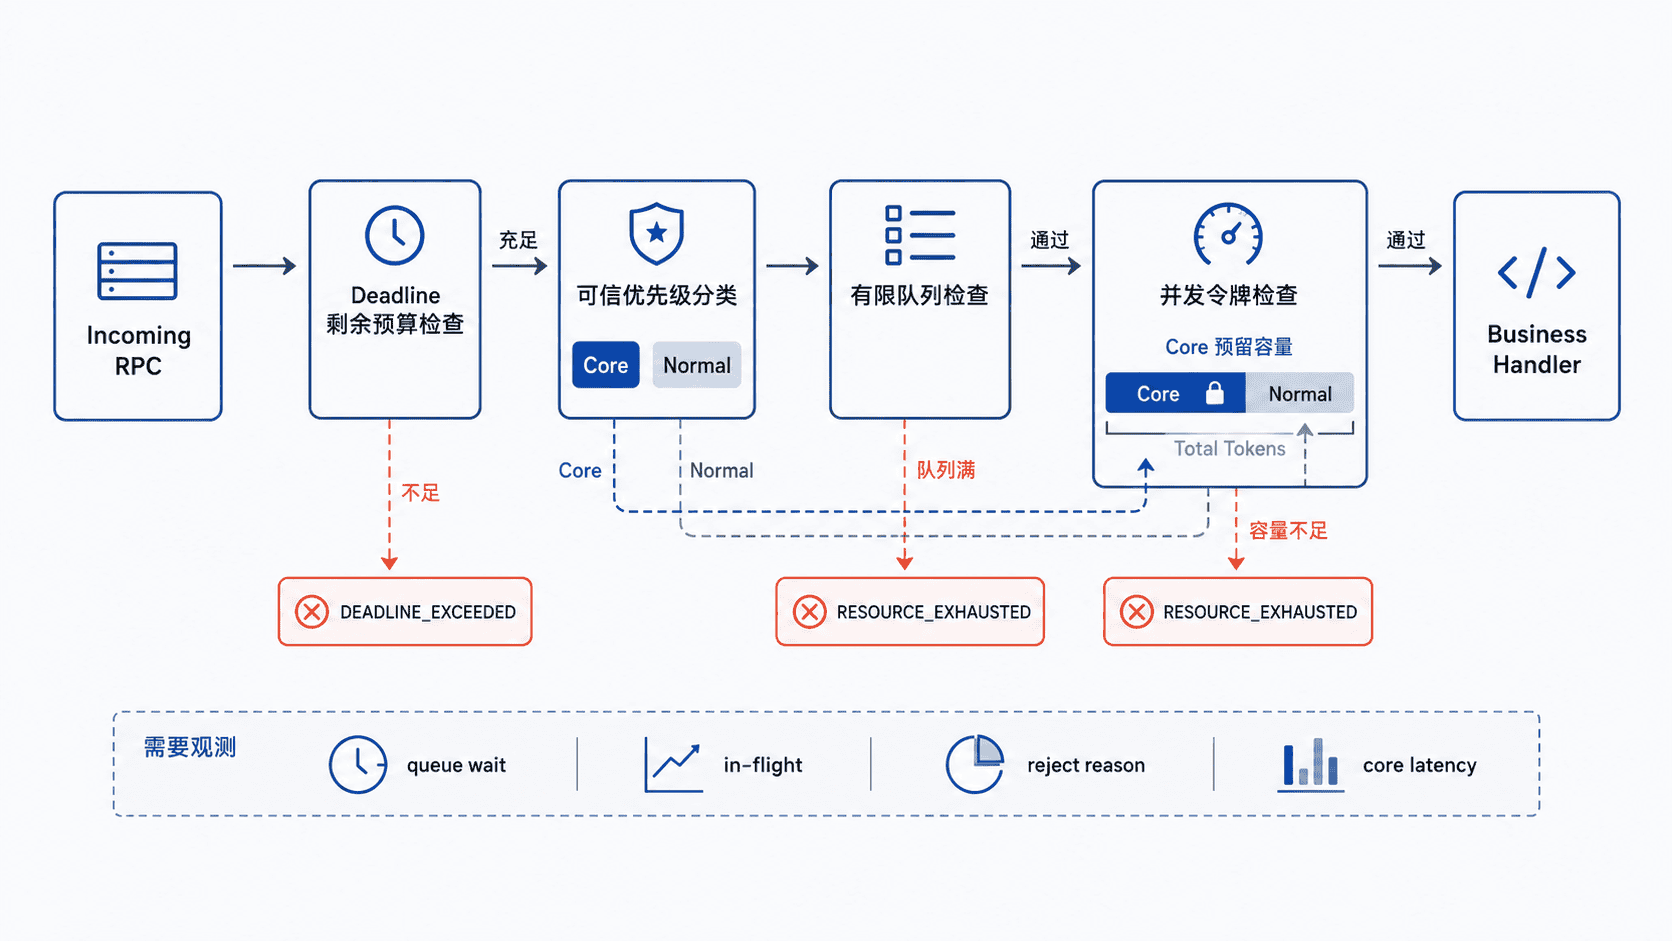
组合四道准入门槛
Deadline 应先筛掉注定失败的请求。服务端可以读取请求上下文的剩余时间;如果预算已经低于该方法可接受的最小处理时间,继续排队只会制造无效工作。阈值应来自该 RPC 的实际耗时分布,而不是凭经验随意设置。
优先级必须和保留容量绑定。仅给请求打标签没有意义;核心流量要能使用普通流量不可占用的一部分执行容量。优先级应由服务端根据认证身份、方法或业务规则映射,不能直接相信任意客户端自报的高优先级。
等待队列必须有硬上限,而且只统计尚未获得执行槽位的请求。请求从等待态切换到执行态时,应先减少 waiting,再增加运行中计数;这两个动作最好在同一把锁下完成,避免把正在执行的 RPC 继续算进队列。
执行并发约束真正的稀缺资源。并发上限可以对应 CPU、数据库连接、下游并发或昂贵任务数。若不同 RPC 成本差异很大,应按方法或资源池拆分容量,而不是只限制进程级请求总数。
用 Unary Interceptor 分离等待与执行
下面的可运行示例放在已经安装 google.golang.org/grpc 的 Go module 中。waiting 只统计排队请求;runningTotal 和 runningBulk 只统计 Handler 中正在执行的请求。maxTotal=2、maxBulk=1 表示最多同时执行两个 RPC,但普通流量最多占一个槽位,因此另一个槽位可供核心流量使用。
package main

import (
    "context"
    "fmt"
    "sync"
    "time"

    "google.golang.org/grpc"
    "google.golang.org/grpc/codes"
    "google.golang.org/grpc/metadata"
    "google.golang.org/grpc/status"
)

type gate struct {
    mu sync.Mutex

    changed chan struct{}

    waiting      int
    maxQueue     int
    runningTotal int
    maxTotal     int
    runningBulk  int
    maxBulk      int
    minBudget    time.Duration
}

func newGate(maxQueue, maxTotal, maxBulk int, minBudget time.Duration) *gate {
    return &gate{
        changed:   make(chan struct{}),
        maxQueue:  maxQueue,
        maxTotal:  maxTotal,
        maxBulk:   maxBulk,
        minBudget: minBudget,
    }
}

func (g *gate) signalLocked() {
    close(g.changed)
    g.changed = make(chan struct{})
}

func (g *gate) canStartLocked(core bool) bool {
    if g.runningTotal >= g.maxTotal {
        return false
    }
    return core || g.runningBulk < g.maxBulk
}

func (g *gate) startLocked(core bool) func() {
    g.runningTotal++
    if !core {
        g.runningBulk++
    }

    return func() {
        g.mu.Lock()
        defer g.mu.Unlock()

        g.runningTotal--
        if !core {
            g.runningBulk--
        }
        g.signalLocked()
    }
}

func (g *gate) acquire(ctx context.Context, core bool) (func(), error) {
    g.mu.Lock()

    // 有执行容量时直接进入执行态,不占用等待队列。
    if g.canStartLocked(core) {
        release := g.startLocked(core)
        g.mu.Unlock()
        return release, nil
    }

    // 只有真正等待执行槽位的请求才计入 waiting。
    if g.waiting >= g.maxQueue {
        g.mu.Unlock()
        return nil, status.Error(codes.ResourceExhausted, "admission queue full")
    }
    g.waiting++

    for {
        changed := g.changed
        g.mu.Unlock()

        select {
        case <-ctx.Done():
            g.mu.Lock()
            g.waiting--
            g.signalLocked()
            g.mu.Unlock()
            return nil, status.FromContextError(ctx.Err()).Err()
        case <-changed:
        }

        g.mu.Lock()
        if err := ctx.Err(); err != nil {
            g.waiting--
            g.signalLocked()
            g.mu.Unlock()
            return nil, status.FromContextError(err).Err()
        }
        if g.canStartLocked(core) {
            // 等待态 -> 执行态在同一临界区完成,Handler 期间不再占 queue。
            g.waiting--
            release := g.startLocked(core)
            g.mu.Unlock()
            return release, nil
        }
    }
}

func (g *gate) unary(
    ctx context.Context,
    req any,
    _ *grpc.UnaryServerInfo,
    handler grpc.UnaryHandler,
) (any, error) {
    if d, ok := ctx.Deadline(); ok && time.Until(d) < g.minBudget {
        return nil, status.Error(codes.DeadlineExceeded, "insufficient deadline budget")
    }

    // 演示直接读取 metadata;生产环境应从可信身份或方法策略映射优先级。
    core := false
    if md, ok := metadata.FromIncomingContext(ctx); ok {
        values := md.Get("x-priority")
        core = len(values) > 0 && values[0] == "core"
    }

    release, err := g.acquire(ctx, core)
    if err != nil {
        return nil, err
    }
    defer release()

    return handler(ctx, req)
}

func call(g *gate, priority string, timeout time.Duration) codes.Code {
    ctx, cancel := context.WithTimeout(context.Background(), timeout)
    defer cancel()

    ctx = metadata.NewIncomingContext(
        ctx,
        metadata.Pairs("x-priority", priority),
    )
    _, err := g.unary(ctx, nil, nil, func(context.Context, any) (any, error) {
        return "ok", nil
    })
    return status.Code(err)
}

func waitForWaiting(g *gate, want int) {
    for {
        g.mu.Lock()
        got := g.waiting
        g.mu.Unlock()
        if got == want {
            return
        }
        time.Sleep(time.Millisecond)
    }
}

func main() {
    g := newGate(1, 2, 1, 50*time.Millisecond)

    // 第一个普通 RPC 占住普通执行槽位。
    started := make(chan struct{})
    releaseFirst := make(chan struct{})
    go func() {
        ctx := metadata.NewIncomingContext(
            context.Background(),
            metadata.Pairs("x-priority", "normal"),
        )
        _, _ = g.unary(ctx, nil, nil, func(context.Context, any) (any, error) {
            close(started)
            <-releaseFirst
            return "ok", nil
        })
    }()
    <-started

    // 第二个普通 RPC 只能进入唯一的等待槽位。
    queuedDone := make(chan codes.Code, 1)
    go func() {
        queuedDone <- call(g, "normal", time.Second)
    }()
    waitForWaiting(g, 1)

    fmt.Println("third-normal:", call(g, "normal", time.Second))
    fmt.Println("core:", call(g, "core", time.Second))
    fmt.Println("short-deadline:", call(g, "core", 20*time.Millisecond))

    close(releaseFirst)
    fmt.Println("queued-normal:", <-queuedDone)
}
运行命令:
go run .预期输出:
third-normal: ResourceExhausted
core: OK
short-deadline: DeadlineExceeded
queued-normal: OK
第一个普通请求正在执行,第二个普通请求只占一个等待槽位,因此第三个普通请求因等待区已满被削减;核心请求仍可使用第二个总执行槽位。释放第一个请求后,排队请求在同一临界区内先执行 waiting--,再增加运行中计数,因此 Handler 执行期间不会继续占用 queue。
这个示例把“等待数”和“运行数”拆成了两个独立状态,但为了突出核心机制,等待队列仍是共享的,也没有实现 FIFO、公平排队或每类流量独立的等待配额。生产环境如果需要更强的租户隔离,应继续按方法、优先级或资源池拆分队列和执行容量。
用压测指标验证保护效果
调参时不要只看总体成功率。至少同时观察按原因分类的准入拒绝数、等待队列长度与等待时间 P95/P99、正在执行的 RPC 数、核心 RPC 的成功率与尾延迟,以及 CPU、连接池和下游并发。压测应逐步把流量推过容量拐点,确认普通请求开始排队或被削减后,核心 RPC 的延迟仍保持稳定。
负载削减真正要保护的是“有价值的完成量”,而不是“尽量少拒绝”。只有把等待请求与正在执行的请求分别计量,才能独立设置排队窗口、执行容量和优先级保留,并在容量下降时尽早拒绝低价值或注定超时的工作。