
架构与系统设计 / 系统课时
构造可重复的故障注入入口
构造可重复的故障注入入口
这节课把常见 gRPC 故障变成可参数化、可脚本化的实验入口:请求可以主动制造延迟和指定状态码,进程控制脚本可以制造连接中断与实例上下线。目标不是模拟所有生产事故,而是让同一个故障能够稳定复现、稳定验收,便于后续比较重试与负载均衡策略。
学习目标
- 用 gRPC Metadata 为单次请求注入延迟和标准状态码。
- 用进程级开关制造传输中断、实例下线与重新上线。
- 为每类故障定义明确的触发命令和客户端可观测结果。
设计一个最小故障控制面
为了避免把业务字段和实验开关混在一起,本课把请求内容放在 Protobuf 消息中,把故障参数放在 Metadata 中。x-fault-delay-ms 控制服务端延迟,x-fault-code 控制返回的 gRPC 状态;实例级故障则由进程控制脚本负责。
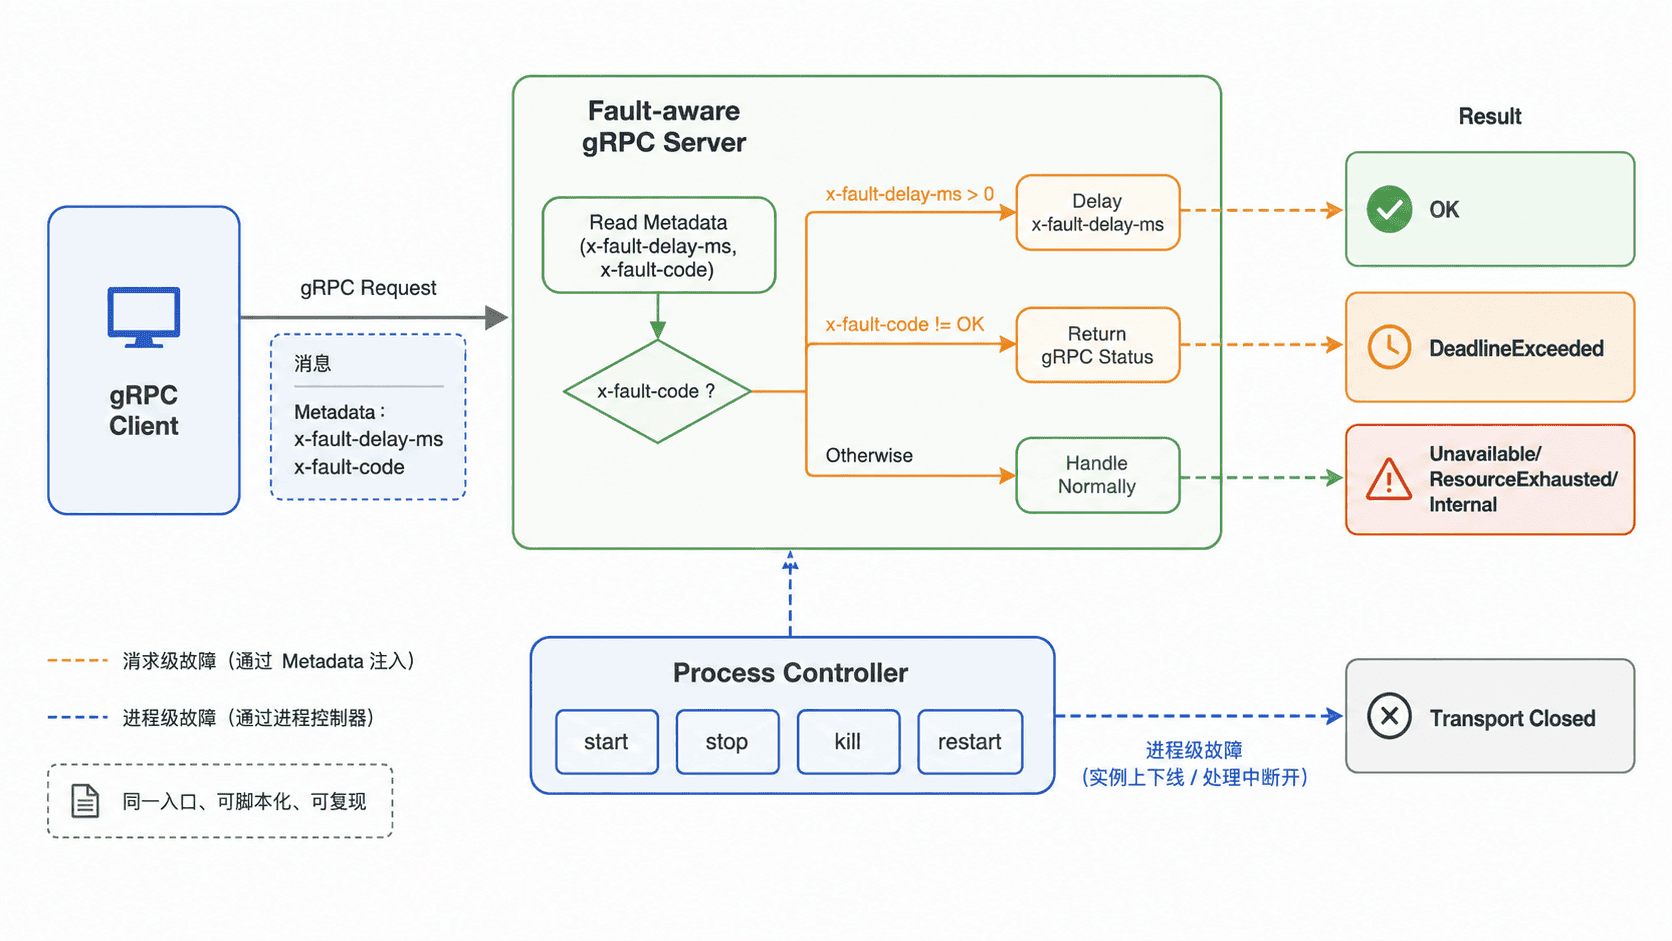
这种分层有两个好处:同一个服务进程可以连续制造不同的请求级故障,而进程级操作仍能真实打断 HTTP/2 连接。后续分析客户端行为时,也能明确区分“服务主动返回错误”和“传输连接突然消失”。
实现请求级故障注入
创建独立实验目录,并固定依赖版本。以下命令按 Bash 环境编写。
mkdir -p grpc-fault-lab/{proto,server,client,bin}
cd grpc-fault-lab
go mod init example.com/grpc-fault-lab
go get google.golang.org/grpc@v1.83.0
go get google.golang.org/protobuf@v1.36.11
go install google.golang.org/protobuf/cmd/protoc-gen-go@v1.36.11
go install google.golang.org/grpc/cmd/protoc-gen-go-grpc@v1.6.2
export PATH="$PATH:$(go env GOPATH)/bin"
预期输出
go: creating new go.mod: module example.com/grpc-fault-lab定义一个 Unary RPC。业务消息只包含 message,所有故障开关都留在 Metadata 中。
syntax = "proto3";

package lab.v1;
option go_package = "example.com/grpc-fault-lab/gen/labv1;labv1";

service Lab {
  rpc Echo(EchoRequest) returns (EchoReply);
}

message EchoRequest {
  string message = 1;
}

message EchoReply {
  string instance = 1;
  string message = 2;
}
保存为 proto/lab.proto 后生成代码。
protoc -I proto \
  --go_out=. --go_opt=module=example.com/grpc-fault-lab \
  --go-grpc_out=. --go-grpc_opt=module=example.com/grpc-fault-lab \
  proto/lab.proto
go mod tidy
预期结果
命令返回码为 0,并生成 gen/labv1/lab.pb.go 与 gen/labv1/lab_grpc.pb.go服务端先执行可取消的延迟,再按 Metadata 返回指定状态码。延迟必须监听 ctx.Done(),否则客户端早已超时,服务端仍会无意义地等待完整时长。
package main

import (
    "context"
    "flag"
    "fmt"
    "log"
    "net"
    "strconv"
    "strings"
    "time"

    pb "example.com/grpc-fault-lab/gen/labv1"
    "google.golang.org/grpc"
    "google.golang.org/grpc/codes"
    "google.golang.org/grpc/metadata"
    "google.golang.org/grpc/status"
)

type server struct {
    pb.UnimplementedLabServer
    instance string
}

func firstMetadata(ctx context.Context, key string) string {
    md, ok := metadata.FromIncomingContext(ctx)
    if !ok {
        return ""
    }
    values := md.Get(key)
    if len(values) == 0 {
        return ""
    }
    return values[0]
}

func (s *server) Echo(ctx context.Context, in *pb.EchoRequest) (*pb.EchoReply, error) {
    if raw := firstMetadata(ctx, "x-fault-delay-ms"); raw != "" {
        ms, err := strconv.Atoi(raw)
        if err != nil || ms < 0 {
            return nil, status.Error(codes.InvalidArgument, "invalid x-fault-delay-ms")
        }

        timer := time.NewTimer(time.Duration(ms) * time.Millisecond)
        defer timer.Stop()
        select {
        case <-timer.C:
        case <-ctx.Done():
            return nil, status.FromContextError(ctx.Err()).Err()
        }
    }

    switch strings.ToLower(firstMetadata(ctx, "x-fault-code")) {
    case "":
    case "unavailable":
        return nil, status.Error(codes.Unavailable, "injected unavailable")
    case "resource_exhausted":
        return nil, status.Error(codes.ResourceExhausted, "injected resource exhausted")
    case "internal":
        return nil, status.Error(codes.Internal, "injected internal")
    default:
        return nil, status.Error(codes.InvalidArgument, "unsupported x-fault-code")
    }

    return &pb.EchoReply{Instance: s.instance, Message: in.GetMessage()}, nil
}

func main() {
    port := flag.Int("port", 50051, "listen port")
    instance := flag.String("instance", "backend-a", "instance name")
    flag.Parse()

    lis, err := net.Listen("tcp", fmt.Sprintf(":%d", *port))
    if err != nil {
        log.Fatal(err)
    }

    grpcServer := grpc.NewServer()
    pb.RegisterLabServer(grpcServer, &server{instance: *instance})
    log.Printf("instance=%s listening=:%d", *instance, *port)

    if err := grpcServer.Serve(lis); err != nil {
        log.Fatal(err)
    }
}
预期结果
保存为 server/main.go;生成 Protobuf 代码后应能由后面的 go build 命令编译通过客户端把故障参数转换成 Metadata,并始终设置 deadline。失败时只输出 gRPC code 与 message,便于脚本做稳定断言。
package main

import (
    "context"
    "flag"
    "fmt"
    "os"
    "strconv"
    "time"

    pb "example.com/grpc-fault-lab/gen/labv1"
    "google.golang.org/grpc"
    "google.golang.org/grpc/credentials/insecure"
    "google.golang.org/grpc/metadata"
    "google.golang.org/grpc/status"
)

func main() {
    target := flag.String("target", "127.0.0.1:50051", "gRPC target")
    message := flag.String("message", "hello", "payload")
    delayMS := flag.Int("delay-ms", 0, "server-side injected delay")
    code := flag.String("code", "", "unavailable|resource_exhausted|internal")
    timeout := flag.Duration("timeout", 2*time.Second, "RPC deadline")
    flag.Parse()

    conn, err := grpc.NewClient(
        *target,
        grpc.WithTransportCredentials(insecure.NewCredentials()),
    )
    if err != nil {
        fmt.Printf("dial_error=%v\n", err)
        os.Exit(2)
    }
    defer conn.Close()

    pairs := []string{}
    if *delayMS > 0 {
        pairs = append(pairs, "x-fault-delay-ms", strconv.Itoa(*delayMS))
    }
    if *code != "" {
        pairs = append(pairs, "x-fault-code", *code)
    }

    ctx, cancel := context.WithTimeout(context.Background(), *timeout)
    defer cancel()
    ctx = metadata.NewOutgoingContext(ctx, metadata.Pairs(pairs...))

    out, err := pb.NewLabClient(conn).Echo(ctx, &pb.EchoRequest{Message: *message})
    if err != nil {
        st, _ := status.FromError(err)
        fmt.Printf("rpc_error code=%s message=%q\n", st.Code(), st.Message())
        os.Exit(2)
    }
    fmt.Printf("ok instance=%s message=%q\n", out.GetInstance(), out.GetMessage())
}
预期结果
保存为 client/main.go;生成 Protobuf 代码后应能由后面的 go build 命令编译通过编译两个二进制,后续所有故障都基于同一构建产物执行。
go build -o bin/server ./server
go build -o bin/client ./client
预期结果
命令返回码为 0,bin/server 与 bin/client 均可执行验证延迟与状态码
先启动一个实例并记录 PID。用二进制而不是 go run,这样 PID 就是实际服务进程,后面可以稳定控制它的生命周期。
./bin/server -port 50051 -instance backend-a >backend-a.log 2>&1 &
echo $! > backend-a.pid
sleep 0.3
./bin/client -target 127.0.0.1:50051 -message baseline
预期输出
ok instance=backend-a message="baseline"制造“服务端延迟大于客户端 deadline”。客户端应观察到 DeadlineExceeded,而不是把它误判为服务端主动返回的 Unavailable。
./bin/client -target 127.0.0.1:50051 -delay-ms 1200 -timeout 300ms预期输出
rpc_error code=DeadlineExceeded message="context deadline exceeded"再直接注入一个可重试性分析中经常遇到的 Unavailable。
./bin/client -target 127.0.0.1:50051 -code unavailable -timeout 2s预期输出
rpc_error code=Unavailable message="injected unavailable"同理,-code resource_exhausted 和 -code internal 会分别得到 ResourceExhausted 与 Internal。这三个状态码的语义和是否应该重试并不相同,本课只负责稳定制造,不在服务端偷偷实现重试。
制造连接中断与实例上下线
连接中断必须发生在 RPC 正在执行时。先发起一个 5 秒延迟请求,再强制杀掉服务进程;客户端会看到传输层被打断后映射出的 Unavailable。
./bin/client -target 127.0.0.1:50051 -delay-ms 5000 -timeout 10s >client.out 2>&1 &
CLIENT_PID=$!
sleep 0.5
kill -9 "$(cat backend-a.pid)"
wait "$CLIENT_PID" || true
cat client.out
预期结果
rpc_error code=Unavailable message="<VALUE>"<VALUE> 由 gRPC-Go 的具体传输错误决定,可能描述连接关闭、EOF 或连接失败;稳定断言应关注 code 为 Unavailable,不要把完整错误文案写死。
实例下线与连接中断的区别在于:下线测试在调用开始前实例就不存在。此时直接请求同一地址,应同样得到 Unavailable,但故障发生阶段不同。
./bin/client -target 127.0.0.1:50051 -timeout 1s预期结果
rpc_error code=Unavailable message="<VALUE>"重新启动实例,就是最小的“上线开关”。
./bin/server -port 50051 -instance backend-a >backend-a.log 2>&1 &
echo $! > backend-a.pid
sleep 0.3
./bin/client -target 127.0.0.1:50051 -message recovered
预期输出
ok instance=backend-a message="recovered"现在四类故障都有了独立入口:Metadata 负责延迟和状态码,进程控制负责连接中断和实例上下线。后续接入 Envoy 或 gRPC-Go 客户端重试时,只需要改变客户端目标和策略,不要改变故障触发方式;这样前后实验的差异才来自治理策略,而不是故障本身发生了变化。