
架构与系统设计 / 系统课时
划分 gRPC 生产故障边界
划分 gRPC 生产故障边界
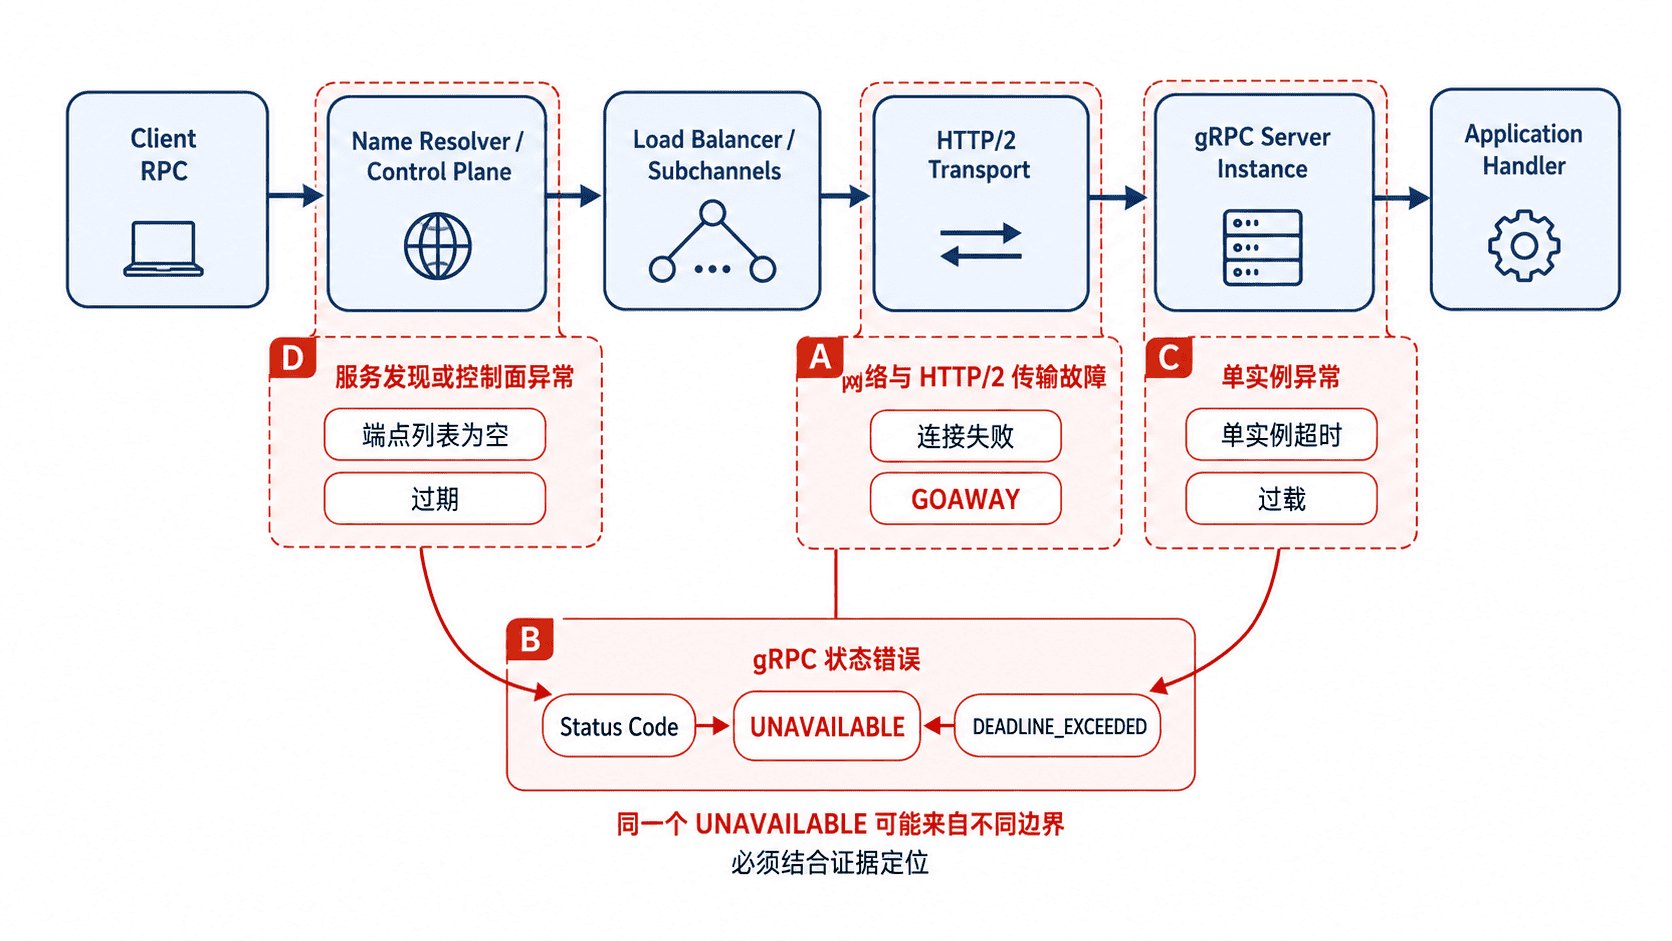
这篇的目标不是背错误码,而是把一次失败按“传输、gRPC 状态、实例、发现与控制面”分层。建立这套边界后,你能先判断故障落在哪一层,再决定看连接、服务日志、单实例健康还是控制面配置,避免被同一个 UNAVAILABLE 带偏。
学习目标
- 区分网络与 HTTP/2、gRPC 状态、服务实例、服务发现或控制面四类故障边界
- 根据状态码、连接证据和实例对比缩小根因范围
- 用一个可控实验观察“服务端状态错误”和“传输失败”的差异
先把状态码和根因分开
gRPC 状态码描述的是一次 RPC 在某一端看到的结果,不是完整根因。比如 UNAVAILABLE 常见于连接建立失败、连接中断或暂时没有可用后端,但服务端也可以主动返回它;DEADLINE_EXCEEDED 既可能来自服务端处理慢,也可能来自排队、网络抖动或客户端把 deadline 设得过短。
因此排障时先记录 code、details、deadline、目标地址和发生时间,再去找传输与实例证据。不要看到一个状态码就直接跳到“网络坏了”或“服务挂了”。
四层证据分别看什么
| 边界 | 常见现象 | 优先证据 |
|---|---|---|
| 网络与 HTTP/2 传输 | 建连失败、TLS 握手失败、连接重置、GOAWAY 后新流无法建立 | 客户端连接日志、代理或网关日志、抓包、证书与端口检查 |
| gRPC 状态 | 明确业务错误,或由 gRPC library 产生终止状态 | StatusCode、details、trailing metadata、服务端业务日志 |
| 服务实例 | 只有部分 Pod/VM 慢、拒绝请求、线程池或资源耗尽 | 按实例直连、健康检查、CPU/内存/队列、应用日志 |
| 发现或控制面 | 地址集错误、无 READY 后端、错误的路由或策略下发 | DNS/Resolver 结果、xDS 或服务发现快照、LB 状态与配置版本 |
关键做法是“同条件对比”。如果同一个客户端对实例 A 正常、实例 B 稳定失败,问题优先落在实例或其网络路径;如果所有实例直连都正常,但通过服务名失败,就应把注意力转向解析、负载均衡、代理或控制面。
用可控实验观察两种失败
下面的 Python 程序不需要 .proto 文件:它先启动一个本地 gRPC 服务,让服务端主动返回 INVALID_ARGUMENT;随后停止服务,再对同一端口发起新 RPC,制造传输层不可达。前置条件是 Python 3 已安装 grpcio。
from concurrent import futures

import grpc


def reject(_request: bytes, context: grpc.ServicerContext) -> bytes:
    # 这个错误由服务端应用明确返回,说明 RPC 已到达处理逻辑。
    context.abort(grpc.StatusCode.INVALID_ARGUMENT, "bad request")


server = grpc.server(futures.ThreadPoolExecutor(max_workers=2))
method = grpc.unary_unary_rpc_method_handler(
    reject,
    request_deserializer=lambda data: data,
    response_serializer=lambda data: data,
)
server.add_generic_rpc_handlers(
    (grpc.method_handlers_generic_handler("demo.Echo", {"Call": method}),)
)
port = server.add_insecure_port("127.0.0.1:0")
server.start()

rpc = grpc.insecure_channel(f"127.0.0.1:{port}").unary_unary(
    "/demo.Echo/Call",
    request_serializer=lambda data: data,
    response_deserializer=lambda data: data,
)

try:
    rpc(b"hello", timeout=1)
except grpc.RpcError as exc:
    print("server-returned:", exc.code().name)

server.stop(0).wait()

# 新建 Channel,确保下一次调用需要重新建立传输连接。
rpc_after_stop = grpc.insecure_channel(f"127.0.0.1:{port}").unary_unary(
    "/demo.Echo/Call",
    request_serializer=lambda data: data,
    response_deserializer=lambda data: data,
)
try:
    rpc_after_stop(b"hello", timeout=1)
except grpc.RpcError as exc:
    print("transport-failure:", exc.code().name)
预期输出:
server-returned: INVALID_ARGUMENT
transport-failure: UNAVAILABLE
第二行在本机端口已关闭的条件下通常是 UNAVAILABLE。生产环境里的丢包、黑洞路由或过短 deadline 可能让表象不同,所以实验真正要记住的是:状态码要和“请求是否到达实例、连接是否成功、失败是否只集中在部分实例”一起解释。
按固定顺序缩小范围
先从一次失败的客户端证据开始,再逐层向后端收敛:
- 固定请求参数、deadline、目标服务名和时间窗口,记录完整 gRPC code 与 details。
- 判断是否能建立目标端口与 TLS/HTTP/2 连接;若连接阶段就失败,先处理传输问题。
- 对比服务发现返回的地址集与实际健康实例,确认没有空列表、陈旧地址或错误端口。
- 绕过负载均衡按实例测试,判断故障是否只落在部分实例。
- 只有“实例直连正常、经服务名异常”时,再重点检查 resolver、LB、网关或 xDS 等控制面路径。
这套顺序的价值在于把“一个 RPC 失败”拆成可验证的边界。错误码是入口,不是结论;能把状态、传输、实例和控制面证据对齐,才算真正定位了故障层。