
架构与系统设计 / 系统课时
设计 Locality、Priority 与故障转移
设计 Locality、Priority 与故障转移
这节把“同区优先、跨区容灾”落实到 xDS 的 EDS 层级:先用 Priority 决定当前可参与服务的故障域,再用 Locality 权重分配同一优先级内的流量,最后通过连续 RPC 的 peer 分布验证局部故障、整层故障和恢复后的迁移路径。
学习目标
- 能区分 Priority 的故障转移语义与 Locality 权重的同层分流语义。
- 能设计包含主地域、邻近地域和跨区备用端点的
ClusterLoadAssignment。 - 能用 peer 分布验证局部故障不会过早跨区,以及高优先级失效后会切换到备用层。
先把两层选择关系分开
Priority 是外层:数值越小优先级越高,客户端优先使用最高可服务的层;正常情况下不会把请求按比例同时分给 Priority 0 和 Priority 1。Locality 是内层:只有进入某个 Priority 后,才会按该层各 locality 的相对权重分流。
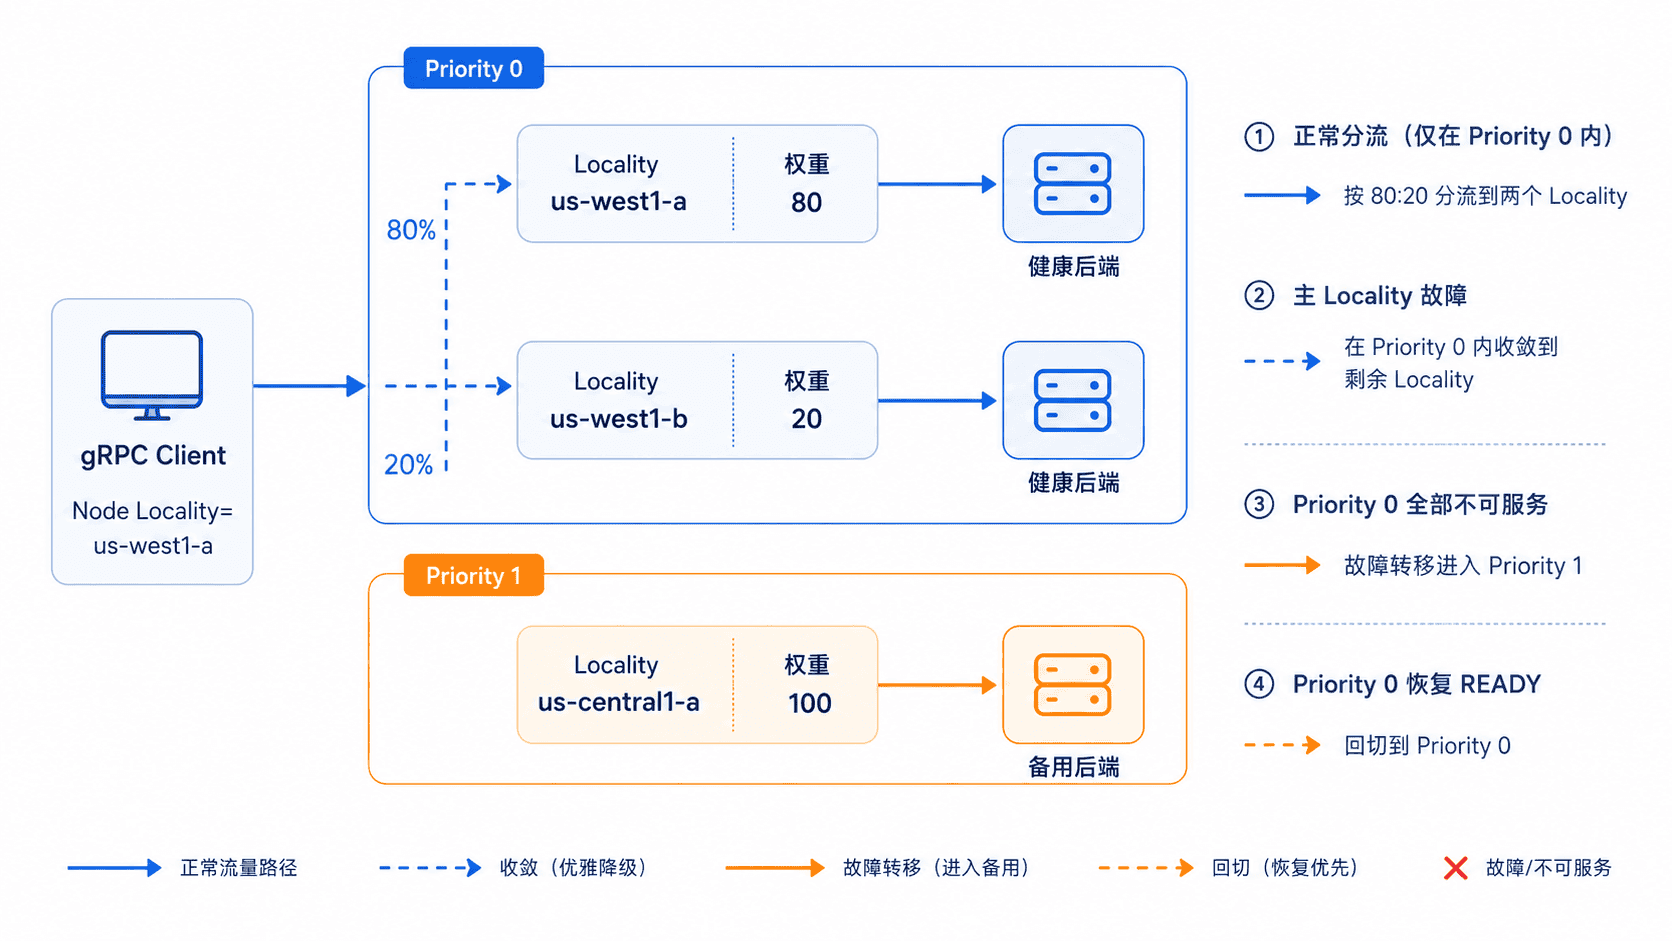
Locality 权重是相对权重。例如 80 和 20 表示在同一可用 Priority 内大致按 80:20 分配,而不是给某个地域永久保留 80% 的全局流量。某个 locality 不可服务后,剩余可用 locality 会继续承担该优先级内的请求。
设计 EDS 端点层级
下面是控制面最终下发的 ClusterLoadAssignment 的 YAML 等价片段,不是让 gRPC 客户端直接读取的本地配置文件。实验用三个本机端口模拟三个地域:主 locality 权重 80、同优先级邻近 locality 权重 20、跨区域备用位于 Priority 1。
cluster_name: payments
endpoints:
  - locality:
      region: us-west1
      zone: us-west1-a
      sub_zone: primary
    priority: 0
    load_balancing_weight: 80
    lb_endpoints:
      - health_status: HEALTHY
        endpoint:
          address:
            socket_address:
              address: 127.0.0.1
              port_value: 50051
  - locality:
      region: us-west1
      zone: us-west1-b
      sub_zone: neighbor
    priority: 0
    load_balancing_weight: 20
    lb_endpoints:
      - health_status: HEALTHY
        endpoint:
          address:
            socket_address:
              address: 127.0.0.1
              port_value: 50052
  - locality:
      region: us-central1
      zone: us-central1-a
      sub_zone: disaster-recovery
    priority: 1
    load_balancing_weight: 100
    lb_endpoints:
      - health_status: HEALTHY
        endpoint:
          address:
            socket_address:
              address: 127.0.0.1
port_value: 50053这份设计的关键不是三个端点,而是层级:50051 与 50052 同属 Priority 0,可以在主层内部按权重分流;50053 属于 Priority 1,只在更高优先级无法服务时接管。Priority 应从 0 连续递增,避免 0、2 这样的空洞层级;同一 Priority 内的 locality 标识也应保持唯一。
用 peer 分布验证正常与故障状态
验证程序调用标准 gRPC Health 服务,并统计 200 次 RPC 实际命中的远端地址。它假设 bootstrap 已指向控制面,三个后端均提供 Health 服务,业务目标为 xds:///payments。
package main

import (
    "context"
    "fmt"
    "log"
    "time"

    "google.golang.org/grpc"
    xdscreds "google.golang.org/grpc/credentials/xds"
    "google.golang.org/grpc/credentials/insecure"
    healthpb "google.golang.org/grpc/health/grpc_health_v1"
    "google.golang.org/grpc/peer"
    _ "google.golang.org/grpc/xds"
)

func main() {
    creds, err := xdscreds.NewClientCredentials(xdscreds.ClientOptions{
        FallbackCreds: insecure.NewCredentials(),
    })
    if err != nil {
        log.Fatal(err)
    }

    conn, err := grpc.NewClient(
        "xds:///payments",
        grpc.WithTransportCredentials(creds),
    )
    if err != nil {
        log.Fatal(err)
    }
    defer conn.Close()

    client := healthpb.NewHealthClient(conn)
    counts := map[string]int{}
    failures := 0

    for i := 0; i < 200; i++ {
        ctx, cancel := context.WithTimeout(context.Background(), time.Second)
        var p peer.Peer
        _, err := client.Check(ctx, &healthpb.HealthCheckRequest{}, grpc.Peer(&p))
        cancel()

        if err != nil {
            failures++
            continue
        }
        if p.Addr != nil {
            counts[p.Addr.String()]++
        }
        time.Sleep(20 * time.Millisecond)
    }

    for _, addr := range []string{
        "127.0.0.1:50051",
        "127.0.0.1:50052",
        "127.0.0.1:50053",
    } {
        fmt.Printf("%s => %d\n", addr, counts[addr])
    }
    fmt.Printf("errors => %d\n", failures)
}
预期结果:程序完成一轮采样后输出三个已知端点的命中计数和失败数;具体计数取决于当前故障阶段、连接状态和策略收敛情况。
运行程序:
export GRPC_XDS_BOOTSTRAP="$PWD/bootstrap.json"
go run .
预期输出:
127.0.0.1:50051 => <VALUE>
127.0.0.1:50052 => <VALUE>
127.0.0.1:50053 => <VALUE>
errors => <VALUE>
这里的 <VALUE> 必须按阶段解释,不能要求每轮得到完全相同的计数。200 次请求只是让权重趋势更容易观察,连接状态、请求时序和负载均衡实现都会让小样本出现波动。
按故障层级做三阶段验收
先保持三个后端都健康并运行统计程序;随后停止 50051 对应后端,再采样一次;最后让 50051 与 50052 都不可服务,再运行第三次。每个阶段都应等待客户端完成必要的连接与优先级收敛后,再判断长期分布。
| 阶段 | 50051 主 locality |
50052 邻近 locality |
50053 跨区备用 |
应看到的现象 |
|---|---|---|---|---|
| 全部健康 | 约 80% | 约 20% | 0 | 只使用 Priority 0 |
| 主 locality 故障 | 0 或接近 0 | 接近 100% | 0 | 仍留在 Priority 0 |
| Priority 0 全部故障 | 0 | 0 | 接近 100% | 切到 Priority 1 |
Priority 的切换受子策略连接状态和故障转移状态机影响,因此故障刚发生时允许出现短暂错误或过渡流量;验收重点是稳定后是否遵守层级,而不是故障后的第一条 RPC 是否立即命中备用端点。
避免把容灾配置成常态跨区
如果目标是“同区域优先、跨区域只兜底”,就不要把跨区域 locality 放进 Priority 0 后再给一个很小权重;那会把灾备链路变成常态流量路径。可长期共同承载的地域应放在同一 Priority,用权重表达偏好;真正的灾备地域则放到更低优先级。
恢复测试同样不能省略。让 Priority 0 后端重新可服务后,客户端应重新选择更高优先级;若长期停留在 Priority 1,应检查控制面是否恢复了正确的 EDS 端点与健康状态、端点是否真正可连,以及更高优先级子策略是否重新进入 READY。