
架构与系统设计 / 系统课时
比较 pick_first 与 round_robin
比较 pick_first 与 round_robin
同一个服务名解析出多个后端后,gRPC 客户端还要决定“维护哪些连接、每次 RPC 选谁”。本课用三实例实验比较 pick_first 与 round_robin 的请求分布和故障切换,并用真实 RPC 结果做条件同步,避免固定 Sleep 在慢机器或 CI 上造成偶发失败。
学习目标
- 说清
pick_first与round_robin在连接维护和 Endpoint 选取上的核心差异 - 通过三实例实验观察正常分布与单实例故障后的恢复行为
- 用条件等待替代固定延时,让负载均衡测试由实际连接和 RPC 结果驱动
两种策略到底在选什么
名称解析器先把目标服务转换成一组 Endpoint,负载均衡策略再决定如何维护连接以及为 RPC 选路。没有 Service Config 指定其他策略时,gRPC-Go 默认使用 pick_first;要启用 round_robin,可在 Service Config 中声明对应策略。
| 维度 | pick_first |
round_robin |
|---|---|---|
| 正常连接 | 选定一个可用 Endpoint 作为当前后端,RPC 主要集中到该连接 | 为多个 Endpoint 维护可用连接并跟踪状态 |
| 请求分布 | 同一 Channel 上的 RPC 通常集中到当前选中的 Endpoint | 在当前可用的 Endpoint 之间轮询 |
| 单点故障 | 当前连接失效后重新选择可用 Endpoint,切换期间可能出现失败或等待 | 故障 Endpoint 退出可选集合后,其余 READY Endpoint 可继续承载 RPC |
| 适合场景 | 希望连接更少,或上游已有代理负责均衡 | 客户端直接面对多个实例,希望单个 Channel 内分散请求 |
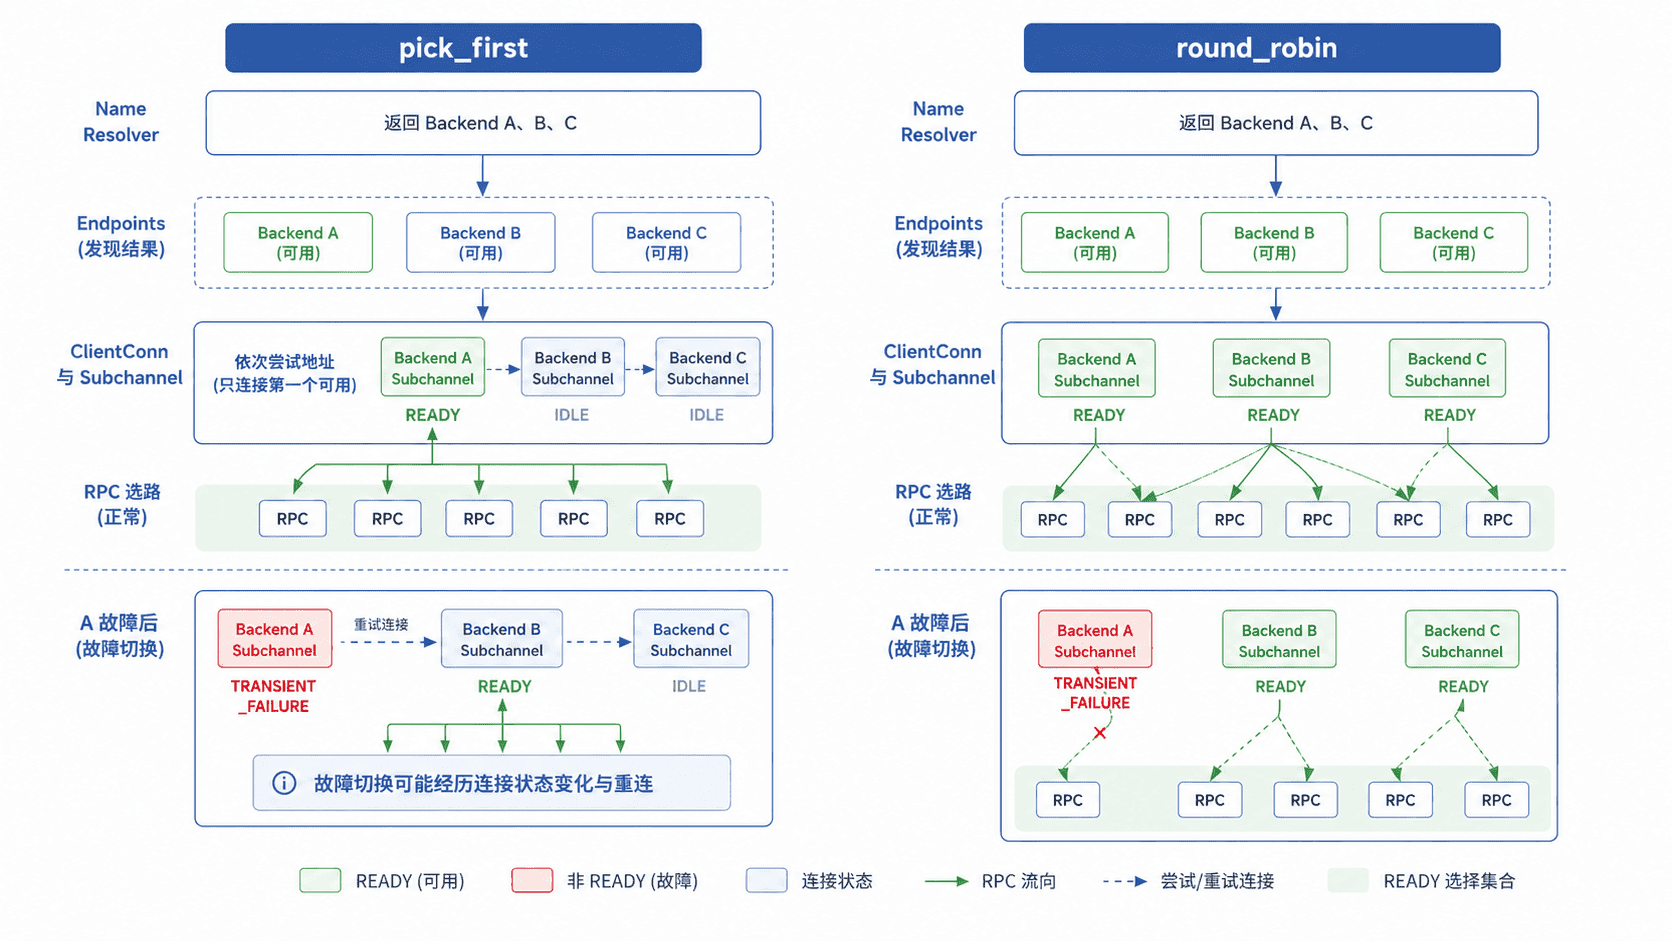
round_robin 轮询的是当时可用于 RPC 的连接,不是静态 DNS 文本列表。某个 Endpoint 尚未 READY 时,它不会参与正常选取;测试也不应断言固定起始位置,而应验证“是否覆盖多个后端”和“故障后是否继续覆盖存活后端”。
跑一个三实例实验
下面示例按 Go 1.25 与 gRPC-Go 1.83.2 编写。程序在本机启动三个 gRPC Health 服务,用响应 Header 标记后端身份,再通过手动 Resolver 把三条地址交给两个策略。监听端口使用系统分配的随机端口,避免固定端口占用影响实验;grpc.NewClient 本身也不会等待连接 READY,因此同步条件必须来自后续 RPC。
先创建 go.mod:
module lb-lab

go 1.25

require google.golang.org/grpc v1.83.2
这是模块配置;保存后由后面的 go mod tidy 解析依赖。
再创建 main.go:
package main

import (
	"context"
	"fmt"
	"log"
	"net"
	"sort"
	"time"

	"google.golang.org/grpc"
	"google.golang.org/grpc/credentials/insecure"
	"google.golang.org/grpc/health"
	healthpb "google.golang.org/grpc/health/grpc_health_v1"
	"google.golang.org/grpc/metadata"
	"google.golang.org/grpc/resolver"
	"google.golang.org/grpc/resolver/manual"
)

func backendHeader(name string) grpc.UnaryServerInterceptor {
	return func(
		ctx context.Context,
		req any,
		info *grpc.UnaryServerInfo,
		handler grpc.UnaryHandler,
	) (any, error) {
		// 用 Header 暴露真正处理 RPC 的后端,无需额外定义 protobuf。
		if err := grpc.SetHeader(ctx, metadata.Pairs("x-backend", name)); err != nil {
			return nil, err
		}
		return handler(ctx, req)
	}
}

func startCluster() (map[string]*grpc.Server, []resolver.Address, error) {
	names := []string{"A", "B", "C"}
	servers := make(map[string]*grpc.Server, len(names))
	addresses := make([]resolver.Address, 0, len(names))

	for _, name := range names {
		lis, err := net.Listen("tcp", "127.0.0.1:0")
		if err != nil {
			for _, server := range servers {
				server.Stop()
			}
			return nil, nil, err
		}

		server := grpc.NewServer(grpc.UnaryInterceptor(backendHeader(name)))
		hs := health.NewServer()
		hs.SetServingStatus("", healthpb.HealthCheckResponse_SERVING)
		healthpb.RegisterHealthServer(server, hs)

		servers[name] = server
		addresses = append(addresses, resolver.Address{Addr: lis.Addr().String()})
		// 让操作系统分配端口,避免实验与本机已有服务争用固定端口。
		go server.Serve(lis)
	}
	return servers, addresses, nil
}

func callBackend(parent context.Context, client healthpb.HealthClient) (string, error) {
	ctx, cancel := context.WithTimeout(parent, 2*time.Second)
	defer cancel()

	var header metadata.MD
	_, err := client.Check(
		ctx,
		&healthpb.HealthCheckRequest{},
		grpc.Header(&header),
		grpc.WaitForReady(true),
	)
	if err != nil {
		return "", err
	}

	values := header.Get("x-backend")
	if len(values) == 0 {
		return "", fmt.Errorf("missing x-backend header")
	}
	return values[0], nil
}

func waitForBackends(
	client healthpb.HealthClient,
	want int,
	exclude string,
	timeout time.Duration,
) ([]string, error) {
	// 退出条件由真实 RPC 命中的后端数量决定,50ms 仅用于错误后的重试节流。
	ctx, cancel := context.WithTimeout(context.Background(), timeout)
	defer cancel()

	seen := map[string]struct{}{}
	for len(seen) < want {
		backend, err := callBackend(ctx, client)
		if err == nil && backend != exclude {
			seen[backend] = struct{}{}
			continue
		}

		select {
		case <-ctx.Done():
			return nil, fmt.Errorf(
				"observed %d/%d backends: %w",
				len(seen),
				want,
				ctx.Err(),
			)
		case <-time.After(50 * time.Millisecond):
		}
	}

	result := make([]string, 0, len(seen))
	for backend := range seen {
		result = append(result, backend)
	}
	sort.Strings(result)
	return result, nil
}

func run(policy string) error {
	servers, addresses, err := startCluster()
	if err != nil {
		return err
	}
	defer func() {
		for _, server := range servers {
			if server != nil {
				server.Stop()
			}
		}
	}()

	// 手动 Resolver 固定三条地址,只观察负载均衡策略本身。
	r := manual.NewBuilderWithScheme("static")
	r.InitialState(resolver.State{Addresses: addresses})
	serviceConfig := fmt.Sprintf(
		`{"loadBalancingConfig":[{"%s":{}}]}`,
		policy,
	)

	cc, err := grpc.NewClient(
		"static:///health",
		grpc.WithResolvers(r),
		grpc.WithTransportCredentials(insecure.NewCredentials()),
		grpc.WithDefaultServiceConfig(serviceConfig),
	)
	if err != nil {
		return err
	}
	defer cc.Close()

	client := healthpb.NewHealthClient(cc)

	// readiness 由真实 RPC 覆盖的后端数量判定,而不是等待固定时长。
	wantReady := 1
	if policy == "round_robin" {
		wantReady = 3
	}
	ready, err := waitForBackends(client, wantReady, "", 12*time.Second)
	if err != nil {
		return fmt.Errorf("%s readiness: %w", policy, err)
	}
	fmt.Printf("== %s: ready backends ==\n%v\n", policy, ready)

	stopped := ready[0]
	if policy == "round_robin" {
		stopped = "A"
	}
	fmt.Printf("stop backend %s\n", stopped)
	servers[stopped].Stop()
	servers[stopped] = nil

	wantAfterFailure := 1
	if policy == "round_robin" {
		wantAfterFailure = 2
	}
	survivors, err := waitForBackends(
		client,
		wantAfterFailure,
		stopped,
		12*time.Second,
	)
	if err != nil {
		return fmt.Errorf("%s failover: %w", policy, err)
	}
	fmt.Printf("%s after failure -> %v\n", policy, survivors)
	return nil
}

func main() {
	if err := run("pick_first"); err != nil {
		log.Fatal(err)
	}

	fmt.Println()

	if err := run("round_robin"); err != nil {
		log.Fatal(err)
	}
}
这里没有用 Sleep(500ms) 假设三个 round_robin 连接已经 READY,也没有用 Sleep(300ms) 猜测故障切换完成。正常阶段只有观察到目标数量的真实后端才继续;故障阶段只有观察到足够多的存活后端才通过,12 秒总超时才是失败边界。
执行:
go mod tidy
go run .预期输出体现下面的模式;pick_first 选中的实例不是测试断言的一部分,因此使用动态占位符:
== pick_first: ready backends ==
[<SELECTED_BACKEND>]
stop backend <SELECTED_BACKEND>
pick_first after failure -> [<SURVIVING_BACKEND>]

== round_robin: ready backends ==
[A B C]
stop backend A
round_robin after failure -> [B C]
实际 pick_first 会在故障前持续命中一个当前后端,故障后才观察到另一个存活后端;round_robin 则必须先由真实 RPC 覆盖 A、B、C,才进入故障阶段。这样断言由连接和选路行为驱动,而不是由机器快慢决定。
怎么读故障切换结果
不要把“能切换”理解成“无感切换”。pick_first 当前连接失效后,Channel 需要经历连接状态变化并重新选择可用 Endpoint;若调用没有足够的 Deadline,且没有 wait-for-ready 或适用的重试策略,切换窗口内的 RPC 仍可能失败。
round_robin 的优势是其他 Endpoint 已经 READY 时,可以继续从存活连接中选路。但它会维持更多连接,而且“连接可用”不等于“业务健康”;客户端健康检查、服务发现和更高层流量治理仍需按系统需求设计。
选择策略时看三件事
优先看服务发现返回的 Endpoint 数量、客户端是否应该直接承担均衡,以及是否能接受额外连接。上游已经有可靠 L7 代理时,pick_first 往往足够;客户端直接面对多个后端、希望单个 Channel 内分散请求时,round_robin 更符合目标。
故障验收也不要只看“最终能恢复”:应主动停掉当前参与流量的实例,以 RPC 结果或连接状态作为继续条件,并记录错误率和恢复耗时是否满足现有 Deadline 与重试策略。