
游戏 AI / 系统课时
从目标反推动作链
从目标反推动作链
本课解决 GOAP 中“已经知道目标,却不知道先做什么”的问题:从目标状态反向检查动作前置条件,逐步构造可能成立的动作链,再交给搜索过程筛选可行方案。
学习目标
- 理解从目标状态向当前状态反推的搜索思路
- 能根据动作前置条件建立候选动作集合
- 能识别反推过程中最常见的冲突与停止条件
为什么从目标开始反推
正向搜索从当前状态不断尝试所有可用动作,动作一多,分支数量会迅速增长。反向规划则先问“要得到这个目标,最后一个动作必须满足什么条件”,再继续寻找满足这些条件的前置动作。
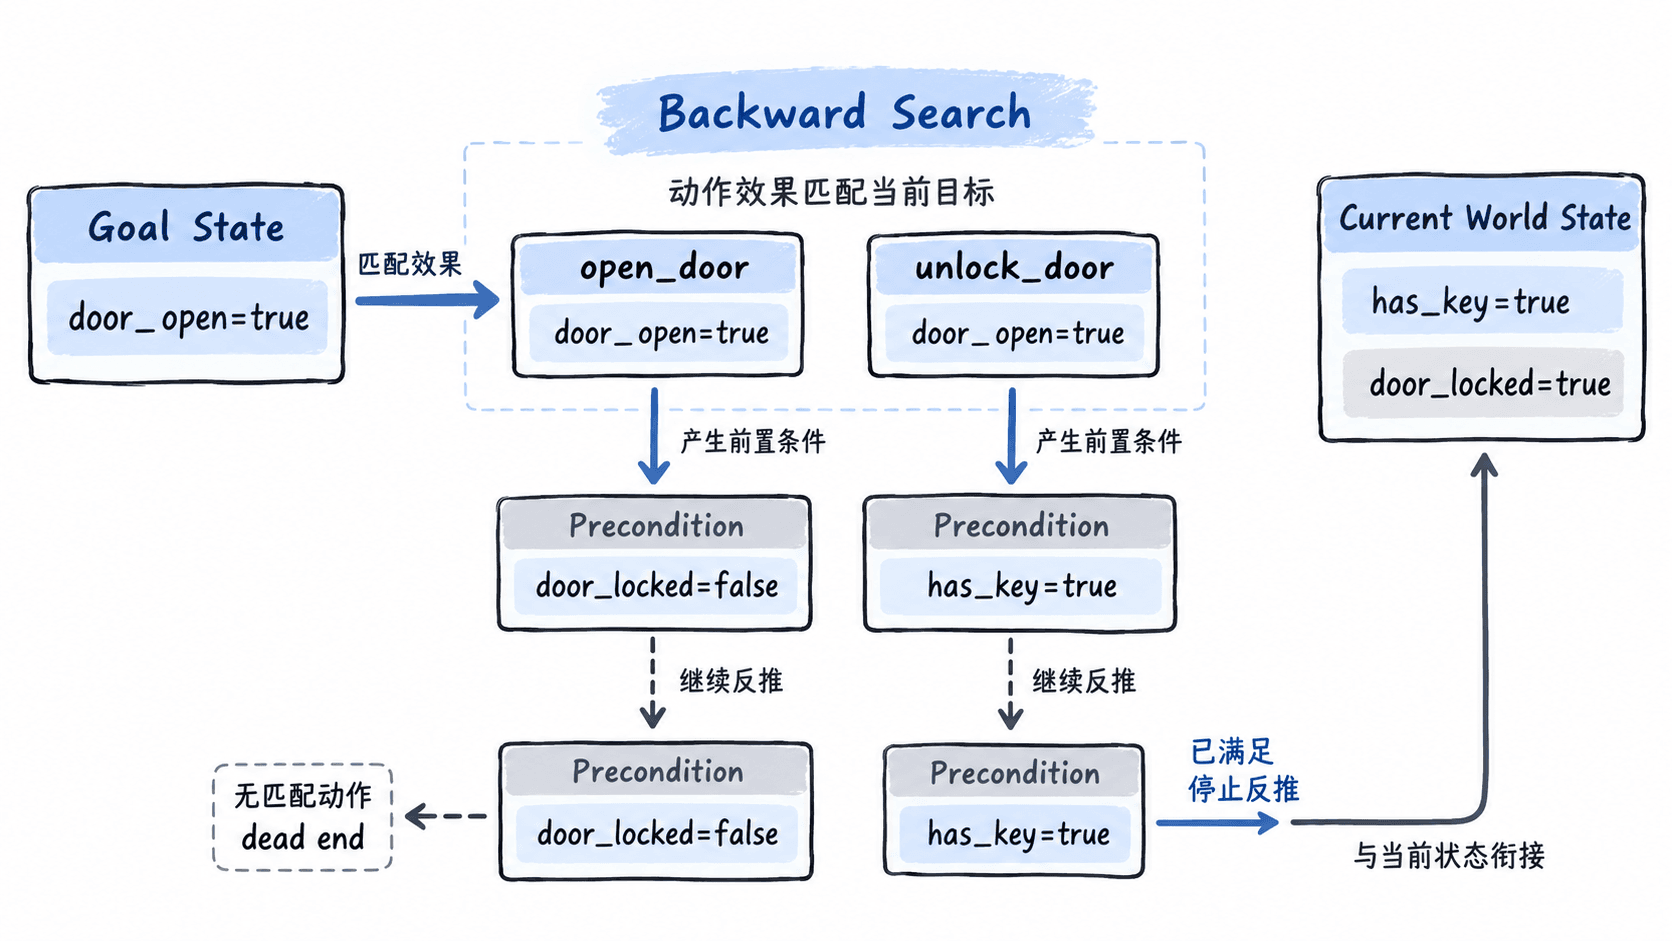
假设 NPC 的目标是 door_open=true,候选动作包括 unlock_door 和 open_door。因为 open_door 的效果是打开门,它自然成为最后一步;接着再检查 open_door 的前置条件,例如 door_locked=false,于是搜索继续寻找能够得到这个状态的动作。
如何得到候选动作
反推时不需要先遍历所有动作,而是先看动作的 effects 是否能够满足当前待解决的事实。比如当前待解决的是 door_locked=false,那么只有能产生该效果的动作才进入候选集合。
一个简单的动作可以表示为名称、前置条件和效果三部分。反推时,候选动作的效果必须覆盖当前目标;选中动作后,把它的前置条件加入新的待解决集合。这样,搜索的方向始终朝着“当前世界状态能够提供什么”靠近。
一个最小反推实现
下面的 Python 示例故意使用集合表示事实,演示核心算法,不包含完整的代价搜索与并发处理。
from dataclasses import dataclass

@dataclass(frozen=True)
class Action:
    name: str
    preconditions: frozenset[str]
    effects: frozenset[str]


actions = [
    Action("find_key", frozenset(), frozenset({"has_key"})),
    Action("unlock_door", frozenset({"has_key", "door_locked"}), frozenset({"door_unlocked", "not_door_locked"})),
    Action("open_door", frozenset({"door_unlocked"}), frozenset({"door_open"})),
]

current_state = {"door_locked"}
goal = {"door_open"}

plan = []
needed = set(goal)

while needed:
    candidates = [
        action for action in actions
        if any(effect in needed for effect in action.effects)
    ]
    if not candidates:
        raise RuntimeError(f"no action can satisfy: {sorted(needed)}")

    action = candidates[0]
    plan.insert(0, action.name)
    needed = set(action.preconditions) | (needed - set(action.effects))

    satisfied = needed & current_state
    needed -= satisfied

print(" -> ".join(plan))
预期输出:
find_key -> unlock_door -> open_door这个示例只用于说明反推机制,生产实现还需要处理否定事实、动作重复使用、分支选择和累计代价。尤其要注意 current_state 中已经满足的事实应尽早移出待解决集合,否则搜索会产生无意义的循环。
反推什么时候停止
反推通常有两个正常出口。第一种是所有目标及其递归前置条件都能被当前世界状态满足,此时得到一条可执行候选链。第二种是找不到能够产生某个待解决事实的动作,此时形成死路,应回退到其他候选动作,而不是继续凭空添加条件。
还要区分“效果满足目标”和“真正可执行”。一个动作可能确实能产生目标事实,但它的前置条件无法成立,因此只是候选,不是可行路径。完整 GOAP 搜索会继续结合节点状态和代价进行比较。
反向搜索最适合用于把巨大动作空间迅速缩小到与当前目标有关的局部集合。完成候选收缩后,再用搜索策略处理不同动作组合,才能得到稳定、可执行且代价合理的计划。