
游戏 AI / 系统课时
动态代价怎样影响选择
动态代价怎样影响选择
固定代价只能表达静态偏好,而真实战斗会随距离、弹药、生命值和资源压力变化。把这些运行时状态转成代价后,GOAP 才能在相同目标下根据情境选择更合适的动作。
学习目标
- 理解动态状态如何参与动作代价计算
- 能设计避免极端值的代价公式
- 能根据运行时状态验证计划是否改变
代价为什么要随情境变化
GOAP 通常会在满足前置条件的候选动作中寻找总代价较低的计划。若 Attack 永远是 5、Chase 永远是 2,那么规划器无法表达“敌人很近但弹药只剩一发”和“敌人很远且弹药充足”之间的区别。
动态代价的作用,是让动作的价格反映当前状态,而不是改变动作本身的语义。例如开火可以始终表示“消耗一发弹药造成伤害”,但它的规划代价可以随着距离、弹药余量或生命风险变化。
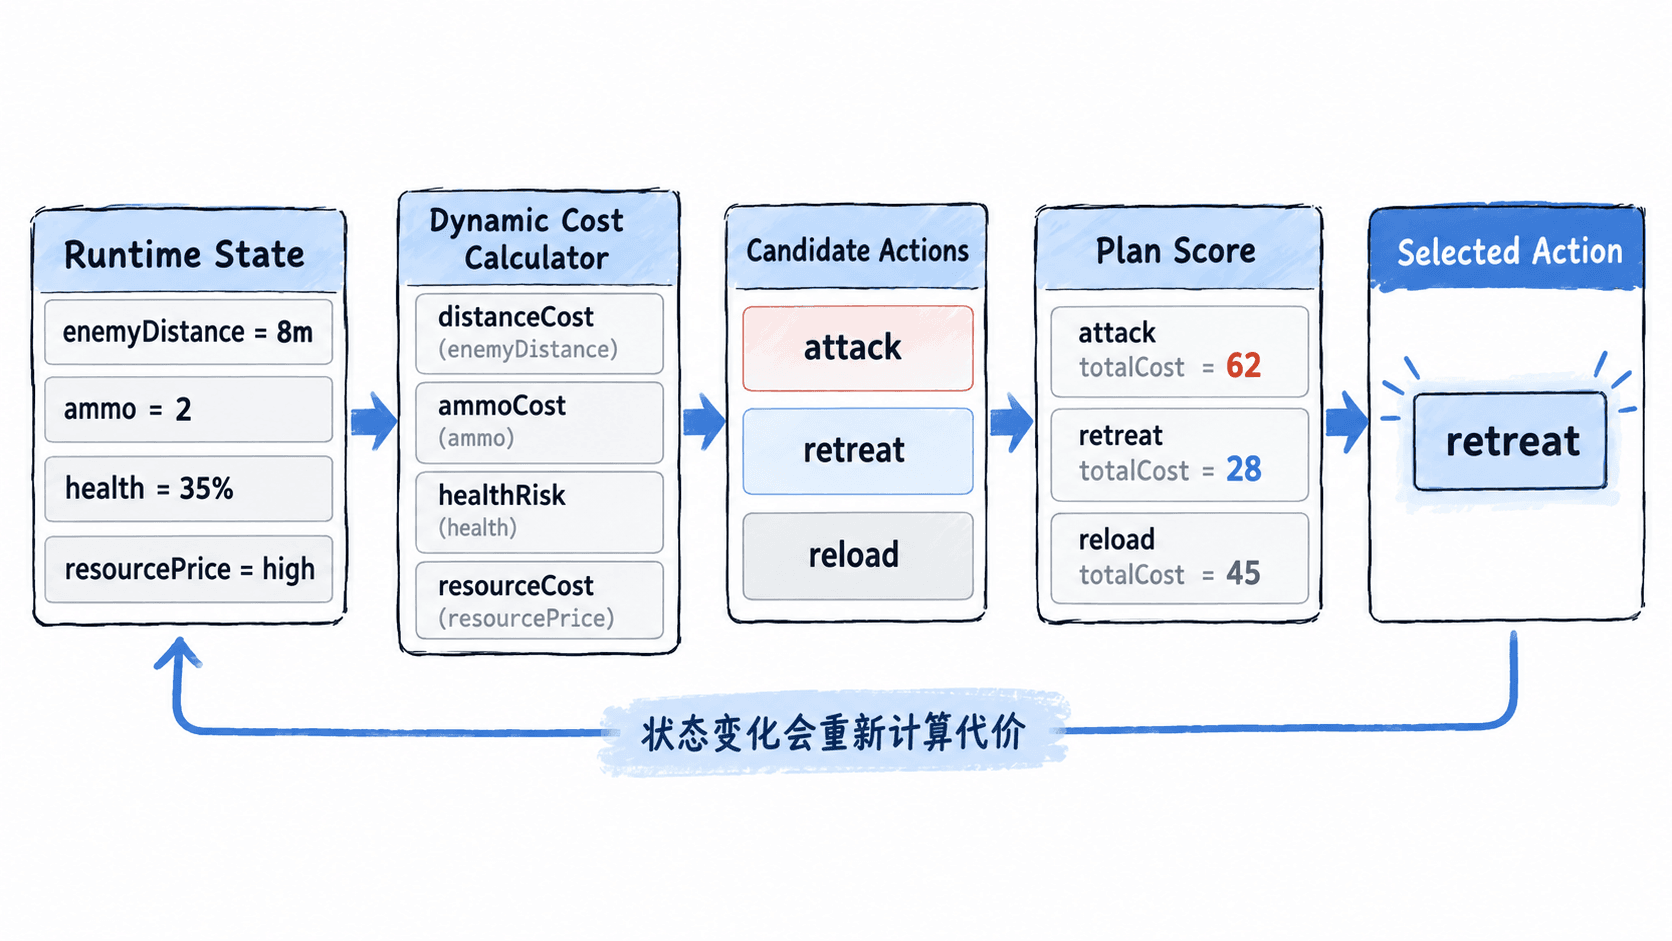
把运行时状态转换成代价
最稳妥的方式是先把每个动态因素归一化,再组合成动作代价。这样不同量纲不会直接相加,也更容易调参。一个常见模型是:
其中 是基础代价, 表示距离风险, 表示弹药压力, 表示生命风险, 表示资源价格,权重 决定每项影响有多大。
例如可以把距离限制在 0 到 1,再根据动作需要判断它是收益还是风险。近距离攻击可以让距离项更低,远距离追击则可能变高。弹药剩余越少,消耗弹药的动作通常应承担更高代价。
不要直接把原始米数、子弹数量和金币价格相加,否则一个数值范围很大的变量会意外主导整个规划。代价函数首先应该保证各项具有可比较的尺度。
一个可验证的动态代价实现
下面的 Python 示例把敌人距离、弹药和生命值转成有限范围的附加代价,并比较两个候选动作。示例是独立可运行的最小实现。
def clamp(value, low=0.0, high=1.0):
    return max(low, min(high, value))


def action_cost(base_cost, distance, ammo, health_percent, consumes_ammo):
    # 将不同量纲的运行时状态压到 0~1,避免某一项完全支配评分。
    distance_risk = clamp(distance / 20.0)
    ammo_pressure = clamp((3 - ammo) / 3.0)
    health_risk = clamp((50 - health_percent) / 50.0)

    extra = 2.0 * distance_risk + 3.0 * health_risk
    if consumes_ammo:
        extra += 4.0 * ammo_pressure
    return round(base_cost + extra, 2)


attack = action_cost(
    base_cost=3.0,
    distance=8.0,
    ammo=2,
    health_percent=35.0,
    consumes_ammo=True,
)
retreat = action_cost(
    base_cost=6.0,
    distance=8.0,
    ammo=2,
    health_percent=35.0,
    consumes_ammo=False,
)

print(f"attack={attack}")
print(f"retreat={retreat}")
print("selected=" + ("attack" if attack < retreat else "retreat"))
预期输出
attack=8.8
retreat=8.1
selected=retreat
这个结果说明基础代价更低的 attack 并不一定最终获选。生命值较低和弹药偏紧提高了攻击的附加代价,使 retreat 成为当前情境下的更便宜选择。
怎样避免动态代价失控
动态代价最常见的问题不是公式写错,而是某个输入变化后让所有其他动作都失去竞争力。实际项目中应限制单项贡献,并保持基础代价仍然有意义。
还要区分“不能执行”和“执行起来更贵”。例如没有弹药时,若攻击动作确实无法执行,应由前置条件排除;只有“弹药较少”时,才适合通过动态代价表达风险。
当战斗状态变化频繁时,不必每个变量变化都重建完整计划。可以在影响候选动作的关键事实发生变化时重新评分或触发重规划,这样既保留情境化决策,又避免规划器被高频状态更新反复打断。
最终要观察的不是某个动作的单独价格,而是当前状态下完整计划的总代价排序。只要代价模型能稳定地把“更危险、更昂贵、更难执行”的选择推向后方,它就真正发挥了动态决策的价值。