
游戏 AI / 系统课时
组合移动攻击补给动作
组合移动攻击补给动作
要让战斗 NPC 真正完成一套 GOAP 计划,动作不能只是一串独立技能,而要通过前置条件与效果连接成可搜索网络。本篇将移动、取弹药、换位、攻击和治疗组合起来,让一个目标可以经过多步规划自然落地。
学习目标
- 用前置条件和效果定义战斗动作的连接关系
- 理解动作如何在规划过程中逐步改变世界状态
- 设计一条从补给、换位到攻击或治疗的可搜索路径
动作连接的核心规则
每个动作至少需要三个信息:前置条件、效果、代价。前置条件决定动作能否进入候选集;效果决定执行后世界状态怎样变化;代价用于多个可行方案之间的比较。
例如 pickup_ammo 可以要求 NPC 到达弹药点且弹药不足,执行后把 ammo_low 变成 false。attack 又要求敌人在射程内且有可用弹药。这样,取弹药并不是“附属于攻击”的脚本步骤,而是一个可以被规划器发现的状态转换。
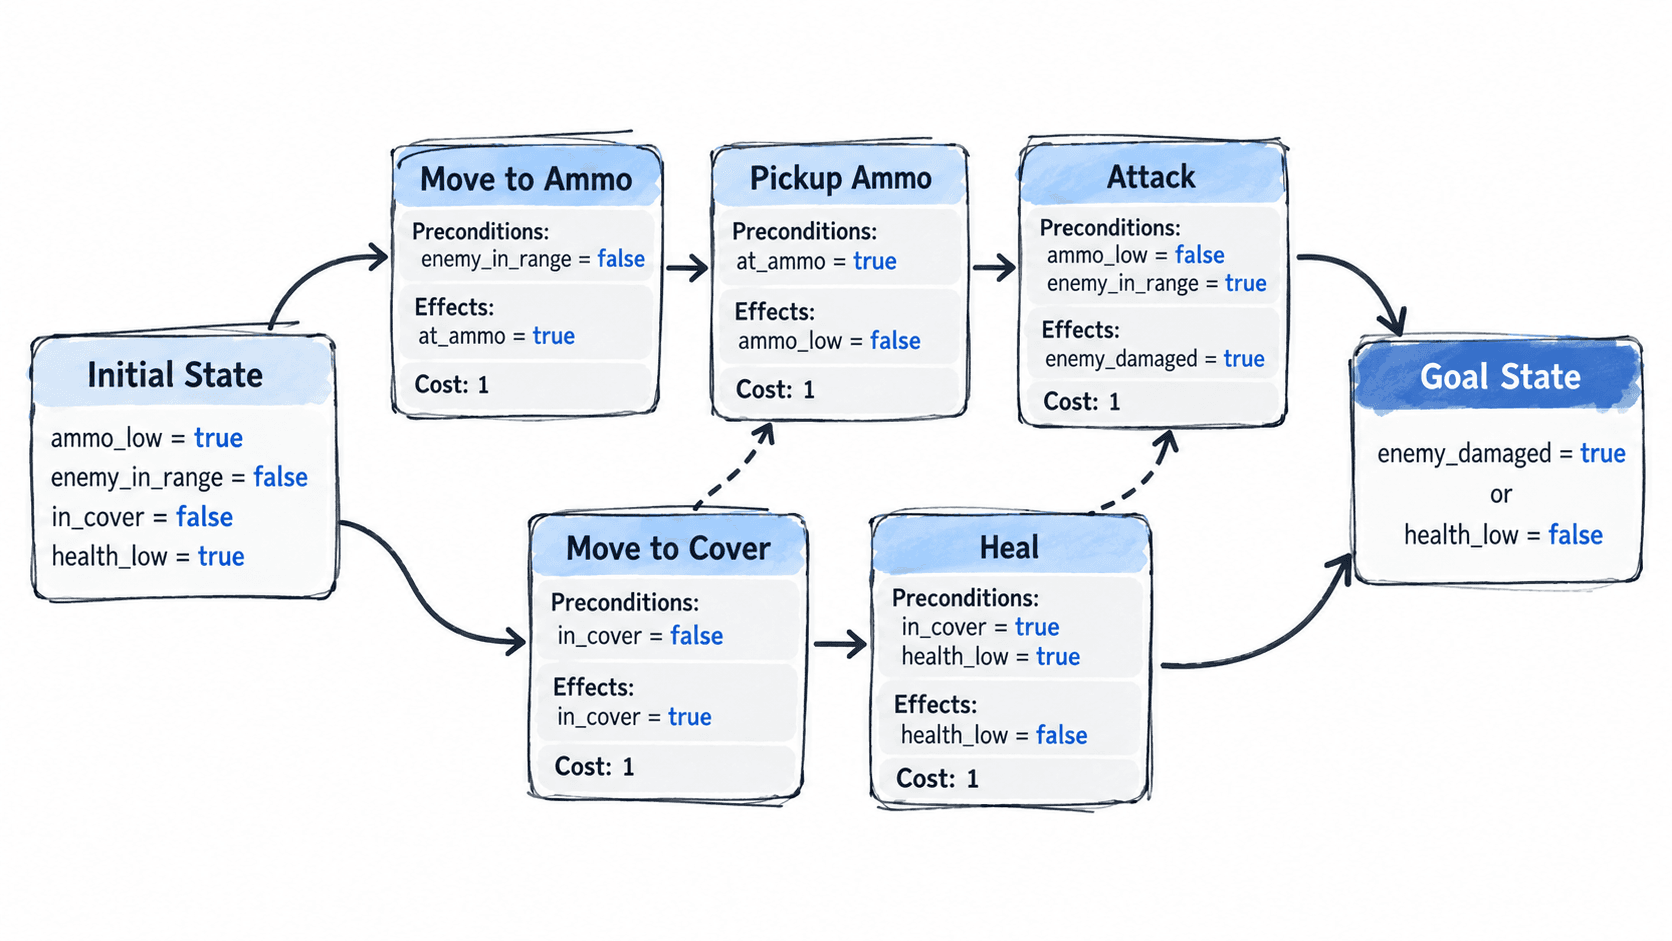
组合移动、补给与攻击
假设当前状态是 ammo_low=true,敌人存在但暂时不在射程内。规划器不应直接把 attack 判定为失败后结束,而应该继续搜索能够逐步满足攻击条件的动作。
一个典型链路可能是:先 move_to_ammo,再 pickup_ammo,随后 move_to_cover 或 move_to_enemy,最后执行 attack。每一步都必须让下一步所需的状态成立。例如移动到敌人附近后,enemy_in_range=true 才能使攻击动作进入候选集。
这里的关键不是人为规定动作顺序,而是让顺序由状态关系自然产生。同一套动作集合面对不同初始状态时,可以得到不同计划。例如已有足够弹药时会跳过补给;敌人已经在射程内时则可以直接进入攻击。
把治疗和换位接进同一网络
治疗通常与攻击目标存在竞争,因此更适合通过状态条件连接,而不是写成攻击失败后的硬编码后备逻辑。比如 heal 要求 health_low=true、has_medkit=true 和 in_safe_zone=true,效果则设置 health_low=false 并消耗治疗资源。
换位动作则负责改变空间相关事实,例如 move_to_cover 可以把 in_cover=false 变为 in_cover=true,并降低暴露风险。这样治疗和攻击都可以把换位当作自己的前置步骤,而不必彼此知道具体实现。
用最小实现验证动作能否搜索
下面用 Python 演示一个简化的状态搜索。它只保留布尔事实,用动作的 preconditions 检查可执行性,再用 effects 生成下一状态。示例不是完整游戏执行器,但足以验证动作之间是否真的连得起来。
from dataclasses import dataclass
from collections import deque

@dataclass(frozen=True)
class Action:
    name: str
    preconditions: frozenset[str]
    effects: frozenset[str]
    cost: int

    def apply(self, state: frozenset[str]) -> frozenset[str]:
        # 删除由 !fact 表示的旧值,再写入新事实
        next_state = set(state)
        for effect in self.effects:
            if effect.startswith("!"):
                next_state.discard(effect[1:])
            else:
                next_state.add(effect)
        return frozenset(next_state)


actions = [
    Action("move_to_ammo", frozenset({"ammo_low"}), frozenset({"at_ammo", "!ammo_low"}), 2),
    Action("move_to_enemy", frozenset({"at_ammo"}), frozenset({"enemy_in_range"}), 2),
    Action("pickup_medkit", frozenset({"at_ammo"}), frozenset({"has_medkit"}), 1),
    Action("move_to_cover", frozenset({"enemy_in_range"}), frozenset({"in_cover"}), 1),
    Action("attack", frozenset({"enemy_in_range", "in_cover", "!ammo_low"}), frozenset({"enemy_damaged"}), 3),
    Action("heal", frozenset({"in_cover", "has_medkit", "health_low"}), frozenset({"!health_low"}), 2),
]

start = frozenset({"ammo_low", "health_low"})
goal = "enemy_damaged"

queue = deque([(start, [])])
visited = {start}

while queue:
    state, plan = queue.popleft()
    if goal in state:
        print(" -> ".join(plan))
        break

    for action in actions:
        if action.preconditions <= state:
            next_state = action.apply(state)
            if next_state not in visited:
                visited.add(next_state)
                queue.append((next_state, plan + [action.name]))
else:
    print("NO_PLAN")
预期输出
move_to_ammo -> move_to_enemy -> move_to_cover -> attack规划网络不要直接等于执行脚本
实际项目中,规划阶段只应决定“需要执行哪些动作以及顺序”,动作真正执行时还需要再次检查运行时条件。例如 NPC 在 move_to_enemy 途中可能发现目标消失,此时原计划中的 attack 已经不再满足前置条件,应停止继续执行并重新获取世界状态规划。
因此,动作网络设计时要优先保证状态转换清晰、条件可验证、效果可预测。这样移动、补给、换位、攻击和治疗虽然分别实现,却可以共享同一个规划框架;当战斗规则变化时,通常只需增加或调整动作节点,而不是重写整套行为流程。