
游戏 AI / 系统课时
什么时候需要重新规划
什么时候需要重新规划
重规划的核心不是“发现变化就搜索”,而是找到一个足够可靠的触发门槛。每帧运行完整 GOAP 搜索通常会浪费计算,长期执行旧计划又会让 NPC 在目标已经失效后继续工作。本篇把重规划条件拆成事件、动作失败和计划失效三类,并给出一个可直接落地的触发策略。
学习目标
- 判断哪些状态变化值得触发重规划
- 避免每帧重复搜索造成不必要的开销
- 为重规划增加冷却、失败和计划版本控制
重规划应当由“有意义的变化”触发
一个简单原则是:只有可能改变当前最优行动路径的变化,才值得进入规划器。例如当前目标资源被抢走、玩家位置跨过关键范围、道路从可达变成不可达、敌人进入危险区域,都可能改变计划;相反,一个与当前目标无关的装饰物变化通常不需要搜索。
可以把触发源分成三组:外部世界事件、当前动作执行失败、计划自身失效。三组来源都指向同一个 request_replan 入口,避免在 NPC 的不同模块里各自实现一套规划逻辑。
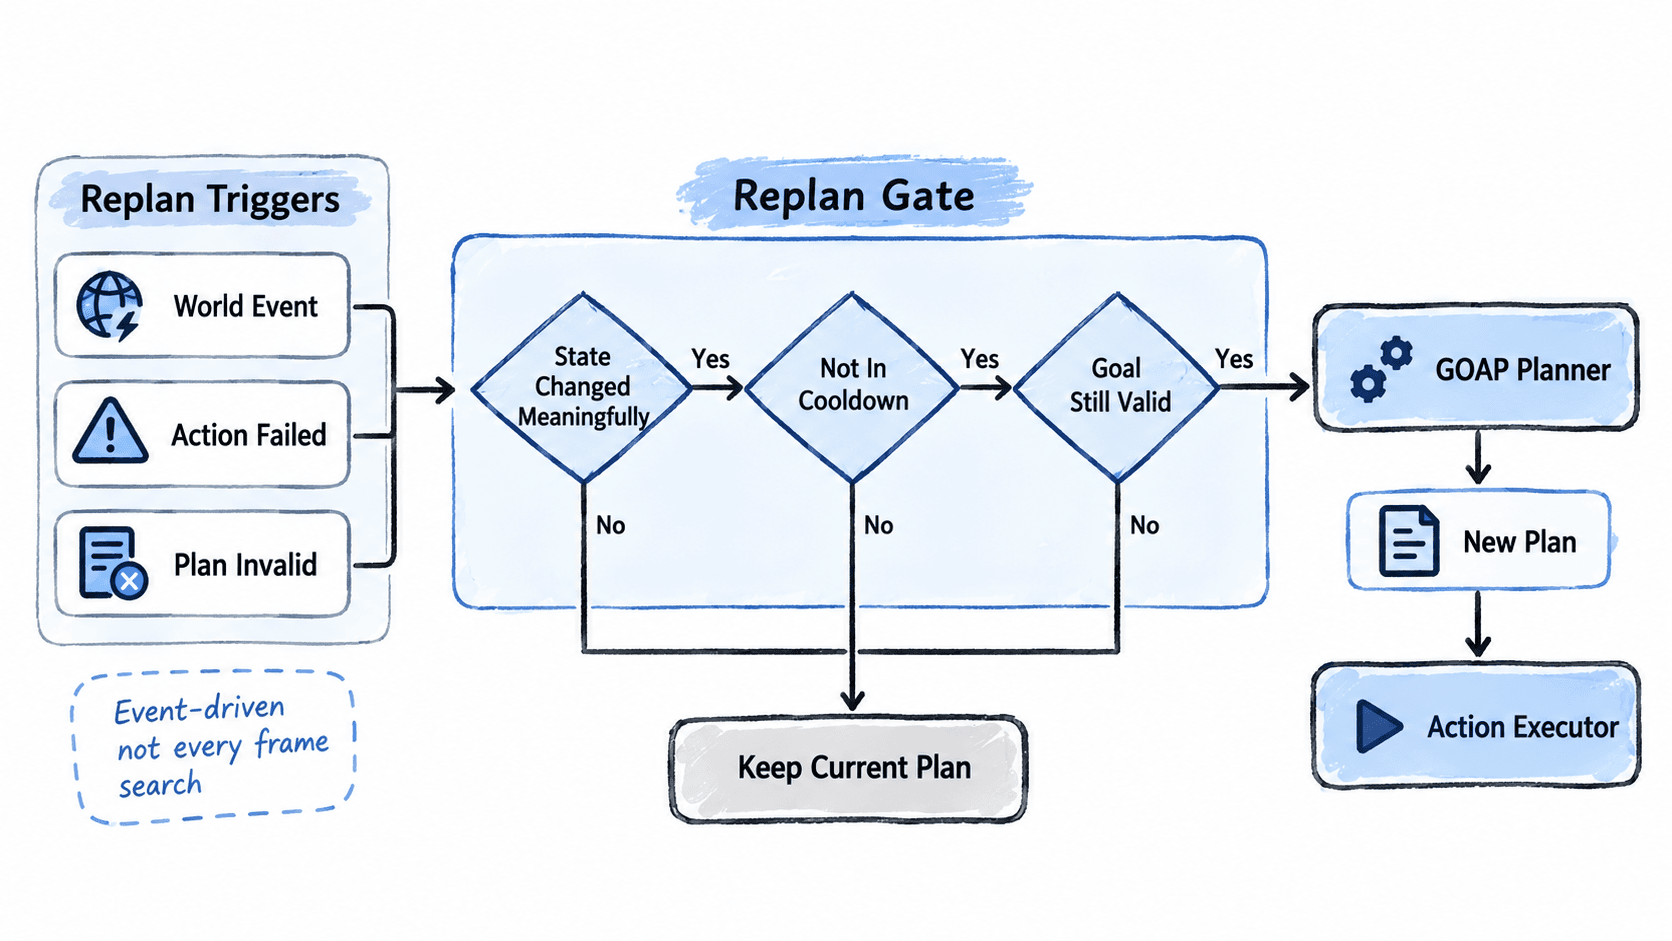
事件驱动比每帧搜索更合适
在实时游戏循环中,渲染可能每秒执行几十次甚至上百次,但环境中的“会改变计划的事件”远少于帧数。因此更合理的模式是让状态系统在重要变化发生时设置重规划请求,然后由执行循环统一消费这个请求。
下面的示例只在发生有效事件时请求重规划,并用最小冷却时间防止同一时刻的大量重复触发。
import time


class ReplanController:
    def __init__(self, cooldown_seconds=0.5):
        self.cooldown_seconds = cooldown_seconds
        self.pending = False
        self.last_replan_at = 0.0

    def request_replan(self, reason):
        self.pending = True
        print("replan requested:", reason)

    def consume(self, now):
        if not self.pending:
            return False
        if now - self.last_replan_at < self.cooldown_seconds:
            return False

        self.pending = False
        self.last_replan_at = now
        return True


controller = ReplanController(cooldown_seconds=0.5)
start = time.monotonic()

controller.request_replan("path_invalid")
print("planner_started:", controller.consume(start + 0.6))
print("planner_started_again:", controller.consume(start + 0.7))
预期结果
replan requested: path_invalid
planner_started: True
planner_started_again: False
这里的冷却不是替代状态检查,而是防止短时间内重复搜索。真实项目中还应把触发原因、当前目标和世界状态版本一起记录下来,便于调试为什么发生了一次重规划。
什么时候必须重新规划
当前计划前置条件失效通常属于强触发。例如动作需要目标存在,但目标已经死亡;移动需要路径可达,但寻路结果变为不可达;拾取需要资源存在,但资源已经被其他实体消耗。这类情况继续执行旧计划通常没有意义。
高价值目标或环境发生关键变化可以作为条件触发。例如目标从近距离移动到远距离,跨过行为策略阈值后,原计划可能已经不再合理。但不要为每一次坐标微变触发搜索,可以先把连续数值映射成少量具有规划意义的离散事实或区间。
动作连续失败也应触发重规划。单次失败可能只是瞬时碰撞或移动抖动,连续失败则说明原计划的假设正在持续失效。可以记录 failureCount,达到阈值后触发一次重新搜索,同时保留失败原因供规划器避开同一路径。
什么时候不应该重新规划
如果当前动作仍可安全完成,而且变化不会影响目标路径,就不必立即重规划。例如 NPC 正在完成一个不可分割的短交互,附近出现了一个与当前任务无关的敌人,系统可以先完成交互,再由下一次状态检查决定是否调整。
另一个常见错误是把“时间流逝”直接设为每帧重规划。更好的方法是使用动作级超时或计划有效期,例如计划超过若干秒仍未完成才重新评估。这样既能避免旧计划无限期存在,也不会把规划器变成帧循环中的固定成本。
给重规划加上计划版本
当多个系统都可能请求重规划时,容易出现旧计划覆盖新计划的问题。可以给每次规划结果分配递增版本号,执行器只接受当前版本的动作。当世界状态版本已经变化时,旧动作即使晚到也不能继续执行。
片段示例
class PlanState:
    def __init__(self):
        self.world_version = 0
        self.plan_version = 0

    def world_changed(self):
        self.world_version += 1

    def install_plan(self):
        self.plan_version = self.world_version

    def plan_is_current(self):
        return self.plan_version == self.world_version


state = PlanState()
state.install_plan()
print("current_before_change:", state.plan_is_current())

state.world_changed()
print("current_after_change:", state.plan_is_current())
预期结果
current_before_change: True
current_after_change: False
这种版本控制尤其适合异步规划器:后台搜索可能需要一段时间,但规划完成时必须确认它仍然对应当前世界状态,否则应丢弃旧结果并再次规划。最终目标不是让 NPC“经常重规划”,而是让它只在旧计划不再可信时重新搜索。