
游戏 AI / 系统课时
跑通第一条 GOAP 计划
跑通第一条 GOAP 计划
本课从一个最小目标出发,让规划器根据当前世界状态选择动作并生成完整计划。你会看到目标、动作前置条件和动作效果如何连接起来,最终得到一条可以逐步执行的行动序列。
学习目标
- 用前置条件和效果描述 GOAP 动作
- 从当前状态搜索到满足目标的最小计划
- 运行示例并验证生成的动作顺序与状态变化一致
先定义一个可验证的最小场景
为了避免一次引入太多机制,场景只保留三个事实:has_key、door_open 和 inside_room。NPC 当前没有钥匙,也没有进屋;目标是 inside_room=true。
需要的动作只有三个:先拾取钥匙,再开门,最后进入房间。每个动作都描述两部分信息:什么条件下可以开始,以及执行后会改变什么事实。
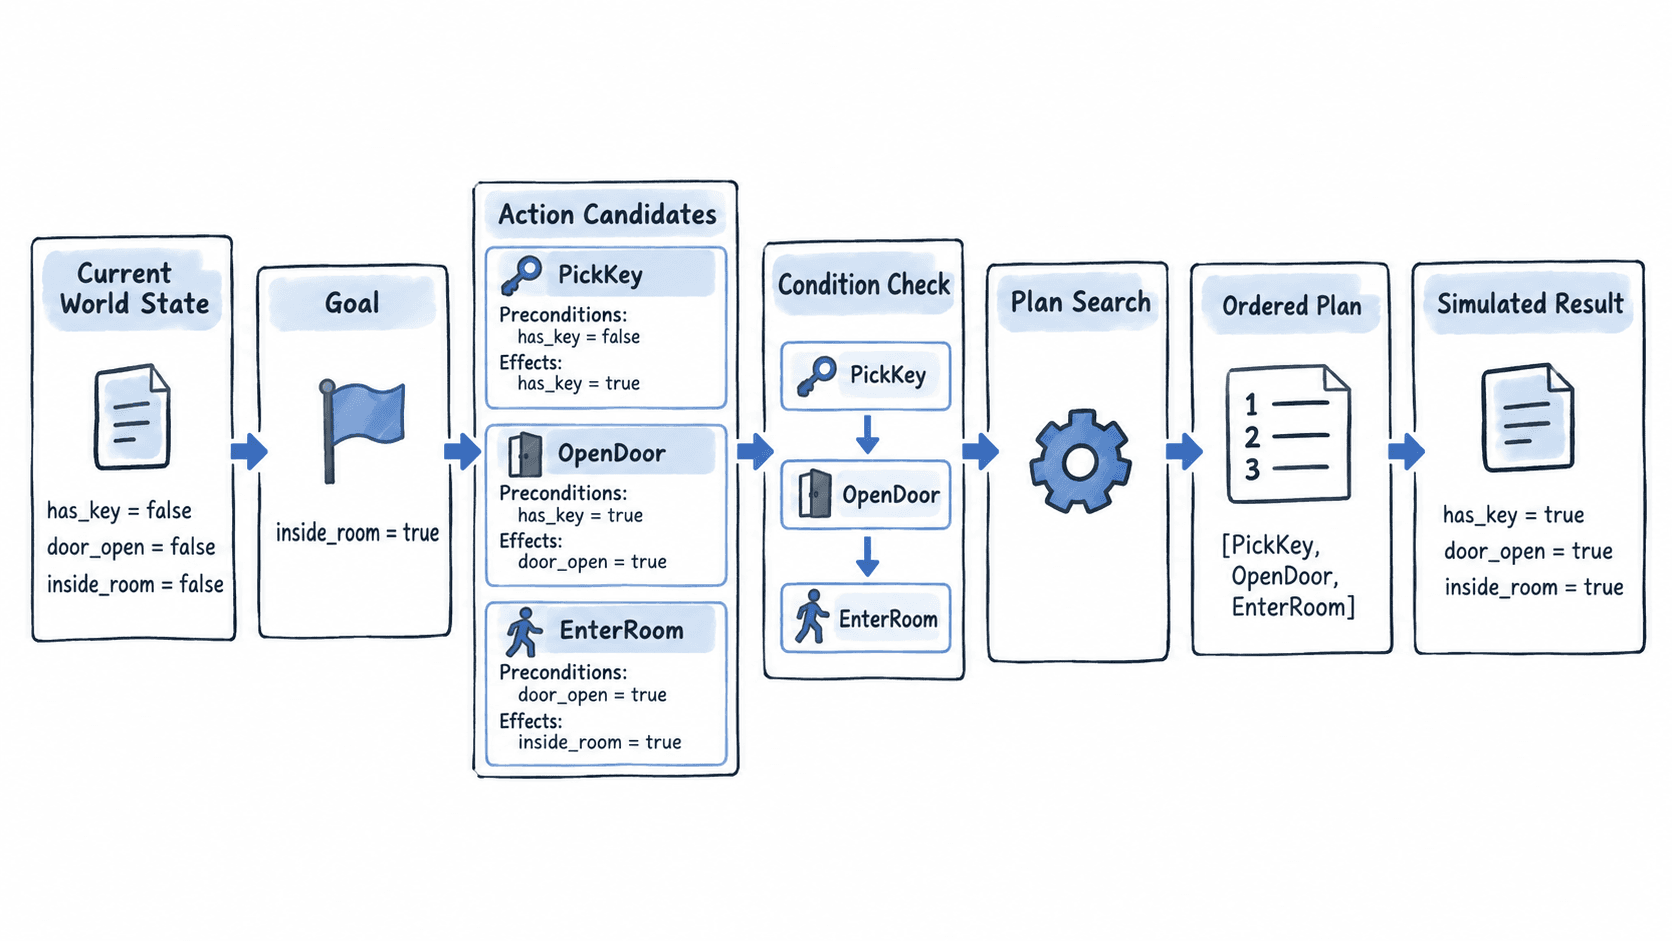
用动作的前置条件和效果描述行为
GOAP 不需要把“正确顺序”硬编码成一段脚本,而是检查哪一个动作能让当前状态更接近目标。PickKey 的效果是 has_key=true,所以它先让 OpenDoor 具备执行条件;OpenDoor 又让 EnterRoom 变得可行。
下面的示例实现一个最小前向搜索。状态使用字典表示,动作使用 preconditions 和 effects 两组映射;搜索时先检查前置条件,再复制状态并应用效果。这个例子省略代价、资源和动态世界同步,只用于跑通第一条计划。
from dataclasses import dataclass
from collections import deque

@dataclass(frozen=True)
class Action:
    name: str
    preconditions: dict
    effects: dict


def matches(state, conditions):
    return all(state.get(key) == value for key, value in conditions.items())


def apply_effects(state, effects):
    next_state = state.copy()
    next_state.update(effects)
    return next_state


def find_plan(start, goal, actions):
    queue = deque([(start, [])])
    visited = {tuple(sorted(start.items()))}

    while queue:
        state, plan = queue.popleft()
        if matches(state, goal):
            return plan

        for action in actions:
            if not matches(state, action.preconditions):
                continue

            next_state = apply_effects(state, action.effects)
            key = tuple(sorted(next_state.items()))
            if key in visited:
                continue

            visited.add(key)
            queue.append((next_state, plan + [action.name]))

    return None

start = {
    "has_key": False,
    "door_open": False,
    "inside_room": False,
}

actions = [
    Action("PickKey", {"has_key": False}, {"has_key": True}),
    Action("OpenDoor", {"has_key": True, "door_open": False}, {"door_open": True}),
    Action("EnterRoom", {"door_open": True, "inside_room": False}, {"inside_room": True}),
]

goal = {"inside_room": True}
plan = find_plan(start, goal, actions)
print(plan)
预期输出
['PickKey', 'OpenDoor', 'EnterRoom']这里使用队列做最短步数搜索,因此在没有代价权重的前提下,会优先得到动作数量更少的计划。真正的 GOAP 通常还会为动作加入成本,并在候选计划之间比较总成本,但“检查前置条件、应用效果、继续搜索”这条核心链路不会改变。
检查计划是不是可执行的
生成计划并不等于动作已经成功执行。游戏运行期间可能发生攻击、掉落钥匙或门被其他系统关闭,因此实际执行器应在每个动作开始前重新检查前置条件,执行后再把结果写回世界状态。
一个稳妥的边界是:规划器负责回答“当前已知状态下应该做什么”,执行器负责回答“这个动作现在还能不能做以及做完实际发生了什么”。当实际结果与预期效果不一致时,应重新采集状态并规划,而不是继续盲目执行旧计划。
让第一条计划保持最小
初次实现时,只加入能够推动目标的动作。动作越多,搜索空间越大,也越容易出现多个等价计划,让调试变困难。等最小计划稳定后,再加入移动、战斗、资源消耗等真实约束,并为这些动作配置明确成本。
最终可以用一个简单验收标准判断 GOAP 是否跑通:从固定初始状态开始,规划器返回非空计划;按顺序应用动作效果后,目标事实成立;任意一步前置条件失效时,执行器能够停止当前计划并触发重新规划。