
游戏 AI / 系统课时
动作效果如何驱动后续规划
动作效果如何驱动后续规划
本篇解决 GOAP 中“一个动作做完后,为什么下一个动作能接上”的问题:把动作完成后发生的状态变化明确写成效果,让规划器可以用更新后的世界状态继续寻找后续动作,最终形成完整行动序列。
学习目标
- 能区分动作执行前的前置条件与执行后的效果
- 能用增量状态变化描述动作结果
- 能通过一个连续动作链验证效果如何打开下一步规划
效果描述的是状态变化
动作效果回答“动作成功完成后,世界发生了什么”。例如 find-key 的效果可以是 hasKey=true,而 open-door 的效果可以是 doorOpen=true。
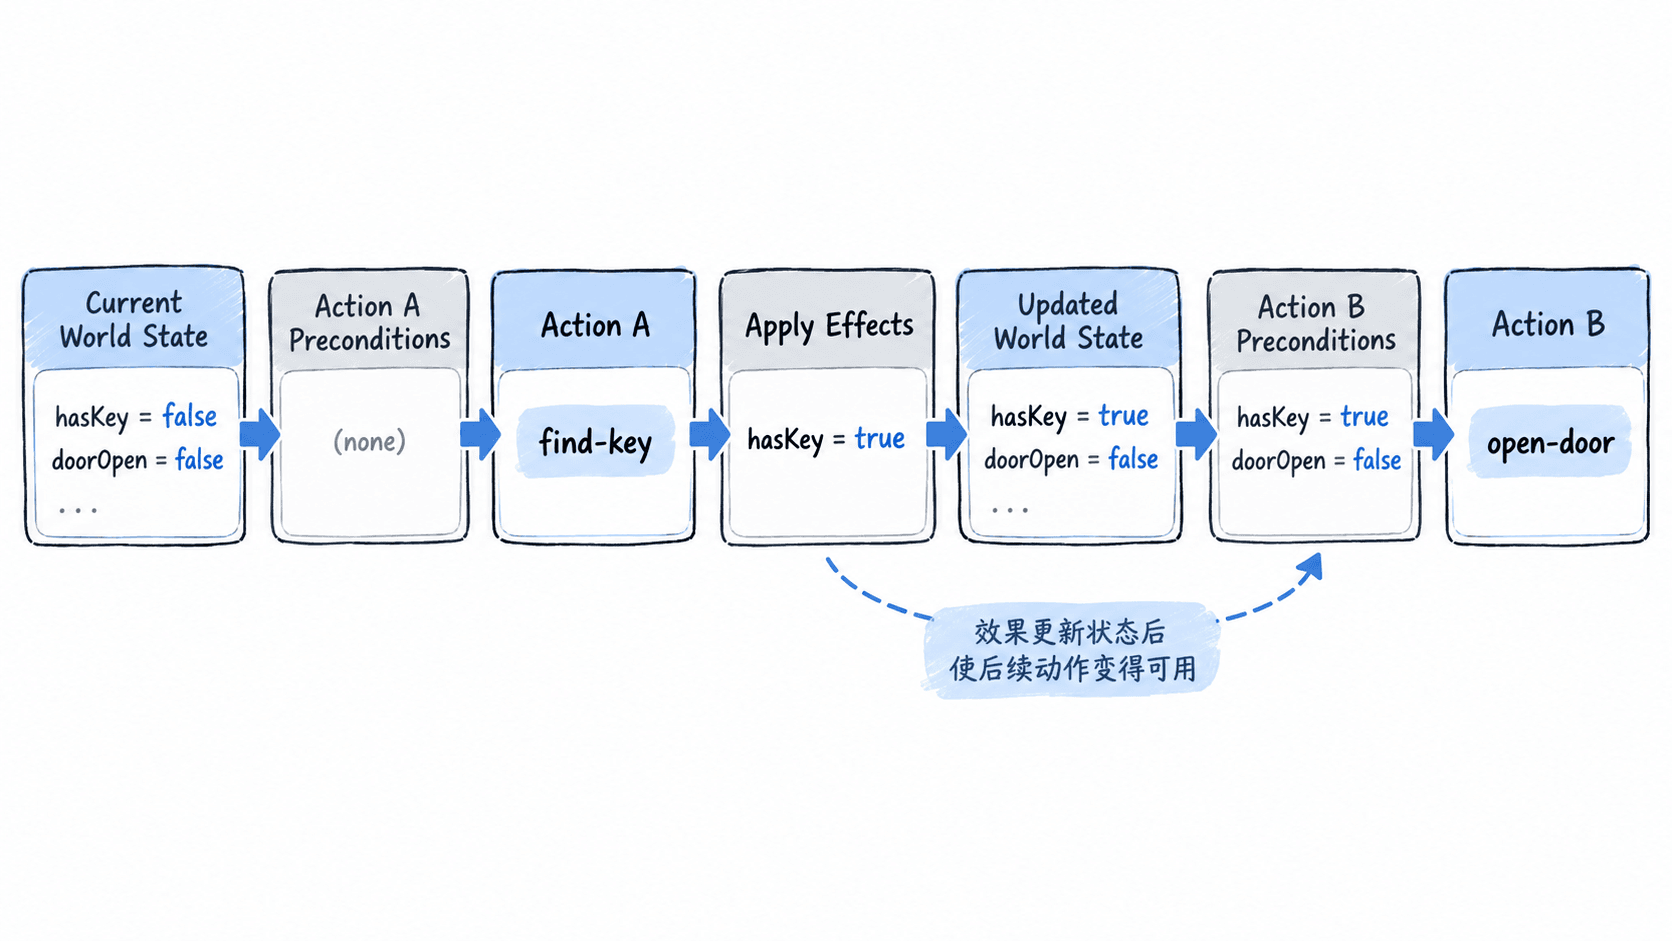
规划器并不需要重新执行游戏逻辑才能理解下一步。它可以先把效果应用到规划中的模拟世界状态,再检查其他动作的前置条件。如果某个效果恰好满足了另一个动作的条件,后者就可能成为下一步候选。
为什么效果必须可计算
如果效果只写成“把门打开”,规划器很难判断下一步条件是否满足。更适合规划的数据是结构化状态,例如 doorOpen=true、alarmLevel=0 或 hasItem=medkit。
动作效果通常分成两类:一类是新增或覆盖状态,例如把 hasKey 从 false 变成 true;另一类是移除状态,例如消耗道具后把 hasKey 改回 false。关键是明确“应用效果后”的状态,而不是只描述自然语言结果。
用状态副本模拟连续动作
下面的示例构造两个动作:先寻找钥匙,再开门。规划器通过复制世界状态并依次应用效果,可以验证第二个动作是否在第一步之后可执行。
world = {
    "hasKey": False,
    "doorOpen": False,
}

find_key = {
    "name": "find-key",
    "preconditions": {"hasKey": False},
    "effects": {"hasKey": True},
}

open_door = {
    "name": "open-door",
    "preconditions": {"hasKey": True, "doorOpen": False},
    "effects": {"doorOpen": True},
}

planned = world.copy()
for action in (find_key, open_door):
    if not all(planned.get(k) == v for k, v in action["preconditions"].items()):
        print(f"blocked={action['name']}")
        break

    planned.update(action["effects"])
    print(f"applied={action['name']} state={planned}")
预期输出
applied=find-key state={'hasKey': True, 'doorOpen': False}
applied=open-door state={'hasKey': True, 'doorOpen': True}
这个结果体现了 GOAP 的关键连接:第一步的效果 hasKey=true 让第二步的前置条件成立,第二步再通过 doorOpen=true 推动世界继续变化。真实项目通常还需要处理数值比较、资源消耗和动作失败回滚,但基本机制保持不变。
效果设计的边界
不要把所有运行时细节都塞进效果集合。效果应该描述规划器关心的世界事实,例如目标是否达成、资源是否获得、位置是否改变;具体播放哪段动画、调用哪个组件、等待多久,应留在动作执行层。
同时要注意“效果是否一定成立”。规划阶段模拟的是成功路径,因此效果通常代表动作成功后的预期状态。真正执行时若动作失败,例如寻路中断或交互被取消,应由运行时重新同步世界状态,再决定是否重新规划。
一个动作的效果写得越清晰,规划器越容易把多个动作串成可解释的链条。判断标准很简单:动作完成后,新增的状态是否足以让规划器准确判断哪些后续动作已经可以继续。