
区块链原理 / 系统课时
权衡 STARK 透明性与证明体积
权衡 STARK 透明性与证明体积
选择 STARK 证明方案时,不能只看它不需要可信设置,还必须考虑证明体积、验证开销、哈希安全假设以及零知识属性。本篇通过一个链上验证场景,建立可实际用于技术选型的比较方法,并区分透明性、可靠性与隐私保证。
学习目标
- 解释 STARK 透明设置的含义及其依赖的密码学假设。
- 估算证明体积对链上数据费用和验证成本的影响。
- 判断 STARK 的适用场景,并识别透明设置与零知识保证的区别。
透明设置究竟省去了什么
STARK(Scalable Transparent Argument of Knowledge)是一类基于代数编码、交互式预言机证明及密码学哈希等技术构建的可扩展证明系统。它的透明性主要指公开参数的生成不依赖必须保密的随机陷门。
某些需要可信设置的 SNARK 方案会生成证明密钥和验证密钥。如果设置过程中产生的秘密陷门被攻击者掌握,可能破坏证明系统的可靠性。STARK 则通常使用公开的协议参数与随机挑战,不需要参与者共同销毁秘密陷门。
但透明性并不表示没有密码学假设。典型 STARK 实现依赖以下条件:
- 哈希安全性:Merkle 承诺通常依赖哈希函数的抗碰撞等性质,具体要求取决于证明构造和安全模型。
- 低度测试可靠性:FRI 协议用于检验被承诺的函数是否接近低度多项式,其可靠性取决于查询次数、码率等参数。
- 挑战不可预测性:非交互式证明通常通过 Fiat–Shamir 变换,从证明上下文生成挑战,并在随机预言机模型等假设下分析安全性。
例如,对同一条计算轨迹,若将 FRI 查询次数从 30 增加到 40,通常可以降低某些作弊策略通过验证的概率,但也往往增加证明字节数和验证所需的哈希工作量。不能脱离具体协议,直接将查询次数等同于安全位数。
为什么 STARK 证明通常更大
典型 STARK 证明包含多个多项式承诺、FRI 折叠过程中的数据、查询位置的取值以及 Merkle 认证路径。验证者通过少量抽样查询检查大规模计算轨迹的约束是否成立。
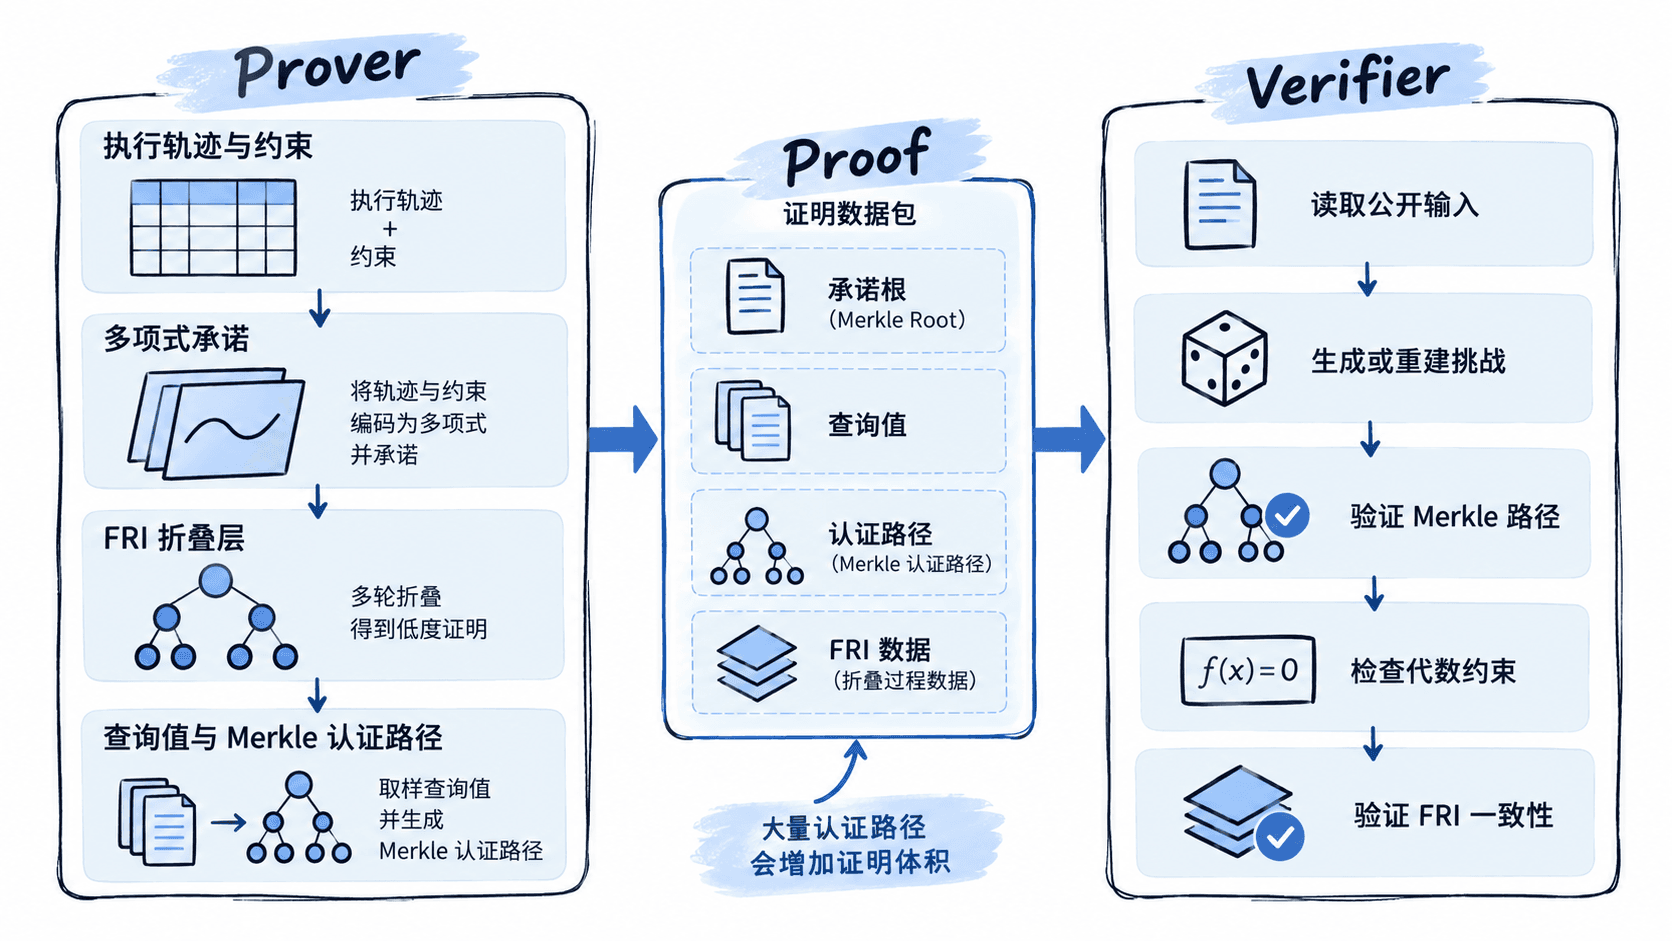
Merkle 认证路径的大小可以用一个简化模型估算。假设一棵二叉 Merkle 树有 1,048,576 个叶子,哈希摘要长 32 字节,则单个叶子的认证路径高度为 20,路径中的兄弟摘要共占 640 字节。
如果有 40 次彼此独立、未压缩且不共享节点的查询,认证路径数据理论上合计 25,600 字节,即约 25 KiB。这还未计入被查询的叶子数据、FRI 其他轮次、承诺根与证明元数据。
实际 STARK 会采用批量查询、共享认证节点、多证明对象打包等优化,因此不能把 25 KiB 当作所有实现的固定开销。证明大小还受执行轨迹长度、FRI 参数、哈希输出长度及安全目标影响。
与部分基于配对的简洁 SNARK 相比,STARK 证明常见量级为数十至数百 KiB,而一些简洁 SNARK 证明可能只有数百字节。这只是工程量级参考,不是所有实现的统一基准。比较时必须明确具体协议、参数、公开输入规模及证明序列化格式。
把证明体积换算成链上成本
考虑一个将 STARK 证明直接提交到以太坊执行层交易 calldata 的场景。假设序列化证明长 80 KiB,即 81,920 字节,其中 80% 为非零字节、20% 为零字节。
按普通交易 calldata 的计费规则,非零字节通常计 16 gas,零字节计 4 gas。忽略取整差异,数据部分的估算为:
因此,仅 calldata 数据部分就约需 111 万 gas;尚未计入交易基础开销、验证合约执行、内存扩展等其他费用。这里使用的是普通 calldata 模型,不能直接套用于 blob 数据、不同链的 DA 定价或采用特殊数据发布机制的 Rollup。
| 比较项 | 假设方案 A | 假设方案 B |
|---|---|---|
| 证明大小 | 80 KiB | 256 B |
| 非零字节比例 | 80% | 80% |
| 数据 gas 估算 | 1,114,112 | 约 3,482 |
| 链上验证计算 | 需要单独测量 | 需要单独测量 |
表中 B 仅作为同等字节分布下的简洁证明体积对照,不代表某个具体 SNARK 的完整链上成本。证明短不保证验证便宜:配对运算、哈希运算、公开输入处理和合约实现都会影响实际 gas。
生产选型时应在同一链、同一安全目标和同一业务电路下分别记录证明字节数、完整交易 gas、证明耗时、验证耗时。若证明先在链下聚合或递归压缩,再提交一个较小的外层证明,则必须测量最终链上提交的证明,而不能直接套用原始 STARK 体积。
验证速度与体积为何不能单独优化
STARK 验证者通常不重放全部原始计算,而是验证承诺开启、代数一致性与 FRI 低度测试。对适当构造的方案,其验证复杂度可以随计算规模缓慢增长,但具体速度并非只由计算轨迹长度决定。
评估验证成本时,需要同时记录四组参数:
| 参数 | 调整后的典型影响 | 需要检查的代价 |
|---|---|---|
| FRI 查询次数增加 | 通常降低可靠性错误概率 | 更多查询数据与哈希验证 |
| FRI 折叠和码率参数改变 | 影响可靠性与轮次数 | 证明体积、运算量及内存 |
| 哈希摘要或安全参数调整 | 改变承诺相关安全余量 | 路径大小及哈希计算成本 |
| 递归证明或外层包装 | 可减小最终提交数据 | 新增证明时间与实现复杂度 |
例如,某个批量证明服务每 60 秒生成一次证明,平均提交 80 KiB 数据。若改用递归包装后只提交 1 KiB,但额外增加 20 秒证明生成时间,就必须检查业务的最终确认延迟是否允许这 20 秒开销。这些数值是选型算例,不代表特定证明框架的实测性能。
透明性和零知识是两项不同保证
STARK 的透明性描述参数生成方式;零知识描述证明是否泄露超出公开陈述以外的见证信息。两者分别回答不同问题。
假设需要证明某用户持有一个满足约束的秘密余额,同时不披露余额本身。证明计算正确性,并不自动意味着秘密余额不会通过轨迹、承诺或查询值泄露。
实现零知识通常需要在 AIR(代数中间表示)及证明协议允许的条件下引入随机掩码、随机化轨迹或其他隐藏机制,并使用相应的零知识安全分析。掩码还必须与边界约束、公开输入和查询机制兼容,不能随意给计算轨迹添加噪声。
在工程验收中,应分别核对:
- 可靠性:伪造不满足约束的见证时,验证器应拒绝;所用参数必须达到指定安全目标。
- 透明性:公开参数生成是否不依赖秘密陷门,以及是否存在其他外部信任前提。
- 零知识:协议文档是否明确声明零知识性质,相关模式是否实际启用,并确认哪些输入和输出被公开。
某些 STARK 实现可能只提供透明的有效性证明,而没有启用零知识隐藏。另一些实现同时满足透明性和零知识,但可能付出额外证明体积、计算量或协议复杂度。
按业务约束选择方案
可以用三个典型部署场景做初步判断。
- 链下批量计算验证:验证发生在服务器,带宽相对充裕,重点是避免可信设置并支持大规模计算。STARK 值得优先测试。
- 以太坊主网直接提交:每笔交易都要支付数据和验证费用,证明体积的影响显著。应比较原生 STARK、简洁 SNARK 与递归包装方案的完整 gas。
- 隐私资产或身份声明:如果包含秘密见证,先确认具体协议具有所需的零知识保证,再比较透明性和性能。
一个可执行的方案筛选标准是:设置过程不得依赖秘密陷门;目标安全强度至少为 128 位;最终链上验证与数据提交合计不超过项目预算;单批证明从数据截止到可提交不超过 60 秒。这里的预算和时间是示例验收条件,实际应由产品约束确定。对于声称达到 128 位安全性的实现,还必须检查其可靠性、安全证明和参数配置是否真正支持该目标,不能仅根据哈希输出位数认定。
最终应保留一张来自同一测试环境的实测记录,包括协议版本、参数、证明大小、生成时间、验证时间、完整 gas 和零知识启用状态。STARK 的透明设置能减少一类信任负担,但证明体积和链上验证成本仍需通过具体实现与目标部署环境验证。