
AI 与工程数学 / 系统课时
识别缩放不当带来的病态性
识别缩放不当带来的病态性
有些梯度下降代码没有写错,却需要成千上万次迭代才接近最优点。常见原因不是算法失效,而是变量尺度差异让目标函数变成狭长峡谷。本节从条件数、等高线和实际迭代次数出发,说明缩放与预处理为什么能直接改变数值求解效率。
学习目标
- 能从量纲差异、狭长等高线和较大条件数识别缩放不当的问题。
- 能解释条件数为什么限制梯度下降可用步长并导致来回震荡。
- 能用变量缩放把同一个最优问题改写成更容易求解的数值形式,并验证迭代改善。
病态不是算法坏了,而是尺度差太大
考虑二次函数 。沿 方向,函数弯曲程度是 方向的 1000 倍。它的 Hessian 为 ,2-范数条件数为 。
这种目标函数的等高线是非常狭长的椭圆。梯度总是垂直于等高线,因此迭代点容易在陡峭方向两侧反复跳动,却只在平缓方向缓慢前进。为了不在陡峭方向发散,步长又不能取得太大,于是整体收敛被最难处理的方向拖慢。
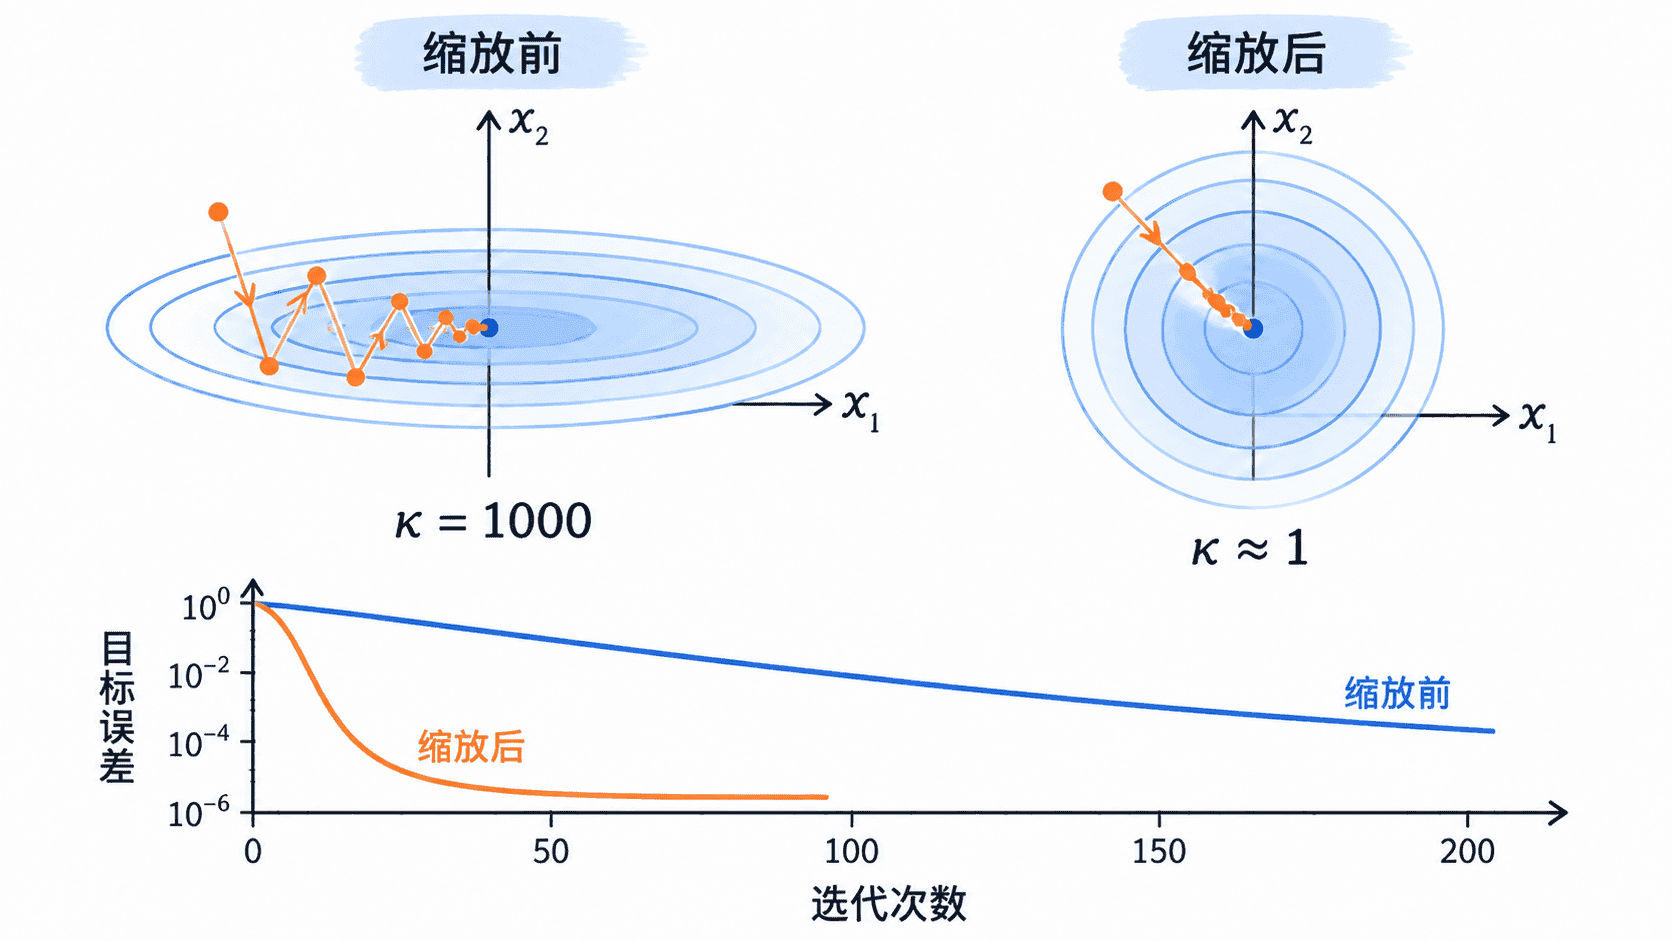
条件数为什么拖慢梯度下降
对正定二次函数,Hessian 的最小特征值 表示最平缓方向的曲率,最大特征值 表示最陡方向的曲率,条件数可写成 。当 很大时,一个统一学习率必须同时照顾两种完全不同的曲率。
步长太大,陡峭方向会发散;步长太小,平缓方向又推进得极慢。即使选用理论上较好的固定步长,也会出现收敛因子接近 1 的情况。这就是“看起来每一步都在下降,但下降得非常慢”的典型病态表现。
变量缩放如何改变问题
对上面的例子,令 ,其中 。由于 ,变换后的二次项矩阵为 。原本一长一短的两个曲率方向被拉到相同尺度,条件数从 1000 变为 1。
这个变换没有删除信息,也没有改变原问题的最优解含义,只是换了更适合数值计算的坐标系。工程里的特征标准化、变量归一化和预处理都在做类似的事情,只是实际问题通常无法像这个二次函数一样一次得到完美缩放。
用迭代次数验证缩放效果
下面固定使用普通梯度下降,并以参数向量的 L2 范数不超过 作为停止条件。为了突出缩放本身的作用,示例选择一个可以精确分析的二次函数。
import numpy as np

def gradient_descent(A, x0, alpha, tol=1e-6, max_iter=20000):
    x = x0.astype(float).copy()
    for k in range(1, max_iter + 1):
        # 对 f(x)=1/2*x^T*A*x,梯度就是 A@x。
        x = x - alpha * (A @ x)
        if np.linalg.norm(x, ord=2) <= tol:
            return k
    return max_iter

A = np.diag([1.0, 1000.0])
x0 = np.array([10.0, 10.0])
alpha = 2.0 / (1.0 + 1000.0)

raw_iters = gradient_descent(A, x0, alpha)

# z=Sx 后,新的 Hessian 变成单位阵;这是理想化的完全缩放。
S = np.diag([1.0, np.sqrt(1000.0)])
S_inv = np.linalg.inv(S)
A_scaled = S_inv.T @ A @ S_inv
z0 = S @ x0
scaled_iters = gradient_descent(A_scaled, z0, alpha=1.0)

print(f"原始条件数: {np.linalg.cond(A):.1f}")
print(f"缩放后条件数: {np.linalg.cond(A_scaled):.1f}")
print(f"原始坐标迭代次数: {raw_iters}")
print(f"缩放后迭代次数: {scaled_iters}")
预期输出
原始条件数: 1000.0
缩放后条件数: 1.0
原始坐标迭代次数: 8233
缩放后迭代次数: 1
这里的“一次收敛”来自特意构造的二次函数和精确缩放,不能机械推广到真实任务。它要证明的是:坐标尺度会直接改变 Hessian 的数值几何,从而改变同一种算法的可用步长和迭代效率。
实际工程该怎么缩放
如果不同特征的典型数值相差几个数量级,先检查是否存在单位差异,例如米与毫米、元与万元混用。机器学习中可用均值方差标准化让特征处于接近的数值范围;物理建模中更适合按特征尺度做无量纲化;对大型线性或二次子问题,则常通过预条件器近似抵消不同方向的曲率差异。
排查“收敛很慢”时,不要只调学习率。先看变量范围、梯度各分量量级、等高线是否狭长,以及 Hessian 或近似 Hessian 的条件数;如果这些信号同时出现,优先处理缩放通常比继续微调固定步长更有效。