
AI 与工程数学 / 系统课时
给最小二乘加入正则化
给最小二乘加入正则化
普通最小二乘只关心训练数据上的拟合误差,当特征相关、样本不足或模型自由度偏高时,参数可能变得很大且不稳定。正则化把“参数不要过度复杂”的要求直接加入优化目标,使拟合效果与模型复杂度在同一个问题中权衡。
学习目标
- 理解正则项如何改变最小二乘的优化目标
- 区分 L2 的连续收缩与 L1 的稀疏化效果
- 能根据正则强度的变化判断欠约束和过度约束
从拟合误差变成带惩罚的目标
普通最小二乘只最小化数据误差。加入正则化后,可以统一写成
( J(b)=E(b)+λR(b) )
其中 表示拟合误差, 表示参数复杂度, 控制两者的权衡。 时退化为普通最小二乘; 越大,优化器越愿意牺牲一部分拟合能力来获得更小、更简单的参数。
L2 正则常使用 。它会持续惩罚大系数,因此多个相关特征的权重通常会一起向零收缩,但一般不会恰好变成零。这类模型常被称为岭回归。
L1 正则使用 。由于目标函数在零点具有尖角,一些较弱参数可能被直接压到零,因此它除了限制复杂度,还能够产生稀疏参数。这类最小二乘模型通常称为 Lasso。
L2 和 L1 改变参数的方式
假设模型中有多个参数,随着 从小到大增加,L2 通常让每条参数曲线平滑地靠近零;L1 则可能让部分参数在某个正则强度后碰到零,并继续保持为零。
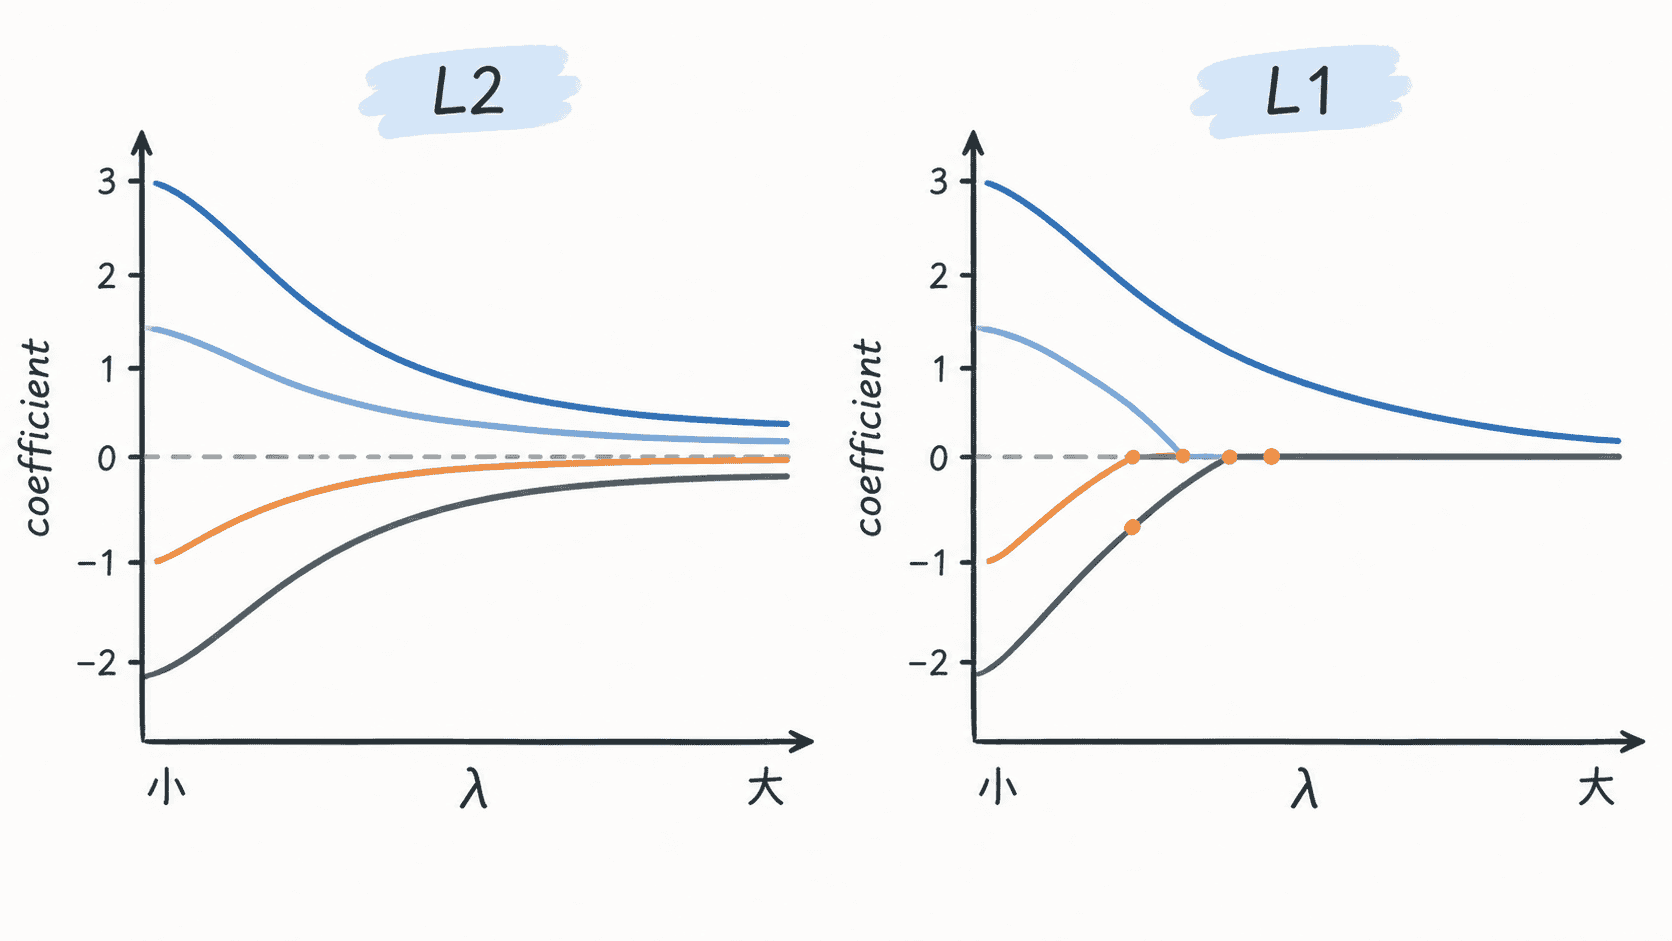
因此,两种正则不能简单理解为“惩罚公式不同”。如果希望大量相关特征共同保留但权重更稳定,L2 往往更自然;如果希望模型自动产生一部分零系数,L1 更符合目标。不过,当多个特征高度相关时,L1 可能只保留其中一部分,具体选择也可能对数据扰动较敏感。
用一个可算清的例子观察收缩
为了只观察正则项的作用,下面取特殊设计矩阵 。此时每个参数互不耦合,普通最小二乘解就是观测向量本身。对于本例采用的平方误差定义,L2 解为原系数除以 ,L1 解则相当于对每个系数执行阈值为 的软阈值操作。
import numpy as np

y = np.array([3.0, 0.6, 0.2, 0.0])

def ridge_identity(values, lam):
    # 在 X=I 的特殊情形下,L2 会按同一比例连续收缩系数。
    return values / (1.0 + lam)

def lasso_identity(values, lam):
    # 本例目标为平方误差加 lam * L1,因此软阈值是 lam / 2。
    threshold = lam / 2.0
    return np.sign(values) * np.maximum(np.abs(values) - threshold, 0.0)

for lam in [0.0, 0.4, 1.2]:
    ridge = np.round(ridge_identity(y, lam), 3).tolist()
    lasso = np.round(lasso_identity(y, lam), 3).tolist()
    print(f'lambda={lam:.1f}')
    print('  L2:', ridge)
    print('  L1:', lasso)
预期输出:
lambda=0.0
  L2: [3.0, 0.6, 0.2, 0.0]
  L1: [3.0, 0.6, 0.2, 0.0]
lambda=0.4
  L2: [2.143, 0.429, 0.143, 0.0]
  L1: [2.8, 0.4, 0.0, 0.0]
lambda=1.2
  L2: [1.364, 0.273, 0.091, 0.0]
  L1: [2.4, 0.0, 0.0, 0.0]
当 时,L2 中三个非零参数都缩小,但仍保持非零;同一强度下,L1 已经把原本只有 0.2 的参数压成零。继续把 提高到 1.2,L1 只剩最大的参数,而 L2 仍然保留三个不同大小的非零值。
正则强度不能靠训练误差选择
如果只观察训练集误差,增大 通常不会让结果越来越好,因为正则化本来就在主动限制参数。真正需要比较的是模型在未参与拟合的数据上的表现,因此工程上通常通过验证集或交叉验证选择 。
还有一个容易忽略的前提:正则化直接惩罚参数大小,因此特征尺度会影响惩罚效果。一个取值范围为 0~1 的特征与一个取值范围为 0~100000 的特征,如果不做适当缩放,它们对应的系数大小不能公平比较。对需要惩罚系数的模型,通常应先标准化数值特征,再搜索合适的 。
截距是否参与正则化也要遵循所用模型和库的定义。常见实现会单独处理截距,而不是像普通特征系数一样施加惩罚,因此不能仅凭数学公式猜测具体 API 的行为。
怎么选择 L1 还是 L2
当主要问题是系数过大、共线性导致参数不稳定,且没有强烈的特征筛选需求时,可以优先尝试 L2。它的目标光滑,数值优化通常也更容易处理,并能让相关特征共同承担解释作用。
当参数稀疏本身就是需求,例如希望大量弱特征系数直接变成零时,可以考虑 L1。但零系数并不自动等于可靠的因果特征选择,尤其在强相关特征之间,最终留下哪一个可能随样本发生变化。
无论选择哪一种, 都不是越大越安全。太小无法有效约束模型,太大会把真正有用的信号也压掉。正则化真正解决的是拟合能力与参数复杂度之间的可控权衡,而不是单纯让所有参数尽可能小。