
AI 与工程数学 / 系统课时
用变量缩放修复难收敛问题
用变量缩放修复难收敛问题
当优化变量相差几个甚至十几个数量级时,求解器可能把某个方向的微小梯度误判为已经收敛。本节用同一个 SciPy 问题比较缩放前后的结果,观察终止精度与迭代行为,并整理一套可复用的尺度检查方法。
学习目标
- 判断变量数量级差异是否正在破坏数值求解
- 使用无量纲变量完成缩放,并把结果转换回原始单位
- 同时检查迭代次数、目标值和相对误差,识别假收敛
为什么尺度差会造成假收敛
考虑两个最优值分别约为 1e6 和 1e-3 的变量。若直接在原始坐标中优化,相同的物理偏差会产生完全不同数量级的梯度。求解器看到的等高线会非常狭长,某些方向的梯度甚至可能已经低于终止阈值,但变量距离真正最优点仍然很远。
例如目标函数可以写成 。它在物理意义上只是两个标准化误差平方和,但直接对 x 求导后,两个方向的曲率相差极大。
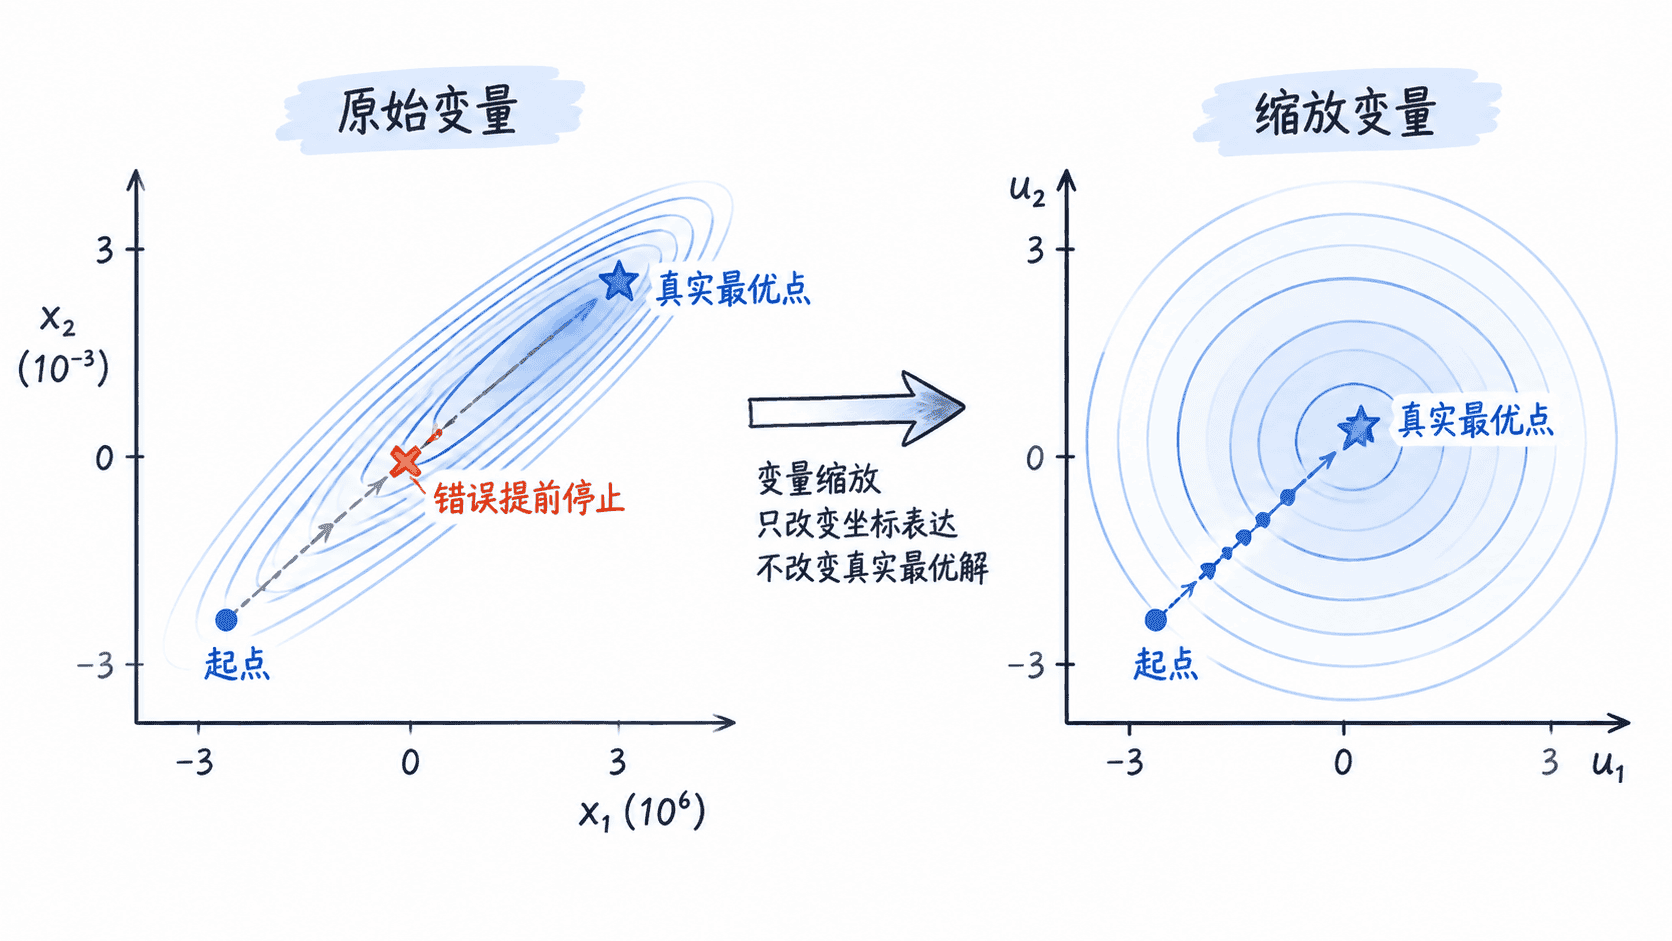
缩放的目标不是让数字看起来整齐,而是让优化器在各个方向上看到相近的数值尺度。常见做法是定义 x = scale * u,让新的无量纲变量 u 在最优点附近大致落在 0.1 到 10 的范围内。
用同一问题比较缩放前后
下面使用 BFGS 和解析梯度。原始变量的梯度在第一个方向上非常小,因此 gtol=1e-5 可能触发过早终止;缩放后两个方向具有相近的曲率,终止条件能够更准确地反映是否真正接近最优点。
import numpy as np
from scipy.optimize import minimize

TARGET = np.array([1e6, 1e-3])
SCALE = np.array([1e6, 1e-3])

# 原始坐标:目标函数已经标准化,但对物理变量求导后曲率仍相差巨大。
def objective_raw(x):
    error = (x - TARGET) / SCALE
    return 0.5 * np.dot(error, error)


def gradient_raw(x):
    return (x - TARGET) / (SCALE ** 2)


raw = minimize(
    objective_raw,
    x0=np.array([0.0, 0.0]),
    jac=gradient_raw,
    method='BFGS',
    options={'gtol': 1e-5, 'maxiter': 100},
)

# 缩放坐标:u 的最优值为 [1, 1],两个方向具有相同数量级。
def objective_scaled(u):
    error = u - 1.0
    return 0.5 * np.dot(error, error)


def gradient_scaled(u):
    return u - 1.0


scaled = minimize(
    objective_scaled,
    x0=np.array([0.0, 0.0]),
    jac=gradient_scaled,
    method='BFGS',
    options={'gtol': 1e-5, 'maxiter': 100},
)

x_from_scaled = SCALE * scaled.x
raw_error = np.abs((raw.x - TARGET) / TARGET)
scaled_error = np.abs((x_from_scaled - TARGET) / TARGET)

print(f'raw success: {raw.success}')
print(f'raw iterations: {raw.nit}')
print(f'raw max relative error: {raw_error.max():.3e}')
print(f'scaled success: {scaled.success}')
print(f'scaled iterations: {scaled.nit}')
print(f'scaled max relative error: {scaled_error.max():.3e}')
print(f'scaled physical x: {x_from_scaled}')
预期输出如下。具体迭代次数可能随 SciPy 版本和线搜索细节变化,因此用占位值表示;关键是原始坐标可能显示成功,却仍保留很大的相对误差,而缩放后的解接近真实目标。
raw success: True
raw iterations: <RAW_NIT>
raw max relative error: 1.000e+00
scaled success: True
scaled iterations: <SCALED_NIT>
scaled max relative error: 接近 0
scaled physical x: [1.e+06 1.e-03]这里尤其值得注意:迭代次数更少不一定代表求解得更好。原始问题甚至可能很快停止,只是因为某个方向的梯度天然很小,满足了终止阈值。真正应该比较的是最终目标值、变量误差、梯度以及终止原因。
把缩放做成固定预处理
实际任务中不需要等到优化失败才考虑尺度问题。建模完成后,可以先检查每个变量的典型值、上下界和允许变化范围。如果一个变量通常在百万量级,而另一个只有千分之一量级,就应优先转换为无量纲变量。
缩放因子通常来自变量的典型值、工程基准值或上下界宽度。例如变量典型值是 5000,可以令 x = 5000 * u;有界变量位于 [100, 300] 时,也可以使用中心和平移后的尺度。关键是缩放因子应固定并记录,不能随着每次迭代动态变化,否则优化器看到的目标函数本身也会改变。
用诊断指标确认真的修好了
重新运行后至少检查 success、终止消息、目标值、最大相对变量误差和迭代次数。对于有解析梯度的问题,还可以检查最终梯度范数。若缩放后结果更接近已知最优值,梯度或约束残差达到要求,并且对初值的小幅变化不再异常敏感,就说明尺度修复产生了实际效果。
在真实项目中,推荐把“变量典型数量级是否接近、目标项是否同尺度、约束残差是否同尺度、缩放因子是否被记录”作为求解前检查项。这样做比单纯调大 maxiter 或放宽容差更可靠,因为它处理的是问题几何,而不是掩盖数值症状。