
AI 与工程数学 / 系统课时
根据问题结构选择优化算法
根据问题结构选择优化算法
面对一个新的优化问题,最重要的不是先挑“最快”的算法,而是先确认能否计算导数、目标是否凸、变量规模多大,以及 Hessian 是否可得。本节把这些结构信息整理成一条可执行的选择路径,并解释梯度法、牛顿法、拟牛顿法和无导数方法各自适合什么问题。
学习目标
- 能根据可导性、凸性、维度和 Hessian 条件快速缩小算法范围
- 能区分梯度法、牛顿法、拟牛顿法与无导数方法的主要成本和适用场景
- 能理解“算法能运行”与“能够稳定找到全局最优”之间的区别
先看问题能提供什么信息
算法选择首先取决于你能从目标函数得到什么。设无约束问题为 。如果可以稳定计算梯度 ,就已经具备使用梯度类方法的基础;如果还能得到 Hessian ,则可以进一步考虑牛顿法。
但“能算 Hessian”还不够。一个 维问题的 Hessian 是 矩阵,存储、构造和求解线性方程组的代价都会随维度快速增加。因此,高维问题即使理论上存在 Hessian,也不一定值得显式使用。
凸性回答的是另一个问题:找到一个局部极小点后,能否把它当成全局最优点。 对凸目标,任何局部最优都是全局最优;非凸问题则可能存在多个局部极小点和鞍点,同一个算法从不同初值出发可能得到不同结果。
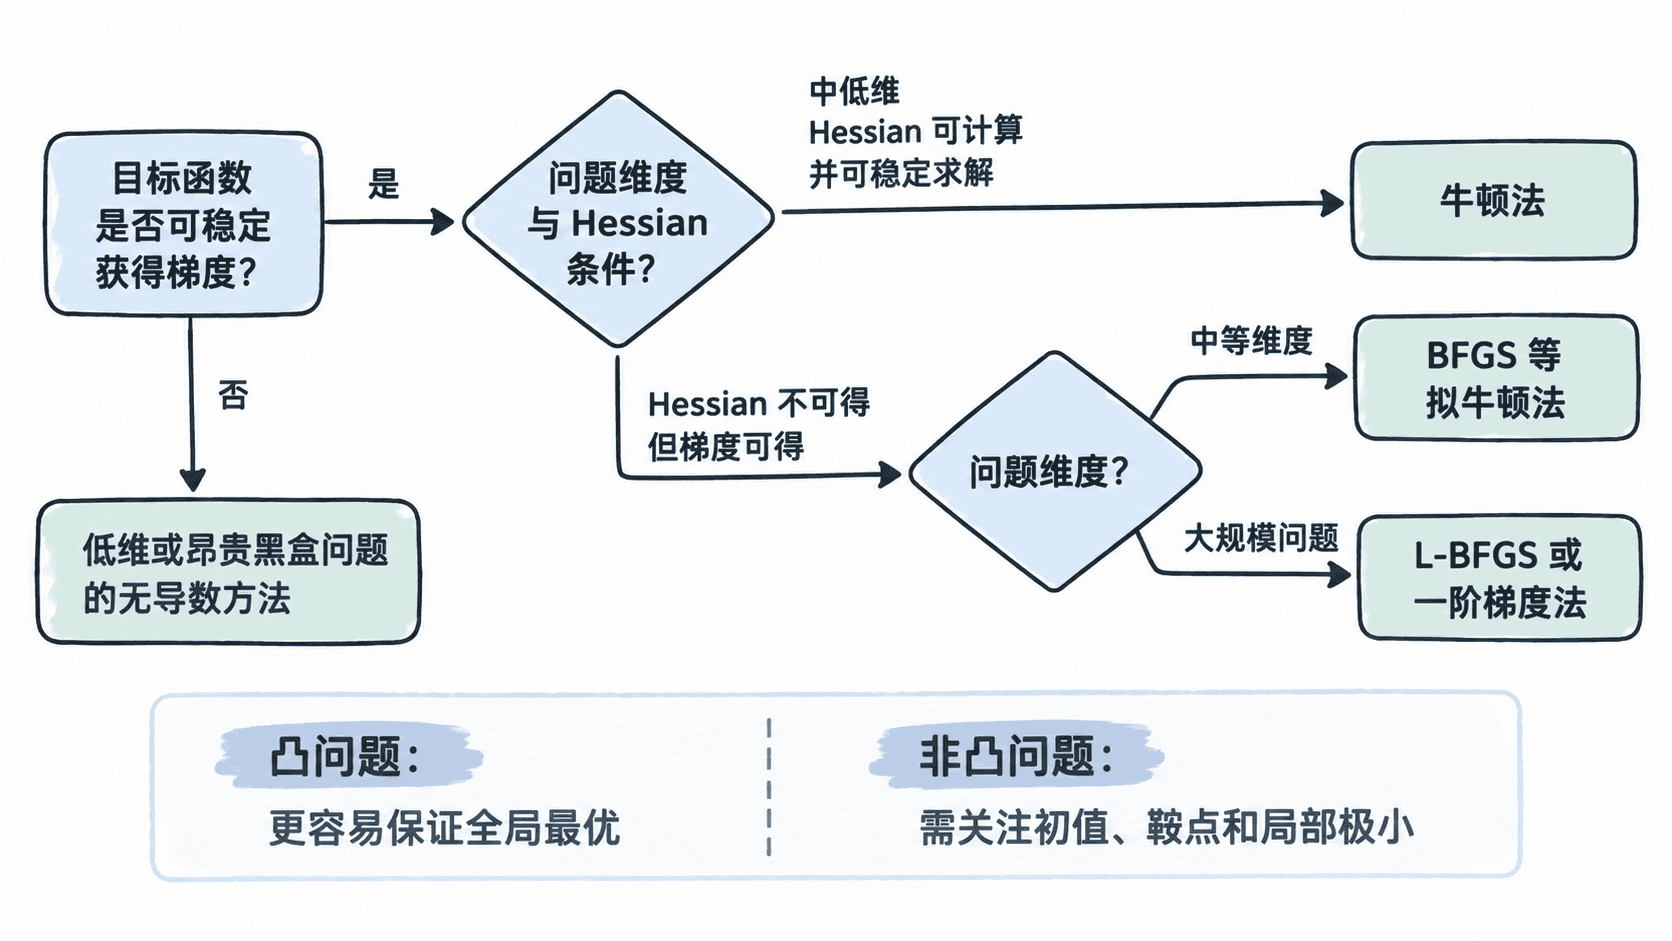
四类方法怎么取舍
梯度法每一步只依赖一阶导数,单步成本低、内存占用小,最适合变量很多的问题。代价是对条件数较差的问题可能收敛很慢,而且步长选择会直接影响稳定性。
牛顿法利用 Hessian 描述局部曲率,通过求解 得到搜索方向。在靠近非退化极小点时通常收敛很快,但每一步需要构造或处理 Hessian,并求解线性方程组,因此更适合中低维且二阶信息可靠的问题。
拟牛顿法不直接计算真实 Hessian,而是根据连续迭代中的梯度变化近似曲率。BFGS 常用于中等规模问题;维度很大时,可以使用只保留少量历史信息的 L-BFGS。它通常比普通梯度法更省迭代次数,又避免了牛顿法完整 Hessian 的高成本。
无导数方法适用于梯度不存在、难以推导、噪声很大,或者目标函数只能通过仿真和外部程序得到的情况。它们不依赖解析梯度,但函数评估次数往往更多,因此在高维问题上通常不占优势。
把判断规则写成可执行检查
下面的程序把常见判断压缩成一个简单选择器。它不是通用优化库,而是把本节的决策原则变成可运行的检查逻辑。
def choose_method(differentiable: bool, dimension: int, hessian_available: bool) -> str:
    # 无法稳定获得梯度时,优先考虑不依赖导数的方法。
    if not differentiable:
        return "derivative-free"

    # Hessian 可得且规模不大时,二阶信息通常值得利用。
    if hessian_available and dimension <= 200:
        return "Newton"

    # 中等规模问题可用 BFGS,大规模问题更适合低内存的一阶或 L-BFGS 方法。
    if dimension <= 5000:
        return "BFGS"
    return "gradient or L-BFGS"


def main() -> None:
    cases = [
        (True, 50, True),
        (True, 1000, False),
        (True, 100000, False),
        (False, 8, False),
    ]

    for case in cases:
        print(case, "->", choose_method(*case))


if __name__ == "__main__":
    main()
预期输出:
(True, 50, True) -> Newton
(True, 1000, False) -> BFGS
(True, 100000, False) -> gradient or L-BFGS
(False, 8, False) -> derivative-free
这些阈值只是用于演示决策逻辑,并不是数学上的固定边界。实际工程中,变量虽然只有几百个,但如果 Hessian 构造一次就需要昂贵仿真,仍然可能更适合拟牛顿法;反过来,具有稀疏 Hessian 的大规模问题也可能高效使用专门的二阶方法。
选择之后还要检查什么
算法确定后,还要检查目标函数的缩放、初始点和停止条件。不同变量量级相差几个数量级时,梯度方向和 Hessian 条件数可能明显恶化,先做尺度归一化往往比盲目更换算法有效。
对非凸问题,不要把一次收敛结果自动当成全局最优。可以使用多个初始点重复求解,并比较最终目标值;若算法在不同初值下频繁落到不同解,应把它视为问题结构的一部分,而不是简单归因于“算法失效”。
实际选择时可以遵循一个稳定顺序:先判断导数是否可靠,再看维度与二阶信息成本,最后用凸性判断结果的可信程度。这样做比根据算法名气或单次基准速度选方法更可靠。