
AI 与工程数学 / 系统课时
比较不同算法的收敛与成本
比较不同算法的收敛与成本
算法比较不能只看“谁先得到答案”。本课在同一个严格凸二次目标上,让梯度下降、BFGS 和牛顿法从相同初值出发,用统一停止条件记录迭代次数、目标函数调用、梯度调用、运行时间和最终误差,再据此判断速度与单步成本的取舍。
学习目标
- 建立公平的优化算法基准,统一目标函数、初值、停止条件和误差定义。
- 运行梯度下降、BFGS 与牛顿法并记录迭代、调用次数、时间和最终误差。
- 区分“迭代次数少”和“总成本低”,避免从单一指标得出算法优劣结论。
先统一比较口径
采用目标函数 ,其中 、。它的解析最优解为 ,因此可以直接计算最终误差 。
三种方法都从 开始,并在梯度范数小于 时停止。梯度下降使用 固定步长;BFGS 用 Armijo 回溯线搜索;牛顿法直接解 Hessian 线性方程。这样既保留各方法常见实现方式,又让停止规则和问题数据完全一致。
运行统一基准
下面脚本只依赖 NumPy。函数调用次数分别统计目标函数和梯度调用;运行时间使用 perf_counter,因此同一机器多次运行也可能略有波动。
import time
import numpy as np

A = np.diag([1.0, 10.0])
b = np.array([1.0, 1.0])
x0 = np.array([10.0, -5.0])
tol = 1e-8
x_star = np.linalg.solve(A, b)

def objective(x):
    return 0.5 * x @ A @ x - b @ x

def grad(x):
    return A @ x - b

def gradient_descent():
    x = x0.copy()
    alpha = 1.0 / np.linalg.eigvalsh(A).max()
    f_calls = g_calls = 0
    for iteration in range(10000):
        fx = objective(x)
        gx = grad(x)
        f_calls += 1
        g_calls += 1
        if np.linalg.norm(gx) < tol:
            break
        x = x - alpha * gx
    return iteration, f_calls, g_calls, x

def bfgs():
    x = x0.copy()
    H = np.eye(2)
    f_calls = 0
    g_calls = 1
    gx = grad(x)

    for iteration in range(100):
        fx = objective(x)
        f_calls += 1
        if np.linalg.norm(gx) < tol:
            break

        p = -H @ gx
        alpha = 1.0
        while objective(x + alpha * p) > fx + 1e-4 * alpha * (gx @ p):
            f_calls += 1
            alpha *= 0.5
        f_calls += 1

        x_new = x + alpha * p
        gx_new = grad(x_new)
        g_calls += 1
        s, y = x_new - x, gx_new - gx
        ys = y @ s

        if ys > 1e-12:
            rho = 1.0 / ys
            I = np.eye(2)
            H = (I - rho * np.outer(s, y)) @ H @ (I - rho * np.outer(y, s)) + rho * np.outer(s, s)

        x, gx = x_new, gx_new

    return iteration, f_calls, g_calls, x

def newton():
    x = x0.copy()
    f_calls = g_calls = 0
    for iteration in range(20):
        objective(x)
        gx = grad(x)
        f_calls += 1
        g_calls += 1
        if np.linalg.norm(gx) < tol:
            break
        x = x - np.linalg.solve(A, gx)
    return iteration, f_calls, g_calls, x

methods = [
    ("gradient-descent", gradient_descent),
    ("bfgs", bfgs),
    ("newton", newton),
]

for name, method in methods:
    start = time.perf_counter()
    iteration, f_calls, g_calls, x = method()
    elapsed_ms = (time.perf_counter() - start) * 1000
    error = np.linalg.norm(x - x_star)
    print(
        f"{name:16s} iter={iteration:3d} f_calls={f_calls:3d} "
        f"g_calls={g_calls:3d} error={error:.3e} time_ms={elapsed_ms:.3f}"
)预期输出如下。<TIME> 表示与机器、负载和 Python 环境有关的动态运行时间,实际值会不同。
gradient-descent iter=196 f_calls=197 g_calls=197 error=9.678e-09 time_ms=<TIME>
bfgs             iter=  5 f_calls= 14 g_calls=  6 error=2.771e-10 time_ms=<TIME>
newton           iter=  1 f_calls=  2 g_calls=  2 error=3.608e-16 time_ms=<TIME>
从数据看收敛与成本
在这个二维二次问题上,牛顿法一步到达数值最优附近,BFGS 只需少量迭代,固定步长梯度下降则要近两百步。原因不是“梯度法差”,而是目标函数两个方向的曲率相差十倍,固定步长必须照顾最陡方向,因此在平缓方向推进较慢。
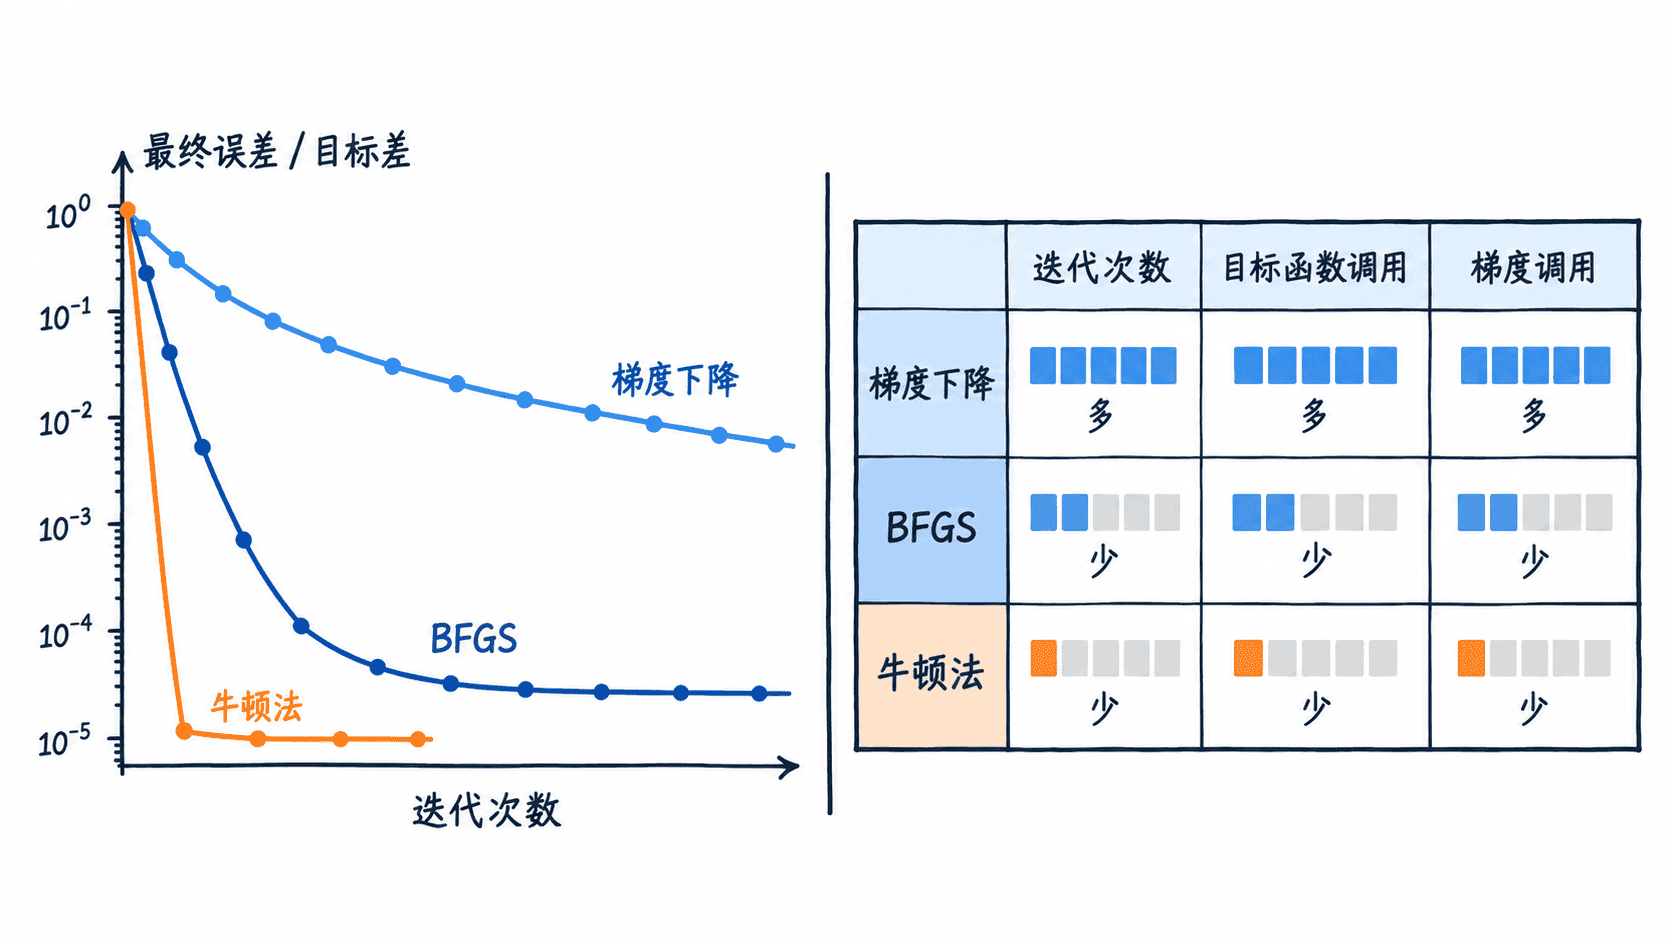
函数调用数进一步说明了成本来源:BFGS 的线搜索会额外评估目标函数,所以它的函数调用明显多于梯度调用;牛顿法在这里 Hessian 就是常量矩阵 ,二阶信息几乎没有额外获取成本。真实问题若 Hessian 构造昂贵或维度很高,牛顿法的单步成本会迅速上升。
怎么形成可靠结论
比较算法时至少同时报告迭代次数、函数与梯度调用次数、墙钟时间和最终误差。若目标函数本身很昂贵,函数调用次数可能比迭代次数更重要;若变量维度很大,则线性代数成本和内存占用也应加入指标。
本实验只能说明三种具体实现对这个二次问题的表现,不能外推为永久排名。更可靠的做法是保持相同数据、初值、容差和硬件环境,在多个代表性问题上重复实验,再看各算法在精度、时间与资源消耗之间是否持续占优。