
AI 与工程数学 / 系统课时
区分局部最优与全局最优
区分局部最优与全局最优
这一节解决一个最常见的误解:优化算法返回了一个“最优解”,并不等于它找到了整个问题的最好答案。你会用函数形状、初始点和简单数值实验,区分局部最优、全局最优与平台区域,并知道什么时候只能说“找到一个好解”。
学习目标
- 能准确区分局部最优、全局最优和平台区域
- 理解非凸问题中初始点为何会改变最终结果
- 能判断“找到候选好解”和“证明全局最优”之间的差别
三种函数形状对应三种搜索体验
对最小化问题来说,局部最优只要求某个点比它附近的点都好;全局最优则要求它不差于整个可行域中的任何点。一个全局最优点一定也是局部最优点,但局部最优点未必是全局最优点。
单峰函数只有一个明显谷底,局部搜索通常比较稳定。多峰函数存在多个谷底,算法可能停在不同位置。平台函数则有一大片区域目标值几乎不变,梯度很小,算法会出现“移动很慢但又没有真正收敛到最佳点”的现象。
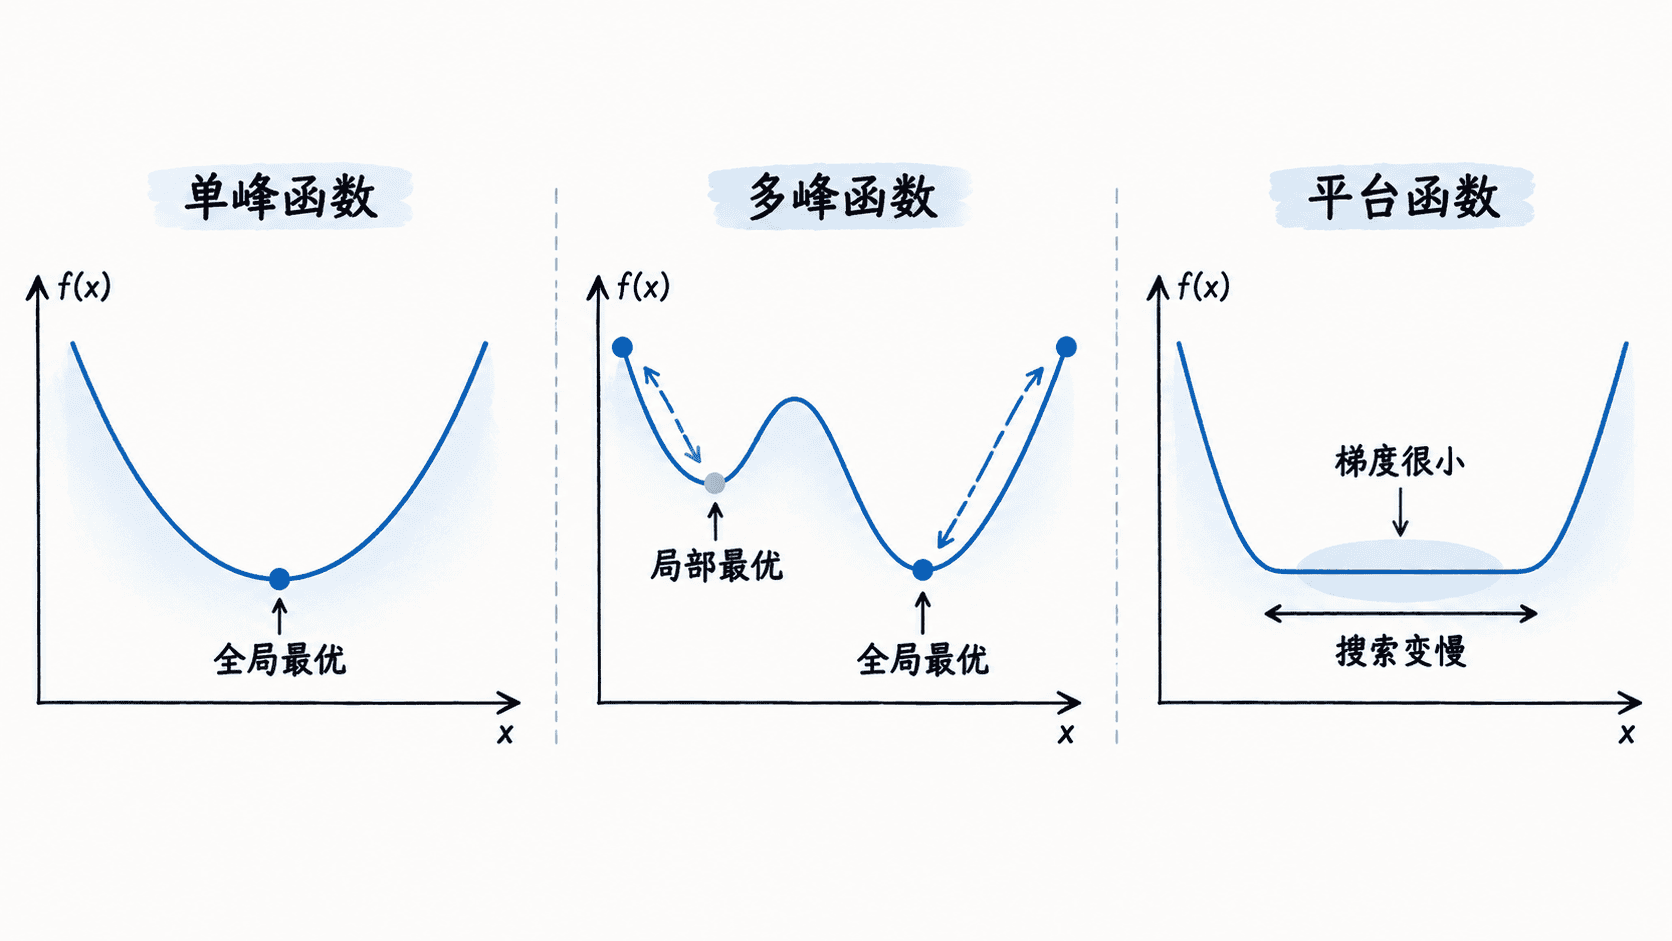
判断时不要只看“算法停止了没有”,而要看停止点与整个搜索空间的关系。局部最优是一个邻域概念,全局最优是一个整体比较概念。
初始点为什么会改变非凸问题的答案
大多数局部优化方法只利用当前位置附近的信息,例如梯度、曲率或邻域函数值。对于非凸函数,不同初始点可能落入不同“吸引域”,于是沿着不同方向进入不同谷底。
下面用一维非凸函数做一个最小实验。函数有左右两个局部极小值,其中左侧谷底更低。
def f(x):
    return (x * x - 1) ** 2 + 0.2 * x

def grad(x):
    return 4 * x * (x * x - 1) + 0.2

def optimize(x0, learning_rate=0.03, steps=5000):
    x = x0
    # 只使用当前位置的梯度,因此结果会受到初始点所在吸引域影响。
    for _ in range(steps):
        x -= learning_rate * grad(x)
    return x, f(x)

if __name__ == "__main__":
    for start in (-2.0, -0.3, 0.3, 2.0):
        x, value = optimize(start)
        print(f"start={start:>4.1f} -> x={x:.4f}, f(x)={value:.4f}")
预期输出:
start=-2.0 -> x=-1.0241, f(x)=-0.2024
start=-0.3 -> x=-1.0241, f(x)=-0.2024
start= 0.3 -> x=0.9740, f(x)=0.1974
start= 2.0 -> x=0.9740, f(x)=0.1974
两个正初始点都收敛到右侧谷底,但它的目标值约为 0.1974;两个负初始点收敛到更低的左侧谷底,目标值约为 -0.2024。算法本身没有“出错”,它只是完成了局部搜索能保证的事情。
找到一个好解不等于证明全局最优
在凸优化中,如果目标函数和可行域满足相应凸性条件,那么任意局部最优都可以视为全局最优,这使“找到”和“证明”往往能够合并。
非凸问题不同。一次梯度下降、牛顿法或其他局部方法返回的通常只是候选解。即使它在附近非常稳定,也不能仅凭“换几个初始点结果一样”就证明不存在更低的谷底。
真正的全局最优证明通常需要额外结构,例如凸性证明、可验证的上下界、分支定界、穷举离散空间,或针对特定问题的全局优化理论。多次随机初始虽然能提高找到好解的概率,却仍属于经验性搜索。
工程中该如何描述优化结果
面对一个非凸问题,先问三个问题:
- 这个问题是否能证明是凸的,或者能转化为凸问题?
- 算法是否只提供局部收敛保证,结果是否依赖初始点?
- 是否有全局下界、对照算法或多次重启结果,可以衡量当前解离“最好”还有多远?
如果只能确认局部收敛,工程报告更准确的表述应是“获得一个稳定的局部最优解”或“在多组初始点中获得当前最佳解”,而不是直接写成“求得全局最优”。